

تحليل المشاعر بالتصنيف الثنائي
يحول هذا القسم النص إلى عدد. يقرأ نموذج تحليل المشاعر (sentiment analysis) مراجعة ويعيد درجة (score) من 0 إلى 1: القيمة القريبة من 0 تعني أن المراجعة سلبية، والقريبة من 1 تعني أنها إيجابية. وسترى أن هذا هو التصنيف الثنائي (binary classification) الذي درسته في الأسبوع 4، مع خطوة جديدة واحدة تسبقه: تحويل الكلمات إلى أعداد باستخدام CountVectorizer. ستحسب درجات المراجعات يدويا من أوزان نموذج حقيقي، ثم تدرب هذا النموذج على 50,000 مراجعة أفلام في دفتر (notebook) الأسبوع 10.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- شرح تحليل المشاعر على أنه تصنيف ثنائي، تكون فيه الدرجة هي احتمال الصنف الإيجابي (positive class).
- وصف ما يفعله
CountVectorizerبالنص: الأحرف الصغيرة (lower case)، والرموز (tokens)، وكلمات التوقف (stop words)، والكلمات المفردة (unigrams) والأزواج (bigrams)، والمفردات (vocabulary)، ومتجه الأعداد (count vector). - حساب درجة المشاعر لمراجعة ما يدويا من الحد الثابت (bias) والأوزان (weights) والدالة السينية (sigmoid) لنموذج انحدار لوجستي (logistic regression) مدرب.
- تدريب نموذج الدفتر وتقييمه: مصفوفة الالتباس (confusion matrix)، والدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، وROC AUC.
- حساب درجات مراجعات جديدة باستخدام
predict_proba، وشرح مواضع خطأ نموذج حقيبة الكلمات (bag of words).
موقع الدرس من المقرر
للأسبوع 10 في الخطة ثلاثة أجزاء:
- الدفتر. يدرب
Sentiment Analysisنموذج انحدار لوجستي على مجموعة بيانات (dataset) من 50,000 مراجعة أفلام، لكل منها تسمية (label) هي0(سلبية) أو1(إيجابية). - سيناريو من الواقع. أعط سلسلة نصية درجة من 0 إلى 1، حيث يمثل 0 المشاعر السلبية ويمثل 1 المشاعر الإيجابية. فمراجعة مطعم مثل "Best meal I've ever had and awesome service, too!" قد تحصل على 0.9 أو أكثر، بينما تحصل عبارة مثل "Long lines and poor customer service" على درجة أقرب إلى 0.
- مرحلة المشروع (project milestone). عروض فرق المشاريع ومناقشاتها (Project Teams Presentations and Discussions).
أنت تعرف مسبقا كل خطوة من خطوات النمذجة: تقسيم البيانات (الأسبوع 3)، والانحدار اللوجستي، والدالة السينية، والعتبة (threshold)، ومنحنى ROC (الأسبوع 4)، وتحويل النص إلى أعداد كلمات باستخدام CountVectorizer (الأسبوع 7). ويجمعها هذا الأسبوع معا على نص حقيقي.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | الفكرة: المشاعر في صورة احتمال | 15 دقيقة |
| 2 | من النص إلى الأعداد باستخدام CountVectorizer | 25 دقيقة |
| 3 | حساب درجة مراجعة يدويا | 20 دقيقة |
| 4 | الدفتر في Colab: التدريب، والتقييم، وحساب الدرجات | 20 دقيقة |
| 5 | حدود النموذج، ومشروعك | 10 دقائق |
| 6 | تمارين مع الإجابات | 30 دقيقة |
الجزء 1: المشاعر في صورة احتمال
ما تحليل المشاعر
يعطي تحليل المشاعر النص درجة من 0 إلى 1. وهو مشكلة تصنيف ثنائي:
| المصطلح | في بيانات هذا الأسبوع |
|---|---|
| العينة | مراجعة واحدة، أي سلسلة نصية |
التسمية y | 0 سلبية، 1 إيجابية |
الخصائص (features) x | أعداد الكلمات في المراجعة (الجزء 2) |
| النموذج | LogisticRegression |
| درجة المشاعر | p، احتمال أن تكون التسمية 1 |
بعد تدريب النموذج، يكفي لحساب درجة نص ما أن نمرره إلى النموذج ونطلب احتمال أن تكون التسمية 1. فالاحتمال 0.8 يعني درجة مشاعر 0.8: النص إيجابي إلى حد كبير. وتستخدم فرق التسويق مثل هذه النماذج لمتابعة وسائل التواصل الاجتماعي، لتتصرف بسرعة حين تتحول التعليقات عن شركتها فجأة إلى السلبية.
خط المعالجة
- التحويل إلى متجه. يحول
CountVectorizerالمراجعة إلى صف من أعداد الكلمات. - حساب z. يحسب نموذج الانحدار اللوجستي
zمن الأعداد وأوزانه. - الضغط. تحول الدالة السينية
zإلىpبين 0 و1. - القرار. مع العتبة 0.5، تعني
p ≥ 0.5أن المراجعة إيجابية.
الخطوات من 2 إلى 4 هي الأسبوع 4 تماما. والخطوة الجديدة الوحيدة هي الأولى.
الجزء 2: من النص إلى الأعداد باستخدام CountVectorizer
لماذا نحول النص إلى متجهات
لا يستطيع نموذج تعلم الآلة أن يعمل على النص؛ فهو يحتاج إلى أعداد. وأبسط طريقة لتحويل النص إلى أعداد هي حقيبة الكلمات: احتفظ بقائمة من الكلمات المعروفة (المفردات)، وعبر عن كل نص بعدد مرات ظهور كل كلمة من القائمة فيه. ويهمل ترتيب الكلمات، ولهذا تسمى حقيبة.
ما يفعله CountVectorizer بالنص
يستخدم الدفتر المحول (vectorizer) الآتي:
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(ngram_range=(1, 2), stop_words='english', min_df=20)
x = vectorizer.fit_transform(df['Text'])
y = df['Sentiment']
لكل نص، وبهذا الترتيب:
- الأحرف الصغيرة. تصبح
pOOrهيpoor. - الرموز. كل سلسلة من حرفين أو أكثر من الحروف أو الأرقام أو الشرطات السفلية رمز. وعلامات الترقيم تفصل بين الرموز وتختفي، والقطع المكونة من حرف واحد تحذف: فلا تعطي
I'veإلاve. - كلمات التوقف. تحذف
stop_words='english'قائمة مدمجة من 318 كلمة إنجليزية شائعة جدا مثلtheوandوmeوoff، ومنها أيضاnotوvery. - السلاسل المتتالية (n-grams). تحتفظ
ngram_range=(1, 2)بكل كلمة وحدها (الكلمات المفردة)، وبكل زوج من الكلمات المتجاورة يبقى بعد الحذف (الأزواج)، مثلcustomer service. - المفردات. أثناء
fitلا تبقيmin_df=20إلا الكلمات المفردة والأزواج التي تظهر في 20 مراجعة على الأقل. ويهمل كل ما عدا ذلك، أثناء التدريب ولاحقا على النصوص الجديدة. - العد. يصبح كل نص صفا واحدا فيه عمود لكل مدخل في المفردات، وتحمل كل خلية عددا.
تتعلم fit_transform المفردات من المراجعات وتعيد مصفوفة الأعداد. وعلى النص الجديد تستدعي transform، التي تستخدم المفردات التي تعلمها المحول أثناء fit ولا تضيف كلمات جديدة أبدا.
مثال محلول: ما يبقيه المحول
يمرر الدفتر جملة فوضوية عن قصد عبر المحول بعد ملاءمته، ثم يعكس التحويل ليرى مدخلات المفردات التي وجدت فيها:
text = vectorizer.transform(['The long l3ines   and; pOOr customer# service really turned me off...123.'])
text = vectorizer.inverse_transform(text)
print(text)
قبل أن تكمل القراءة، توقع الكلمات التي ستبقى.
الخطوة 1: الأحرف الصغيرة والرموز. يصبح النص 12 رمزا:
the, long, l3ines, and, poor, customer, service, really, turned, me, off, 123l3ines رمز واحد، لأن الرقم يعد من حروف الكلمة. و123 رمز أيضا.
الخطوة 2: حذف كلمات التوقف. the وand وme وoff كلمات توقف، فتبقى 8 رموز:
long, l3ines, poor, customer, service, really, turned, 123الخطوة 3: إضافة الأزواج. من الرموز الـ8 تتكون 7 أزواج متجاورة، فيصبح المجموع 15 مرشحا:
long l3ines, l3ines poor, poor customer, customer service,
service really, really turned, turned 123
الخطوة 4: الإبقاء على ما في المفردات. في المفردات 33,752 مدخلا. وليس فيها l3ines ولا 123، ولا أي زوج من الأزواج الـ7. والناتج هو:
[array(['customer', 'long', 'poor', 'really', 'service', 'turned'],
      dtype='<U25')]
تبقى ست خصائص. وتعرضها inverse_transform بترتيب أبجدي، لا بترتيب ورودها في الجملة.
مثال محلول: ثلاث مراجعات في صورة مصفوفة أعداد
لترى المصفوفة نفسها، حول ثلاث مراجعات قصيرة إلى متجهات، بالكلمات المفردة وحدها:
import pandas as pd
from sklearn.feature_extraction.text import CountVectorizer

reviews = ['Long lines and poor customer service',
           "Best meal I've ever had and awesome service, too!",
           'Awesome meal, awesome service']
vec = CountVectorizer(stop_words='english')
x = vec.fit_transform(reviews)
print(pd.DataFrame(x.toarray(), columns=vec.get_feature_names_out()))
توقع الأعمدة أولا: أي كلمات المراجعات الثلاث كلمات توقف؟
   awesome  best  customer  lines  long  meal  poor  service  ve
0        0     0         1      1     1     0     1        1   0
1        1     1         0      0     0     1     0        1   1
2 2 0 0 0 0 1 0 1 0andوeverوhadوtooكلمات توقف، وIأقصر من أن تكون رمزا.- المفردات مرتبة أبجديا: 9 أعمدة.
- تحتوي المراجعة 2 على
awesomeمرتين، لذا تحمل خليتها 2: فالمحول يعد، ولا يكتفي بتسجيل الوجود. - مع
ngram_range=(1, 2)تعطي المراجعات الثلاث نفسها 19 عمودا، لأن 10 أزواج تنضم إلى الكلمات الـ9.
مصفوفة متفرقة
على مجموعة البيانات كاملة يحتوي x على 49,581 صفا و33,752 عمودا، أي نحو 1.67 مليار خلية. ولا يختلف عن الصفر منها إلا 4,951,741 خلية، أي 0.30 في المئة. لذا تعيد fit_transform مصفوفة متفرقة (sparse matrix) لا تخزن إلا الخلايا غير الصفرية، ويقبلها LogisticRegression مباشرة.
الجزء 3: حساب درجة مراجعة يدويا
معادلة الأسبوع 4
لمراجعة أعدادها x_1, ..., x_n:
z = b + w_1·x_1 + w_2·x_2 + ... + w_n·x_n
p = σ(z) = 1 / (1 + e^(-z))bهو الحد الثابت،model.intercept_. وفي النموذج المدربb = -0.0488.w_iهو وزن مدخل المفرداتi، منmodel.coef_.x_iهو عدد مرات ظهور المدخلiفي المراجعة. ومعظم قيمx_iتساوي 0، لذا لا يضيف شيئا إلا المدخلات الموجودة في المراجعة.σهي الدالة السينية، وeهو الثابت 2.71828. تذكر أنσ(0) = 0.5، لذا تكونp ≥ 0.5عندما تكونz ≥ 0، وعندها فقط.
الوزن الموجب يدفع الدرجة نحو الإيجابية، والوزن السالب يدفعها نحو السلبية. والمراجعة التي لا تحتوي على أي كلمة معروفة تحصل على p = σ(-0.0488) = 0.4878.
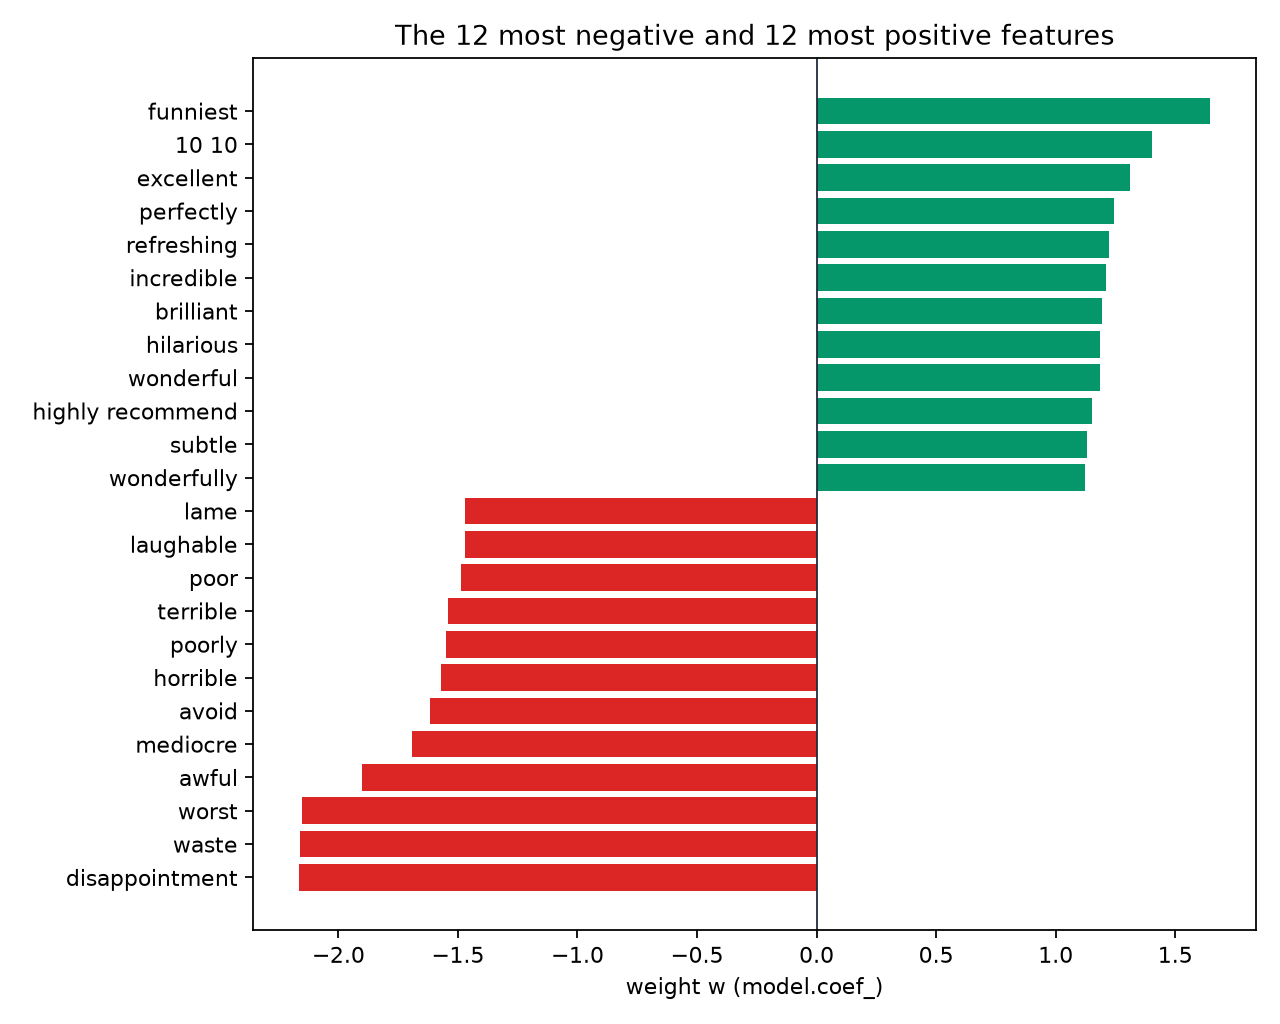
أدنى الأوزان أوزان disappointment (-2.1646) وwaste (-2.1606) وworst (-2.1519)؛ وأعلاها أوزان funniest (1.6471)، والزوج 10 10 (1.4037، كما في تقييم "10/10")، وexcellent (1.3094).
مثال محلول: Long lines and poor customer service
المراجعة السلبية في السيناريو هي Long lines and poor customer service. احسب درجتها بالنموذج المدرب. الأوزان مقربة إلى 4 منازل عشرية.
الخطوة 1: ما الخصائص التي يراها النموذج؟
توقع أولا: أي كلمة هي كلمة توقف، وهل يبقى أي زوج؟
and كلمة توقف. والكلمات الخمس المتبقية كلها في المفردات، أما الأزواج الأربعة (long lines وlines poor وpoor customer وcustomer service) فليست فيها. وكل كلمة تظهر مرة واحدة، لذا كل x تساوي 1:
| الخاصية | x | الوزن w | w·x |
|---|---|---|---|
| customer | 1 | -0.1980 | -0.1980 |
| lines | 1 | -0.1184 | -0.1184 |
| long | 1 | -0.0284 | -0.0284 |
| poor | 1 | -1.4874 | -1.4874 |
| service | 1 | -0.4832 | -0.4832 |
الخطوة 2: حساب z
Σ w·x = -0.1980 - 0.1184 - 0.0284 - 1.4874 - 0.4832 = -2.3154
z = -0.0488 + (-2.3154) = -2.3642
كل الأوزان سالبة، وpoor وحدها تعطي نحو ثلثي المجموع.
الخطوة 3: الدالة السينية والقرار
e^(2.3642) = 10.6355
p = 1 / (1 + 10.6355) = 0.0859
p = 0.0859 أقل من 0.5، لذا يتنبأ النموذج بأنها سلبية. وتعطي predict_proba في الدفتر 0.08594: قريبة من 0، كما يقول السيناريو.
مثال محلول: Best meal I've ever had
المراجعة الإيجابية في السيناريو هي Best meal I've ever had and awesome service, too! وتقول الخطة إنها "قد تحصل على 0.9 أو أكثر". توقع: هل يتفق هذا النموذج معها؟
الخطوة 1: الخصائص
I أقصر من اللازم، وever وhad وand وtoo كلمات توقف. تبقى خمس كلمات، ولا يوجد أي زوج منها في المفردات:
| الخاصية | x | الوزن w | w·x |
|---|---|---|---|
| awesome | 1 | 0.7310 | 0.7310 |
| best | 1 | 0.7090 | 0.7090 |
| meal | 1 | 0.0062 | 0.0062 |
| service | 1 | -0.4832 | -0.4832 |
| ve | 1 | -0.0820 | -0.0820 |
الخطوة 2: قيمتا z وp
Σ w·x = 0.7310 + 0.7090 + 0.0062 - 0.4832 - 0.0820 = 0.8810
z = -0.0488 + 0.8810 = 0.8322
e^(-0.8322) = 0.4351
p = 1 / (1 + 0.4351) = 0.6968
يتنبأ النموذج بأنها إيجابية، لكن الدرجة 0.6968، لا 0.9. وتعطي predict_proba القيمة نفسها 0.69682.
لماذا ليست 0.9؟
- تعلم النموذج من مراجعات الأفلام. وفي مراجعات الأفلام
serviceكلمة سلبية (-0.4832)، فتسحب مراجعة المطعم هذه إلى الأسفل. - في النصوص القصيرة خصائص قليلة، لذا يبقى المجموع
Σ w·xصغيرا وتبقىpقرب المنتصف. - الرقم 0.9 في الخطة يصف معنى درجة المشاعر؛ أما الرقم الفعلي فيعتمد دائما على البيانات التي تدرب عليها النموذج.
افتح مقياس المشاعر بملء الشاشة. اكتب أي مراجعة، أو اختر أحد الأمثلة، واضغط تشغيل لتضاف الكلمات واحدة بعد أخرى: تظهر كلمات التوقف مشطوبة، والكلمات التي ليست في المفردات بإطار متقطع، وتلون كل كلمة معروفة النص بحسب وزنها بينما يتحرك المؤشر.
الجزء 4: الدفتر في Colab
افتح الدفتر
افتح Sentiment Analysis في Colab
يحتاج الدفتر إلى ثلاثة تغييرات صغيرة ليعمل في Colab اليوم:
- يقرأ
Data/reviews.csvمن مجلد غير موجود بجانب الدفتر في Colab. اقرأ الملف من المستودع بدلا من ذلك (نحو 65 ميغابايت). - يستدعي
plot_confusion_matrix، التي حذفت من scikit-learn. استخدمConfusionMatrixDisplay.from_estimator. - يحفظ النموذج في
Data/. احفظه في المجلد الحالي بدلا من ذلك.
تحميل البيانات وحذف التكرارات
import pandas as pd

url = ("https://raw.githubusercontent.com/"
       "jeffprosise/Machine-Learning/master/Data/reviews.csv")
df = pd.read_csv(url, encoding="ISO-8859-1")
df.info()
df.groupby('Sentiment').describe()- يبين
df.info()وجود 50,000 صف وعمودين،TextوSentiment، بلا قيم مفقودة. - يبين
describe()وجود 25,000 مراجعة من كل صنف، لكن لا يوجد إلا 24,697 نصا سلبيا فريدا و24,884 نصا إيجابيا فريدا.
df = df.drop_duplicates()
df.groupby('Sentiment').describe()
بعد drop_duplicates() تبقى 49,581 مراجعة: 24,697 سلبية و24,884 إيجابية. فقد حذفت 303 نسخ سلبية مكررة و116 نسخة إيجابية مكررة، أي 419 صفا في المجموع. ولا يزال الصنفان متوازنين تقريبا.
التحويل إلى متجهات والتقسيم
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(ngram_range=(1, 2), stop_words='english', min_df=20)
x = vectorizer.fit_transform(df['Text'])
y = df['Sentiment']

from sklearn.model_selection import train_test_split

x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.5, random_state=0)x.shapeهو(49581, 33752): اجتاز شرطmin_df=20منها 17,528 كلمة مفردة و16,224 زوجا.- يقسم الدفتر البيانات بنسبة 50/50 لأن مجموعة البيانات كبيرة: 24,790 مراجعة للتدريب و24,791 مراجعة للاختبار (12,422 إيجابية و12,369 سلبية).
تدريب النموذج
from sklearn.linear_model import LogisticRegression

model = LogisticRegression(max_iter=1000, random_state=0)
model.fit(x_train, y_train)
تتعلم fit وزنا واحدا لكل مدخل في المفردات، أي 33,752 وزنا، إضافة إلى الحد الثابت b. وتعطي max_iter=1000 خوارزمية الحل (solver) ما يكفي من التكرارات لتتقارب رغم هذا العدد الكبير من الخصائص؛ واحتاج تشغيلنا إلى 78 تكرارا.
مصفوفة الالتباس
from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_estimator(model, x_test, y_test,
    display_labels=['Negative', 'Positive'], cmap='Blues', xticks_rotation='vertical')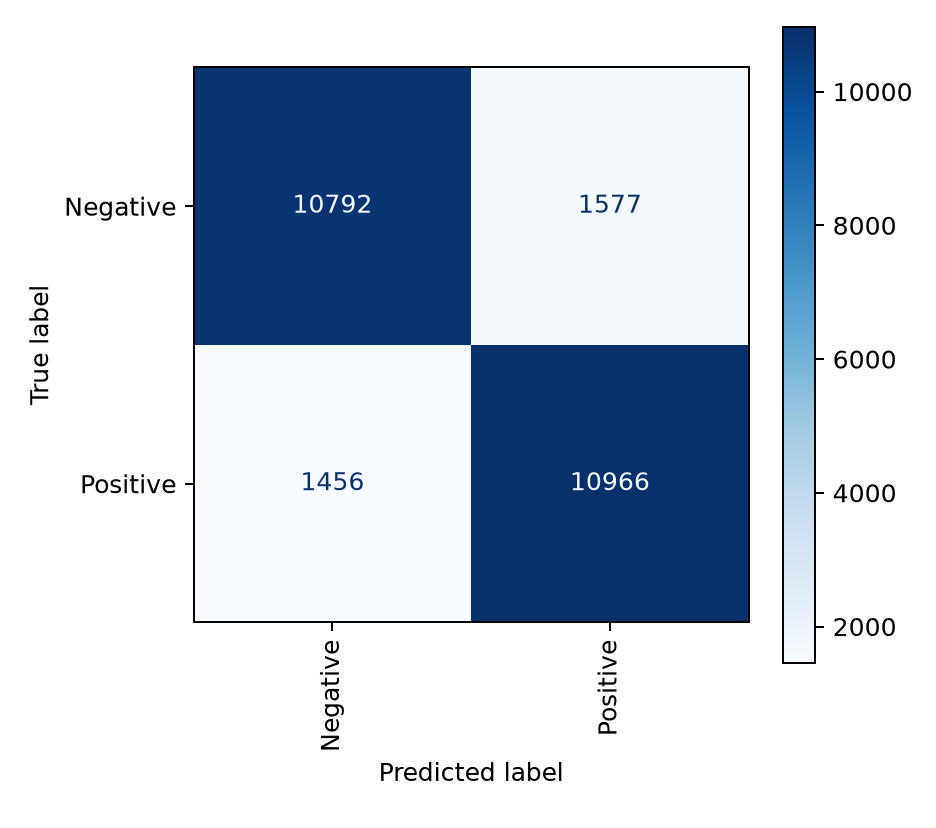
| التنبؤ: سلبية | التنبؤ: إيجابية | |
|---|---|---|
| سلبية فعلا | 10,792 | 1,577 |
| إيجابية فعلا | 1,456 | 10,966 |
صنف النموذج 10,792 مراجعة سلبية تصنيفا صحيحا وأخطأ في 1,577 منها؛ وصنف 10,966 مراجعة إيجابية تصنيفا صحيحا وأخطأ في 1,456.
يعرض الدفتر المحفوظ 10,795 و1,574 في الصف الأول، وتختلف بعض أرقامه المطبوعة في المنزلة العشرية الثالثة أو الرابعة. فقد شغل ذلك الدفتر بإصدار أقدم من scikit-learn؛ وكل رقم في هذه الصفحة مأخوذ من تشغيلنا نحن بالإصدار 1.9.1 من scikit-learn، وقد تختلف أرقامك في Colab أيضا ببضع مراجعات.
مثال محلول: تقييم النموذج
احسب من المصفوفة الدقة A، والضبط P والاستدعاء R للصنف الإيجابي. حاول قبل أن تكمل القراءة.
A = (10792 + 10966) / 24791 = 21758 / 24791 = 0.8777
P = 10966 / (10966 + 1577) = 10966 / 12543 = 0.8743
R = 10966 / (10966 + 1456) = 10966 / 12422 = 0.8828
تطبع model.score(x_test, y_test) القيمة 0.8776572143116453، وهي الدقة نفسها. فنحو 88 من كل 100 مراجعة اختبار تصنف تصنيفا صحيحا.
ROC AUC
يطلب الدفتر بعد ذلك مقياسا أفضل من الدقة:
from sklearn.metrics import roc_auc_score

probabilities = model.predict_proba(x_test)
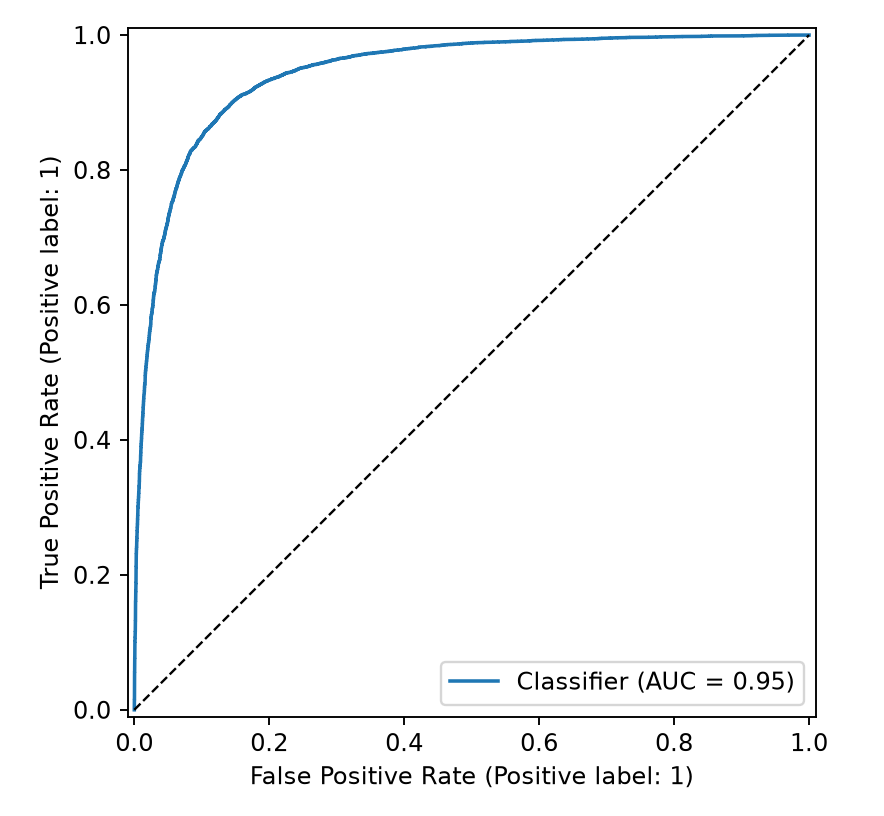
roc_auc_score(y_test, probabilities[:, 1])
الناتج 0.9451676789628598. تحكم الدقة على التنبؤات عند عتبة واحدة، هي 0.5. أما المساحة تحت منحنى ROC (area under the ROC curve) فتحكم على الدرجات عند كل العتبات: 1.0 تعني نموذجا مثاليا و0.5 تعني التخمين. ولها أيضا معنى مباشر: خذ مراجعة إيجابية عشوائية ومراجعة سلبية عشوائية؛ يعطي النموذج الإيجابية منهما الدرجة الأعلى في نحو 94.5 في المئة من هذه الأزواج.
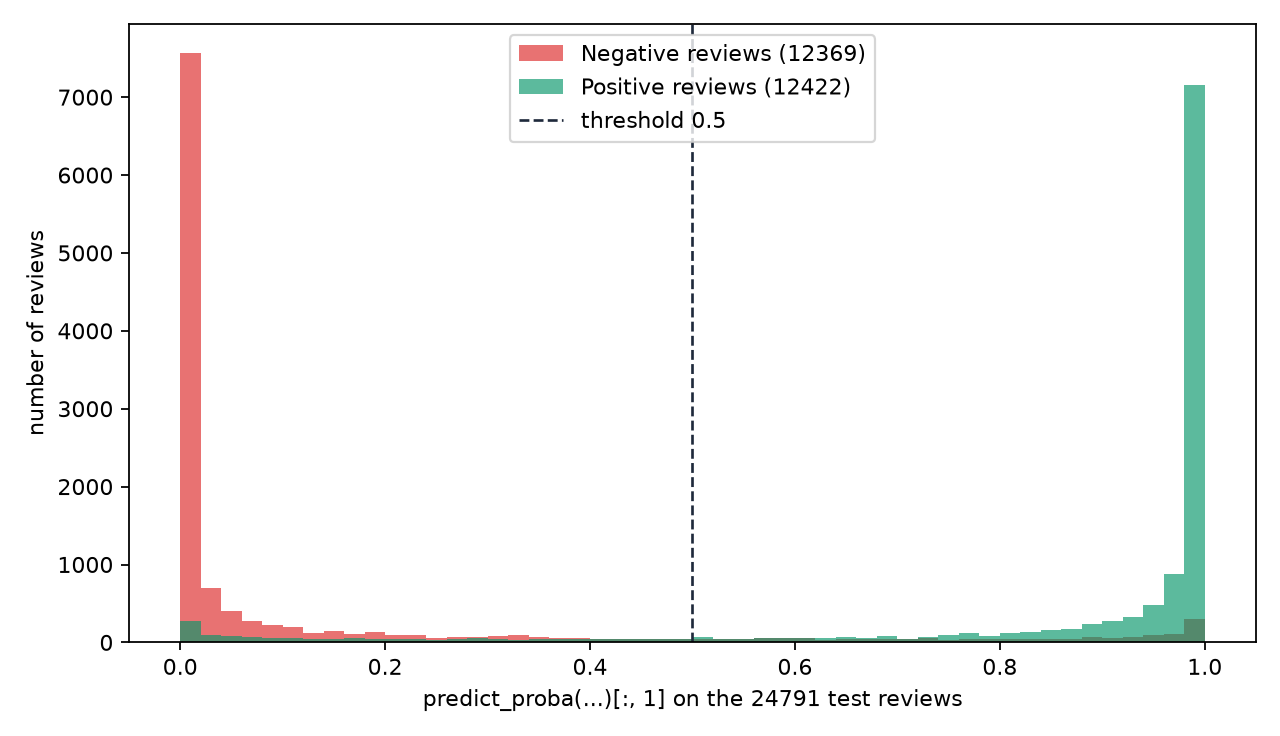
الدرجات منفصلة جيدا. فمعظم مراجعات الاختبار تحصل على درجة قريبة من 0 أو قريبة من 1، ولا يقع بين 0.4 و0.6 إلا 3.9 في المئة منها:
تحريك العتبة يبادل الضبط بالاستدعاء، كما في الأسبوع 4:
| العتبة t | TN, FP, FN, TP | الدقة | الضبط (الإيجابية) | الاستدعاء (الإيجابية) |
|---|---|---|---|---|
| 0.3 | 10232, 2137, 1028, 11394 | 0.8723 | 0.8421 | 0.9172 |
| 0.5 | 10792, 1577, 1456, 10966 | 0.8777 | 0.8743 | 0.8828 |
| 0.7 | 11251, 1118, 2054, 10368 | 0.8721 | 0.9027 | 0.8346 |
افتح أداة العتبة ومنحنى ROC بملء الشاشة. اسحب العتبة عبر المدرج التكراري لدرجات الاختبار، وراقب مصفوفة الالتباس والنقطة على منحنى ROC تتحركان معا، واضغط مسح العتبات لترسم المنحنى كله.
حساب درجات مراجعات جديدة
reviews = ['Long lines and poor customer service',
           "Best meal I've ever had and awesome service, too!"]
model.predict_proba(vectorizer.transform(reviews))[:, 1]
[0.08594148 0.69681757]هاتان هما مراجعتا المثالين المحلولين. استدع دائما transform على النص الجديد، ولا تستدع fit_transform أبدا: فالنموذج لا يعرف إلا المفردات التي تدرب عليها. ويحسب الدفتر درجتي مراجعتين أخريين:
| المراجعة | الدرجة p |
|---|---|
| The long lines and poor customer service really turned me off. | 0.0915 |
| One of the more delightful experiences I have had! | 0.7025 |
في الثانية تحذف one وof وthe وmore وI وhave وhad كلها؛ ولا يبقى ليحسم الأمر إلا delightful (0.8111) وexperiences (0.0968).
حفظ النموذج
import pickle

pickle.dump(model, open('sentiment.pkl', 'wb'))
pickle.dump(vectorizer.vocabulary_, open('vocabulary.pkl', 'wb'))
يحفظ الدفتر النموذج المدرب والمفردات، ليتمكن تطبيق ما من تحميلهما وحساب درجات النصوص دون تدريب من جديد. وحفظ المفردات مهم: فبدونها لا يمكن تحويل النص الجديد إلى الأعمدة الـ33,752 نفسها.
الجزء 5: أين تخطئ حقيبة الكلمات
دقة النموذج 88 في المئة على مراجعات الأفلام، ومع ذلك يسهل خداعه. جرب هذه الأمثلة في مقياس المشاعر.
النفي يضيع
not في قائمة كلمات التوقف الإنجليزية، لذا تحذف قبل أن يرى النموذج النص:
| المراجعة | الخصائص | الدرجة p |
|---|---|---|
| The food was good | food, good | 0.5885 |
| The food was not good | food, good | 0.5885 |
تصبح المراجعتان متجه الأعداد نفسه، فتحصلان على الدرجة نفسها.
ترتيب الكلمات يضيع
| المراجعة | الدرجة p |
|---|---|
| Great food but terrible service | 0.2591 |
| Terrible food but great service | 0.2591 |
لا تفعل حقيبة الكلمات إلا العد، لذا فالمراجعتان متطابقتان في نظر النموذج. وليس أي من أزواجهما (great food وterrible service و...) في المفردات، لذا لا تستطيع حتى الأزواج أن تساعد.
بيانات التدريب تحدد الأوزان
تعلم النموذج من مراجعات الأفلام. فتحمل service (-0.4832) وstaff (-0.4587) أوزانا سالبة، بينما لا يتجاوز وزن rude القيمة -0.0364. وستحصل شركة مطاعم على درجات أفضل إذا دربت النموذج على مراجعات مطاعم ذات تسمية، بالشيفرة نفسها تماما.
الأخطاء الشائعة
- قراءة
Data/reviews.csvفي Colab من مجلد غير موجود هناك. - استدعاء
plot_confusion_matrix: فقد حذفت؛ استخدمConfusionMatrixDisplay.from_estimator. - استدعاء
fit_transformعلى المراجعات الجديدة. فالنص الجديد يحتاج إلىvectorizer.transform([...])بالمفردات التي تعلمها المحول من نصوص التدريب. - تمرير سلسلة نصية مفردة إلى
transform. فهي تحتاج إلى قائمة من النصوص:transform([review]). - قراءة
predict_proba(...)[0][0]على أنها درجة المشاعر. العمود1هو احتمال الإيجابية:[0][1]، أو[:, 1]لمراجعات كثيرة. - توقع أن تقلب
notالدرجة بينما تحذفهاstop_words='english'.
مرحلة المشروع: العروض والمناقشات
مرحلة هذا الأسبوع هي عروض فرق المشاريع ومناقشاتها: يعرض كل فريق مشروعه ويناقشه. والأسبوع القادم هو موعد التسليم النهائي، الذي تحدده الخطة كما يلي:
- شيفرة المشروع في مستودع على GitHub.
- فيديو للمشروع مدته 5 دقائق.
- مقترح المشروع.
- العرض التقديمي للمشروع.
- شعار المشروع.
- إضافة إلى ذلك، واجهة مستخدم للمشروع (للهاتف المحمول أو الويب أو سطح المكتب).
إذا كان مشروعك يعمل على نصوص، فخط المعالجة الذي درسناه اليوم ينطبق مباشرة: حول النص إلى متجهات باستخدام CountVectorizer، ودرب مصنفا، واحسب الدرجات باستخدام predict_proba، واحفظ النموذج والمفردات كليهما.
الخلاصة
- تحليل المشاعر تصنيف ثنائي: الدرجة هي
p، احتمال الصنف الإيجابي. - يحول
CountVectorizerالنص إلى أعداد: أحرف صغيرة، ورموز، وحذف كلمات التوقف، وكلمات مفردة وأزواج، والإبقاء على المفردات وحدها. - الدرجة هي
σ(b + Σ w·x): كل كلمة معروفة تدفع بمقدار وزنها، والكلمات غير المعروفة وكلمات التوقف لا تفعل شيئا. - تبلغ دقة نموذج الدفتر 0.8777 وقيمة ROC AUC لديه 0.9452 على 24,791 مراجعة اختبار.
- تهمل حقيبة الكلمات الترتيب، ومع حذف كلمات التوقف تهمل النفي أيضا؛ وتعكس الأوزان البيانات التي تدرب عليها النموذج.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: التحويل إلى متجه يدويا (نحو 5 دقائق)
المراجعة: The waiter was rude and the food was cold.
- اكتب الرموز بعد التحويل إلى الأحرف الصغيرة.
- احذف كلمات التوقف (
theوwasوandكلمات توقف). - اكتب كل كلمة مفردة وكل زوج تبنيه
ngram_range=(1, 2).
التمرين 2: حساب درجتي مراجعتين يدويا (نحو 10 دقائق)
استخدم b = -0.0488 وهذه الأوزان من النموذج المدرب. لكل مراجعة، احسب Σ w·x وz وp والتنبؤ عند العتبة 0.5.
| الخاصية | الوزن w |
|---|---|
| waiter | -0.0937 |
| rude | -0.0364 |
| food | 0.2302 |
| cold | -0.2052 |
| excellent | 1.3094 |
| friendly | 0.1913 |
| staff | -0.4587 |
| highly | 0.6243 |
| recommend | 0.3000 |
| highly recommend | 1.1524 |
- The waiter was rude and the food was cold. لا توجد في المفردات إلا الكلمات المفردة الأربع.
- Excellent food, friendly staff, highly recommend! الكلمات الست كلها في المفردات، وكذلك زوج واحد.
التمرين 3: اختيار عتبة (نحو 5 دقائق)
تريد سلسلة مطاعم أن تجد أكبر عدد ممكن من المراجعات السلبية ليرد مدير على كل منها. هذه نتائج النموذج على مراجعات الاختبار الـ24,791:
| العتبة t | TN | FP | FN | TP |
|---|---|---|---|---|
| 0.3 | 10232 | 2137 | 1028 | 11394 |
| 0.7 | 11251 | 1118 | 2054 | 10368 |
- لكل عتبة، احسب استدعاء الصنف السلبي،
TN / (TN + FP). - أي العتبتين تجد مراجعات سلبية أكثر؟ وما الثمن الذي تدفعه السلسلة مقابل ذلك؟
التمرين 4: في Colab (نحو 10 دقائق)
- شغل الدفتر مع التغييرات الثلاثة، واحسب درجتي مراجعتي السيناريو باستدعاء واحد لـ
predict_proba. - احسب درجتي
The food was goodوThe food was not good. - ابن محولا ثانيا يبقي كلمات التوقف:
CountVectorizer(ngram_range=(1, 2), min_df=20). أعد الملاءمة، وقسم البيانات بالقيمة نفسهاrandom_state=0، وأعد التدريب، واطبع عدد الخصائص والدقة وقيمة ROC AUC. - احسب درجتي مراجعتي الطعام مرة أخرى بالنموذج الجديد. ما الذي تغير، ولماذا؟
الإجابات
الإجابة 1
- الرموز:
the, waiter, was, rude, and, the, food, was, cold. وتختفي النقطة في آخر الجملة. - بعد حذف كلمات التوقف:
waiter, rude, food, cold. - الكلمات المفردة والأزواج، وعددها 7:
waiter, rude, food, cold, waiter rude, rude food, food cold. ولا يوجد الزوجrude foodإلا لأن كلمات التوقف التي بين الكلمتين حذفت أولا.
الإجابة 2
المراجعة 1: The waiter was rude and the food was cold.
Σ w·x = -0.0937 - 0.0364 + 0.2302 - 0.2052 = -0.1051
z = -0.0488 + (-0.1051) = -0.1539
e^(0.1539) = 1.1664
p = 1 / (1 + 1.1664) = 0.4616
p أقل من 0.5، لذا يتنبأ النموذج بأنها سلبية، ولكن بفارق ضئيل. فـrude سلبية بالكاد في مراجعات الأفلام، ووزن food موجب. وتعطي predict_proba القيمة 0.4616 أيضا.
المراجعة 2: Excellent food, friendly staff, highly recommend!
Σ w·x = 1.3094 + 0.2302 + 0.1913 - 0.4587 + 0.6243 + 0.3000 + 1.1524 = 3.3489
z = -0.0488 + 3.3489 = 3.3001
e^(-3.3001) = 0.0369
p = 1 / (1 + 0.0369) = 0.9644
يتنبأ النموذج بأنها إيجابية مع p = 0.9644. ويحسب الزوج highly recommend (1.1524) إضافة إلى highly وrecommend. وتعطي predict_proba القيمة 0.9644.
الإجابة 3
- t = 0.3:
10232 / (10232 + 2137) = 10232 / 12369 = 0.8272. - t = 0.7:
11251 / (11251 + 1118) = 11251 / 12369 = 0.9096.
العتبة الأعلى، 0.7، تجد مراجعات سلبية أكثر: فالمراجعة لا توصف بأنها إيجابية إلا عندما تكون p ≥ 0.7، لذا توصف مراجعات أكثر بأنها سلبية. والثمن أن مراجعات إيجابية أكثر توصف بأنها سلبية أيضا: يرتفع FN من 1028 إلى 2054، فيقرأ المدير مراجعات أكثر لم تكن تحتاج إلى رد.
الإجابة 4
- تحصل مراجعتا السيناريو على
[0.08594148 0.69681757]. - تحصل مراجعتا الطعام كلتاهما على 0.5885: تحذف
notلأنها كلمة توقف، فتصبح المراجعتانfood, good. - مع الإبقاء على كلمات التوقف، يعطي تشغيلنا 74,938 خاصية، ودقة 0.8967، وقيمة ROC AUC تساوي 0.9574، وكلتاهما أعلى من 0.8777 و0.9452.
- تحصل
The food was goodالآن على 0.7082، وThe food was not goodعلى 0.2912. فالمفردات الجديدة تحتوي علىnot(-0.1181) وwas not(-0.2283) والزوجnot good(-0.7838)، لذا يستطيع النفي أخيرا أن يخفض الدرجة. والثمن مفردات أكبر بأكثر من الضعف.