

عمليات Pandas المتقدمة وقراءة البيانات من مصادر متعددة
يبدأ كل نموذج في هذا المقرر من جدول من البيانات، وهذا القسم يدخل ذلك الجدول إلى Python ويهيئه للعمل. ستقرأ أولا البيانات الصغيرة نفسها لأسعار المنازل من ملفات CSV فيها مشكلات، ومن ملفات نصية، ومن مصنف (workbook) Excel، ومن صفحة ويب، ومن ملف JSON. ثم تعمل على ملف متجر (superstore) يضم 9994 طلبا: تختار الصفوف، وتصفيها (filter) بالشروط، وتقسمها إلى مجموعات (groups) وتطبق عليها دوال التجميع (aggregation)، وتملأ القيم المفقودة (missing values) أو تحذفها، وتضم الجداول (join) بعضها إلى بعض، وتنشئ أعمدة جديدة. ويغطي القسم دفتري (notebooks) الأسبوع 1 كليهما.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- قراءة ملفات CSV والملفات النصية بالقيم الصحيحة للخيارات
sepوheaderوnamesوskiprowsوskipfooterوnrows. - قراءة أوراق (sheets) Excel وجداول HTML وملفات JSON في DataFrame.
- اختيار الصفوف والأعمدة باستخدام
loc، وتصفية الصفوف باستخدام قناع منطقي (boolean mask)، وتلخيص الأعمدة باستخدامdescribe. - التجميع باستخدام
groupbyوpivot_table، وإنشاء أعمدة جديدة باستخدامapply. - العثور على القيم المفقودة باستخدام
isnull، ثم ملؤها باستخدامfillnaوffillوbfill، أو حذفها باستخدامdropna. - ضم الجداول باستخدام
concatوmergeوjoin.
موقع الدرس من المقرر
للأسبوع 1 في الخطة ثلاثة أجزاء:
- دفتران. يعمل
Advanced Pandas Operationsعلى مصنف لمبيعات المتجر. ويقرأHow to read data from different text based (and non-text based) sourcesملفات صغيرة لأسعار المنازل بصيغ كثيرة. - البيانات. لا تحدد الخطة سيناريو واقعيا مستقلا للأسبوع 1، والمثال الذي نعمل عليه هو بيانات المتجر في الدفتر، وفيها صف لكل بند طلب (order line) في متجر بالولايات المتحدة.
- مرحلة المشروع (project milestone). كون فريقا عدد أعضائه 3 بفكرة مشروع، أو فريقا عدد أعضائه 2 بورقة بحثية.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | قراءة البيانات من مصادر متعددة | 35 دقيقة |
| 2 | الاختيار والتصفية والتجميع | 25 دقيقة |
| 3 | القيم المفقودة وضم الجداول وإعادة التشكيل (reshaping) | 25 دقيقة |
| 4 | الأخطاء الشائعة ومرحلة المشروع | 5 دقائق |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
أنتجنا كل المخرجات في هذه الصفحة بتشغيل الكود باستخدام pandas 3.0.6. وشغلناه أيضا باستخدام pandas 2.2.2: كل رقم بقي كما هو، والفرق الوحيد الظاهر أن العمود النصي يوصف بالنوع object بدلا من str.
الجزء 1: قراءة البيانات من مصادر متعددة
افتح الدفتر
افتح "How to read various sources in a DataFrame" في Colab
يقرأ الدفتر كل ملف من مجلده الخاص، مثل pd.read_csv("CSV_EX_1.csv"). وهذا المجلد فارغ في Colab، لذا اقرأ كل ملف من المستودع (repository) بدلا من ذلك: ضع عنوان المستودع قبل اسم الملف.
import numpy as np
import pandas as pd

base = ("https://raw.githubusercontent.com/tirthajyoti/"
        "Machine-Learning-with-Python/master/Pandas%20and%20Numpy/"
        "Read_data_various_sources/")
df1 = pd.read_csv(base + "CSV_EX_1.csv")
df1.shape      # (5, 4)
دالة واحدة لكل مصدر
| المصدر | دالة pandas | ما تعيده |
|---|---|---|
| CSV، أو CSV مضغوط | pd.read_csv | DataFrame واحد |
| نص آخر تفصل قيمه بفاصل (separator) | pd.read_table | DataFrame واحد |
| مصنف Excel | pd.read_excel | DataFrame واحد، أو قاموس (dict) من DataFrame |
| جداول في صفحة ويب | pd.read_html | قائمة من DataFrame |
| ملف JSON | pd.read_json | DataFrame واحد |
| ملف Stata | pd.read_stata | DataFrame واحد |
| جداول في ملف PDF | read_pdf من الحزمة tabula-py | قائمة من DataFrame |
ملف CSV سليم
يضم CSV_EX_1.csv خمسة منازل:
Bedroom, Sq. foot, Locality, Price ($)
2, 1500, Good, 300000
3, 1300, Fair, 240000
3, 1900, Very good, 450000
3, 1850, Bad, 280000
2, 1640, Good, 310000
ويعطي pd.read_csv("CSV_EX_1.csv"):
   Bedroom   Sq. foot    Locality   Price ($)
0        2       1500        Good      300000
1        3       1300        Fair      240000
2        3       1900   Very good      450000
3        3       1850         Bad      280000
4        2       1640        Good      310000
صار السطر الأول أسماء الأعمدة، وصار كل سطر آخر صفا واحدا، مرقما بدءا من 0. وصارت أعمدة الأرقام من النوع int64. انظر جيدا إلى df1.columns:
['Bedroom', ' Sq. foot', ' Locality', ' Price ($)']في الملف مسافة بعد كل فاصلة، وتحتفظ بها pandas: اسم العمود الثاني هو ' Sq. foot'، بمسافة في أوله. لذا يفشل اختيار df1['Sq. foot'].
مثال محلول: ملف بلا سطر عناوين
يضم CSV_EX_2.csv المنازل الخمسة نفسها دون سطر العناوين (header). ومع الخيارات الافتراضية، يعامل pd.read_csv("CSV_EX_2.csv") السطر الأول على أنه سطر العناوين:
   2   1500        Good   300000
0  3   1300        Fair   240000
1  3   1900   Very good   450000
2  3   1850         Bad   280000
3  2   1640        Good   310000
في DataFrame الناتج 4 صفوف لا 5: تحول المنزل الأول إلى أسماء أعمدة. ويصلح ذلك خياران:
df2 = pd.read_csv("CSV_EX_2.csv", header=None,
                  names=['Bedroom', 'Sq.ft', 'Locality', 'Price($)'])
Bedroom Sq.ft Locality Price($)
0 2 1500 Good 300000
1 3 1300 Fair 240000
2 3 1900 Very good 450000
3 3 1850 Bad 280000
4 2 1640 Good 310000يعني header=None أنه لا يوجد سطر عناوين. ويعطي names الأعمدة أسماءها. ومع header=None وحده، ترقم الأعمدة 0, 1, 2, 3.
مثال محلول: فاصل مختلف
يفصل CSV_EX_3.csv بين قيمه بفواصل منقوطة: Bedroom; Sq. foot; Locality; Price ($). والفاصل الافتراضي هو الفاصلة، ولا فاصلة في الملف، لذا يبقي pd.read_csv("CSV_EX_3.csv") كل سطر قطعة نصية واحدة:
  Bedroom; Sq. foot; Locality; Price ($)
0                  2; 1500; Good; 300000
1                  3; 1300; Fair; 240000
2             3; 1900; Very good; 450000
3                   3; 1850; Bad; 280000
4                  2; 1640; Good; 310000
الشكل (shape) هو (5, 1). ومع pd.read_csv("CSV_EX_3.csv", sep=';') يصبح الشكل (5, 4) ويطابق الجدول CSV_EX_1. وإذا ظهر DataFrame بعمود واحد بعد القراءة مباشرة، فهذا يعني في أغلب الأحوال قيمة خاطئة لـsep.
أسماؤك فوق سطر عناوين موجود
لا يحذف names وحده سطر عناوين موجودا في الملف أصلا:
pd.read_csv("CSV_EX_1.csv", names=['A', 'B', 'C', 'D']) A B C D
0 Bedroom Sq. foot Locality Price ($)
1 2 1500 Good 300000
2 3 1300 Fair 240000
3 3 1900 Very good 450000
4 3 1850 Bad 280000
5 2 1640 Good 310000صار سطر العناوين القديم الصف 0، فأصبح في الجدول 6 صفوف، وصار كل عمود يحمل نصا. وإضافة header=0 تخبر pandas بأن السطر 0 سطر عناوين يحذف ويستبدل:
pd.read_csv("CSV_EX_1.csv", header=0, names=['A', 'B', 'C', 'D']) A B C D
0 2 1500 Good 300000
1 3 1300 Fair 240000
2 3 1900 Very good 450000
3 3 1850 Bad 280000
4 2 1640 Good 310000مثال محلول: أسطر زائدة في الأعلى والأسفل
في CSV_EX_skipfooter.csv سطران قبل سطر العناوين، وسطر بعد البيانات:
Filetype: CSV,,,
,Info about some houses,,
Bedroom, Sq. foot, Locality, Price ($)
2,1500, Good,300000
3,1300, Fair,240000
3,1900, Very good,450000
3,1850, Bad,280000
2,1640, Good,310000
, This is the end of file,,
عند القراءة دون خيارات، يصبح السطر الأول سطر العناوين:
  Filetype: CSV                Unnamed: 1  Unnamed: 2  Unnamed: 3
0           NaN    Info about some houses         NaN         NaN
1       Bedroom                  Sq. foot    Locality   Price ($)
2             2                      1500        Good      300000
3             3                      1300        Fair      240000
4             3                      1900   Very good      450000
5             3                      1850         Bad      280000
6             2                      1640        Good      310000
7           NaN   This is the end of file         NaN         NaN
الشكل (8, 4)، والأعمدة المسماة Unnamed: 1 إلى Unnamed: 3 علامة على أن سطر العناوين أخذ من السطر الخطأ. تخط السطرين في الأعلى والسطر في الأسفل:
df6 = pd.read_csv("CSV_EX_skipfooter.csv", skiprows=2, skipfooter=1, engine='python')يعطي هذا الجدول السليم (5, 4). ولا يستطيع محرك القراءة (engine) الافتراضي، المكتوب بلغة C، تخطي السطر الختامي (footer)؛ ودون engine='python' تنتقل pandas إلى محرك python من تلقاء نفسها وتطبع ParserWarning. أما الملف CSV_EX_skiprows.csv ففيه السطران العلويان فقط، لذا يكفيه skiprows=2 وحده.
الملفات الكبيرة: nrows والقراءة على دفعات
يقرأ nrows=2 أول 2 من الصفوف فقط، وهذا مفيد للاطلاع على أعمدة ملف كبير جدا. ومع skiprows يقرأ الملف دفعة (chunk) بعد دفعة. في Boston_housing.csv يوجد 506 صفوف و14 عمودا:
list_of_dataframe = []
rows_in_a_chunk = 10
num_chunks = 5
df_dummy = pd.read_csv("Boston_housing.csv", nrows=2)
colnames = df_dummy.columns
for i in range(0, num_chunks*rows_in_a_chunk, rows_in_a_chunk):
    df = pd.read_csv("Boston_housing.csv", header=0, skiprows=i,
                     nrows=rows_in_a_chunk, names=colnames)
    list_of_dataframe.append(df)
تنتج الحلقة 5 جداول DataFrame، شكل كل منها (10, 14). تتخطى كل دورة عددا من الأسطر قدره i، ثم يحذف header=0 السطر التالي بوصفه سطر عناوين، ويعيد names أسماء الأعمدة الحقيقية. تبدأ الدفعة الأولى بالقيمة CRIM = 0.00632 وتنتهي بالقيمة 0.17004، وتبدأ الثانية بالقيمة 0.22489، والدفعات الخمس مكدسة معا هي بالضبط أول 50 صفا في الملف.
مثال محلول: الأسطر الفارغة
في CSV_EX_blankline.csv سطر فارغ بعد المنزل الثاني وآخر بعد الرابع. وافتراضيا يحذفهما skip_blank_lines=True، والنتيجة هي الجدول المعتاد (5, 4). ومع skip_blank_lines=False:
   Bedroom   Sq. foot    Locality   Price ($)
0      2.0     1500.0        Good    300000.0
1      3.0     1300.0        Fair    240000.0
2      NaN        NaN         NaN         NaN
3      3.0     1900.0   Very good    450000.0
4      3.0     1850.0         Bad    280000.0
5      NaN        NaN         NaN         NaN
6      2.0     1640.0        Good    310000.0
صار كل سطر فارغ صفا من NaN، وأصبح الشكل (7, 4)، وتحولت أعمدة الأرقام إلى أعداد عشرية (float) مثل 2.0، لأن NaN قيمة من نوع العدد العشري.
افتح مستكشف read_csv بملء الشاشة لتجرب كل خيار مما سبق على ملفات الدفتر. واضغط تشغيل أو خطوة لترى الأسطر التي تتخطاها pandas، والسطر الذي يعطي أسماء الأعمدة، وإلى أي صف يتحول كل سطر.
الملفات المضغوطة وأوراق Excel
- يقرأ
pd.read_csv('CSV_EX_1.zip')ملف CSV من داخل ملف مضغوط (zip): ترى pandas الامتداد فتفك الضغط أثناء القراءة. والملف المضغوط غير موجود في مجلد المستودع، لذا تفشل خلية الدفتر هذه كما هي؛ فضغطناCSV_EX_1.csvبأنفسنا، وجاءت النتيجة مساوية لقراءة ملف CSV العادي. - في
Housing_data.xlsxثلاث أوراق. يقرأpd.read_excel("Housing_data.xlsx", sheet_name='Data_Tab_1')واحدة منها، وأشكالData_Tab_1وData_Tab_2وData_Tab_3هي(9, 14)و(4, 14)و(16, 14). - ويقرأ
sheet_name=Noneكل الأوراق ويعيد قاموسا من DataFrame، ومفاتيحه هي'Data_Tab_1'و'Data_Tab_2'و'Data_Tab_3'.
read_table للنصوص الأخرى المفصولة بفاصل
يعمل pd.read_table مثل read_csv، لكن فاصله الافتراضي هو علامة الجدولة (tab). ويستخدم Table_tab_separated.txt علامات الجدولة، لذا يقرؤه pd.read_table("Table_tab_separated.txt") قراءة سليمة إلى (5, 4). أما Table_EX_1.txt فيستخدم الفواصل، لذا يعطي pd.read_table("Table_EX_1.txt") عمودا واحدا، (5, 1)، إلى أن تمرر sep=','.
جداول من صفحة ويب
يقرأ pd.read_html(url) كل عنصر table في صفحة الويب، ويعيد قائمة من DataFrame، واحدا لكل جدول. ويقرأ الدفتر جدول ميداليات الألعاب الأولمبية الصيفية 2016 من Wikipedia مع header=0.
عندما شغلناه في 25 سبتمبر 2026، رفض الموقع الطلب المباشر برسالة HTTP Error 403: Forbidden، وانتهت مهلة العنوان الآخر في الدفتر، وهو قائمة بالبنوك المتعثرة. فحفظنا صفحة Wikipedia من متصفح ومررنا الملف المحفوظ إلى read_html، فأعطى 8 جداول بهذه الأشكال:
[(7, 2), (3, 1), (87, 6), (9, 8), (7, 5), (6, 2), (2, 2), (1, 2)]جدول الميداليات هو العنصر 2، وشكله (87, 6)؛ وكان في مخرجات الدفتر المحفوظة العنصر 1 من 6 جداول، لأن الصفحة تغيرت منذ ذلك الحين. وهذه صفوفه الأولى:
  Rank            NOC  Gold  Silver  Bronze  Total
0    1  United States    46      37      38    121
1    2  Great Britain    27      23      17     67
2    3          China    26      18      26     70
3    4        Russia‡    19      17      20     56
4    5        Germany    17      10      15     42
الصف الأخير، Totals (86 entries)، صف ملخص وليس دولة، وهذا من نوع التنظيف الإضافي الذي يحتاجه جدول الويب عادة. افحص دائما len() للقائمة وشكل كل جدول قبل أن تختار أحدها.
JSON وStata وPDF
الملفات movies.json وrscfp2016.dta وHousing_data.pdf التي يستخدمها الدفتر غير موجودة في مجلد المستودع، لذا تفشل تلك الخلايا كما هي. ولتجربة read_json كتبنا المنازل الخمسة في ملف JSON صغير، على هيئة قائمة من السجلات (records):
[
  {"Bedroom": 2, "Sq. foot": 1500, "Locality": "Good", "Price ($)": 300000},
  {"Bedroom": 3, "Sq. foot": 1300, "Locality": "Fair", "Price ($)": 240000},
  {"Bedroom": 3, "Sq. foot": 1900, "Locality": "Very good", "Price ($)": 450000},
  {"Bedroom": 3, "Sq. foot": 1850, "Locality": "Bad", "Price ($)": 280000},
  {"Bedroom": 2, "Sq. foot": 1640, "Locality": "Good", "Price ($)": 310000}
]
يحول dj = pd.read_json('houses.json') كل سجل إلى صف: الجدول (5, 4) نفسه، ولكن هذه المرة دون مسافات زائدة في أسماء الأعمدة. وتعمل التصفية كما في أي DataFrame، فيبقي dj[dj['Locality'] == 'Good'] الصفين 0 و4.
- يقرأ
pd.read_stata("rscfp2016.dta")ملف بيانات Stata بالطريقة نفسها. - تستخرج
read_pdf، من الحزمة المستقلةtabula-pyالتي تشغل Java في الخلفية، الجداول من صفحات PDF، وتعيد قائمة من DataFrame. ويصعب استخراج أسماء الأعمدة من ملف PDF، لذا يمررها الدفتر بنفسه عبرpandas_options={'header': None, 'names': ...}.
الجزء 2: الاختيار والتصفية والتجميع
افتح الدفتر
افتح "Advanced Pandas Operations" في Colab
يقرأ الدفتر Sample - Superstore.xls من مجلده الخاص. أما في Colab فاقرأه من المستودع:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

url = ("https://raw.githubusercontent.com/tirthajyoti/"
       "Machine-Learning-with-Python/master/"
       "Pandas%20and%20Numpy/Sample%20-%20Superstore.xls")
df = pd.read_excel(url)
df.shape                              # (9994, 21)
df.drop('Row ID', axis=1, inplace=True)
df.shape                              # (9994, 20)
يحتاج ملف .xls، وهو صيغة Excel القديمة، إلى الحزمة xlrd. وإذا أبلغ Colab بأنها غير موجودة، فشغل !pip install xlrd مرة واحدة ثم أعد القراءة.
كل صف بند طلب واحد: تاريخ الطلب وتاريخ الشحن، وطريقة الشحن، والعميل، والمدينة والولاية والمنطقة، والمنتج وفئته، والأرقام Sales وQuantity وDiscount وProfit. وفي المصنف 4 أوراق، هي Orders وReturns وPeople وMissing، ويقرأ read_excel الأولى منها ما لم تمرر sheet_name. ولا يفعل Row ID سوى تكرار رقم الصف، لذا يحذفه الدفتر.
اختيار الصفوف والأعمدة باستخدام loc
يأخذ loc قائمة من تسميات الفهرس (index labels) وقائمة من أسماء الأعمدة:
df.loc[[i for i in range(5, 10)], ['Customer ID', 'City', 'Postal Code', 'Sales']] Customer ID City Postal Code Sales
5 BH-11710 Los Angeles 90032 48.860
6 BH-11710 Los Angeles 90032 7.280
7 BH-11710 Los Angeles 90032 907.152
8 BH-11710 Los Angeles 90032 18.504
9 BH-11710 Los Angeles 90032 114.900يختار الدفتر أيضا العمود Customer Name، وفي هذه الصفحة نستخدم Customer ID، الذي يحدد العملاء أنفسهم.
مثال محلول: describe على السجلات 100 إلى 199
df_subset = df.loc[[i for i in range(100, 200)], ['Sales', 'Profit']]
df_subset.describe()
Sales Profit
count 100.000000 100.000000
mean 262.957220 0.347574
std 858.983762 170.744869
min 1.788000 -1359.992000
25% 21.327000 1.635900
50% 66.960000 9.653600
75% 177.095000 23.458800
max 8159.952000 585.552000سؤال. متوسط (mean) Sales يساوي نحو 4 أضعاف وسيطه (median)، أي الصف 50%. ماذا يخبرك هذا؟
الإجابة. بضعة طلبات كبيرة جدا، تصل إلى 8159.952، ترفع المتوسط إلى 262.96، بينما يقع الطلب المعتاد قرب الوسيط، 66.96. ويقع نصف المبيعات الـ100 بين الربيعين (quartiles) 21.327 و177.095. وعندما يحتوي عمود على بضع قيم ضخمة، يصف الوسيط الصف المعتاد أفضل من المتوسط.
ثم يرسم الدفتر مخططا صندوقيا (boxplot) للعمودين:
df_subset.plot.box()
plt.title("Boxplot of sales and profit", fontsize=15)
plt.ylim(0, 500)
plt.grid(True)
plt.show()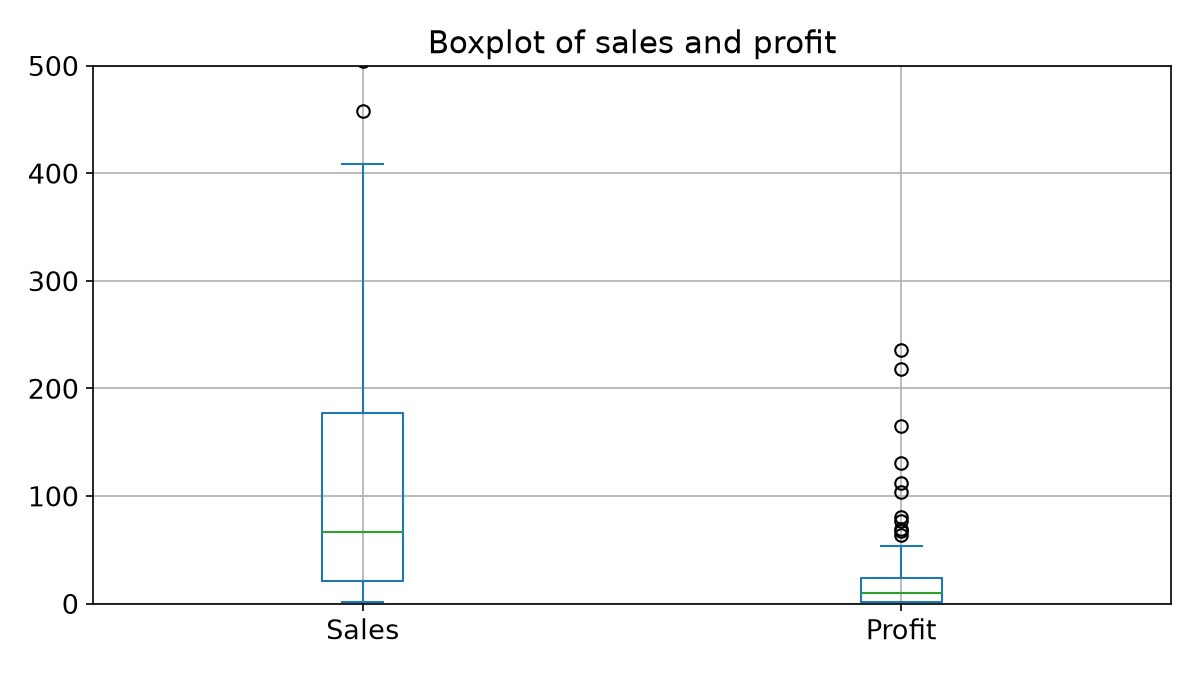
يمتد الصندوق على النصف الأوسط من القيم، والخط داخله هو الوسيط. ويكبر plt.ylim(0, 500) الصناديق، فتقع خارج المخطط 12 قيمة مبيعات و1 من قيم الربح فوق 500، وقيم الربح السالبة الـ20.
unique وnunique
df['State'].nunique()       # 49
df['Country'].unique()      # ['United States']
df.drop('Country', axis=1, inplace=True)
df.shape                    # (9994, 19)
يسرد unique() القيم المختلفة في عمود، ويعدها nunique(). ويحمل Country قيمة واحدة في كل صف، فلا يحمل أي معلومات، ولذلك يحذفه الدفتر.
مثال محلول: قناع منطقي
يستخدم باقي هذا الجزء أول 10 طلبات وثلاثة أعمدة:
df_subset = df.loc[[i for i in range(10)], ['Ship Mode', 'State', 'Sales']] Ship Mode State Sales
0 Second Class Kentucky 261.9600
1 Second Class Kentucky 731.9400
2 Second Class California 14.6200
3 Standard Class Florida 957.5775
4 Standard Class Florida 22.3680
5 Standard Class California 48.8600
6 Standard Class California 7.2800
7 Standard Class California 907.1520
8 Standard Class California 18.5040
9 Standard Class California 114.9000سؤال. ما الصفوف التي يبقيها df_subset[df_subset['Sales'] > 100]؟
الإجابة. التعبير df_subset['Sales'] > 100 هو Series من قيم True وFalse، قيمة لكل صف: True للصفوف 0 و1 و3 و7 و9. ووضعه داخل الأقواس المربعة يبقي تلك الصفوف بالضبط، كل منها بتسمية فهرسه:
        Ship Mode       State     Sales
0    Second Class    Kentucky  261.9600
1    Second Class    Kentucky  731.9400
3  Standard Class     Florida  957.5775
7  Standard Class  California  907.1520
9  Standard Class  California  114.9000
تجمع الشروط باستخدام & (يجب أن يتحقق الشرطان) و| (يكفي أن يتحقق أحدهما على الأقل)، ويحتاج كل شرط إلى قوسيه الخاصين:
df_subset[(df_subset['State'] != 'California') & (df_subset['Sales'] > 100)]يبقي هذا الصفوف 0 و1 و3، ويحذف الصفان 7 و9 لأنهما في California.
ويشغل الدفتر أيضا df_subset > 100 على DataFrame كله. وفي الإصدارات الحالية من pandas يطلق هذا الخطأ TypeError: '>' not supported between instances of 'str' and 'int'، لأن عمودين من الأعمدة الثلاثة يحملان نصا. ابن القناع من عمود واحد، كما سبق.
تعيين الفهرس وإعادة ضبطه
ينشئ الدفتر DataFrame صغيرا فهرسه (index) هو الحروف A إلى E:
   Age  Height  Weight
A   22      66     140
B   42      70     148
C   30      62     125
D   35      68     160
E 25 62 152- ينقل
df1.reset_index()الحروف إلى عمود اسمهindex، ويرقم الصفوف بدءا من 0. - يرقم
df1.reset_index(drop=True)الصفوف بدءا من 0 ويتخلص من الحروف. - بعد إضافة عمود باستخدام
df1['Profession'] = "Student Teacher Engineer Doctor Nurse".split()، يجعلdf1.set_index('Profession')هذا العمود هو الفهرس، فيعيد.loc['Engineer']القيم Age 30 وHeight 62 وWeight 125.
groupby: التقسيم والتطبيق والدمج
يقوم df_subset.groupby('State') بثلاثة أشياء:
- التقسيم: يقسم الصفوف إلى مجموعات، مجموعة لكل ولاية: في California 6 صفوف، وفي Florida 2، وفي Kentucky 2.
- التطبيق: يطبق دالة تجميع، مثل المتوسط، على كل مجموعة.
- الدمج: يدمج الإجابات في صف واحد لكل مجموعة، مرتبة حسب اسم المجموعة.
مثال محلول: متوسط المبيعات لكل ولاية
سؤال. احسب متوسط Sales لكل ولاية من الصفوف الـ10 السابقة.
الإجابة.
Florida:    (957.5775 + 22.368) / 2 = 489.97275
Kentucky:   (261.96 + 731.94) / 2  = 496.95
California: (14.62 + 48.86 + 7.28 + 907.152 + 18.504 + 114.9) / 6 = 1111.316 / 6 = 185.219333
وتطبع pandas:
                 Sales
State
California  185.219333
Florida     489.972750
Kentucky    496.950000
groupby في الإصدارات الحالية من pandas
يستدعي الدفتر byState.mean() على DataFrame المجمع كله. وفي الإصدارات الحالية من pandas يطلق هذا الخطأ TypeError، لأن العمود Ship Mode يحمل نصا لا يمكن حساب متوسطه، أما byState.sum() فلا يفشل لكنه يلصق نصوص Ship Mode في كل مجموعة بعضها ببعض. اطلب الأعمدة الرقمية فقط، أو اختر العمود أولا:
byState = df_subset.groupby('State')
byState.mean(numeric_only=True)     # the table above
byState.sum(numeric_only=True)      # California 1111.3160, Florida 979.9455, Kentucky 993.9000
byState['Sales'].mean()             # the same means, as a Series
ويعمل describe() لكل مجموعة أيضا. يعطي byState.describe() العدد، والمتوسط، والانحراف المعياري (standard deviation)، والقيمة الصغرى، والربيعات، والقيمة العظمى لـSales في كل ولاية، وهي لـCalifornia: 6 و185.219333 و355.889307 و7.28 و15.591 و33.682 و98.39 و907.152. وعند التجميع حسب عمودين، ينتج df.groupby(['State', 'City']) على البيانات كلها 604 مجموعات.
افتح أداة عمليات DataFrame بملء الشاشة لتشاهد القناع المنطقي وgroupby وpivot_table وapply وsort_values وmerge تعمل على هذه الطلبات الـ10 خطوة بخطوة.
الجزء 3: القيم المفقودة وضم الجداول وإعادة التشكيل
العثور على القيم المفقودة
في الورقة Missing من المصنف 11 صفا و6 أعمدة، وفيها بضع خلايا فارغة:
df_missing = pd.read_excel(url, sheet_name="Missing")
for c in df_missing.columns:
    miss = df_missing[c].isnull().sum()
    if miss > 0:
        print("{} has {} missing value(s)".format(c, miss))
    else:
        print("{} has NO missing value!".format(c))
Customer has 1 missing value(s)
Product has 2 missing value(s)
Sales has 1 missing value(s)
Quantity has 1 missing value(s)
Discount has NO missing value!
Profit has 1 missing value(s)يعيد isnull() جدولا من True وFalse بالشكل نفسه، ويعد .sum() قيم True في كل عمود. وهذه هي الأعمدة غير Customer:
        Product     Sales  Quantity  Discount   Profit
0           NaN  1706.184       9.0       0.2  85.3092
1        Phones   911.424       4.0       0.2  68.3568
2           Art     8.560       2.0       0.0   2.4824
3        Phones       NaN       3.0       0.2  16.0110
4       Binders    22.720       4.0       0.2   7.3840
5       Binders    11.648       NaN       0.2   4.2224
6   Accessories    90.570       3.0       0.0  11.7741
7           NaN    77.880       2.0       0.0      NaN
8   Accessories    13.980       2.0       0.0   6.1512
9       Binders    25.824       6.0       0.2   9.3612
10        Paper   146.730       3.0       0.0  68.9631
والقيمة المفقودة في Customer موجودة في الصف 8.
مثال محلول: ملء قيمة البيع المفقودة
يكتب df_missing.fillna('FILL') النص FILL في كل خلية فارغة. أما في العمود الرقمي فالمطلوب عادة رقم. وقيمة العمود Sales مفقودة في الصف 3، بين 8.560 في الصف 2 و22.720 في الصف 4.
سؤال. ماذا يوضع في الصف 3 مع الملء الأمامي (forward fill)، ومع الملء الخلفي (backward fill)، ومع متوسط العمود؟
الإجابة.
- ينسخ
df_missing['Sales'].ffill()القيمة التي فوقها: 8.56. - ينسخ
df_missing['Sales'].bfill()القيمة التي تحتها: 22.72. - مجموع قيم المبيعات الـ10 المعروفة 3015.52، لذا يكون المتوسط
3015.52 / 10 = 301.552، ويضعdf_missing['Sales'].fillna(df_missing['Sales'].mean())القيمة 301.552 في الصف 3.
يكتب الدفتر fillna(method='ffill') وfillna(df_missing.mean()['Sales']). الأول يطلق TypeError في pandas 3 (وما زال pandas 2.2 يشغله مع تحذير)، والثاني يفشل في الإصدارين لأن df_missing.mean() يحاول حساب متوسط الأعمدة النصية. استخدم .ffill() و.bfill() ومتوسط العمود الواحد، كما سبق.
مثال محلول: dropna
أعداد القيم غير المفقودة في الأعمدة الستة هي: Customer 10، وProduct 9، وSales 10، وQuantity 10، وDiscount 11، وProfit 10.
سؤال. ما الذي يبقى بعد df_missing.dropna(axis=0)، وبعد df_missing.dropna(axis=1)، وبعد df_missing.dropna(axis=1, thresh=10)؟
الإجابة.
- يحذف
axis=0كل صف فيه قيمة مفقودة واحدة على الأقل. وتبقى الصفوف الكاملة الـ6: 1 و2 و4 و6 و9 و10. - يحذف
axis=1كل عمود فيه قيمة مفقودة واحدة على الأقل. ولا يبقى إلاDiscount، العمود الكامل الوحيد. - يبقي
thresh=10الأعمدة التي فيها 10 قيم على الأقل، لذا لا يحذف إلاProduct، الذي فيه 9.
كشف القيم الشاذة (outliers) باستخدام مخطط صندوقي
يأخذ الدفتر 50 طلبا عشوائيا ويزرع فيها قيمتي مبيعات خاطئتين، -1000 و-500، ثم يرسم المخطط الصندوقي مرة أخرى:
df_sample = df[['Customer ID', 'State', 'Sales', 'Profit']].sample(n=50, random_state=1).copy()
df_sample.iloc[5, 2] = -1000.0
df_sample.iloc[15, 2] = -500.0
df_sample.plot.box()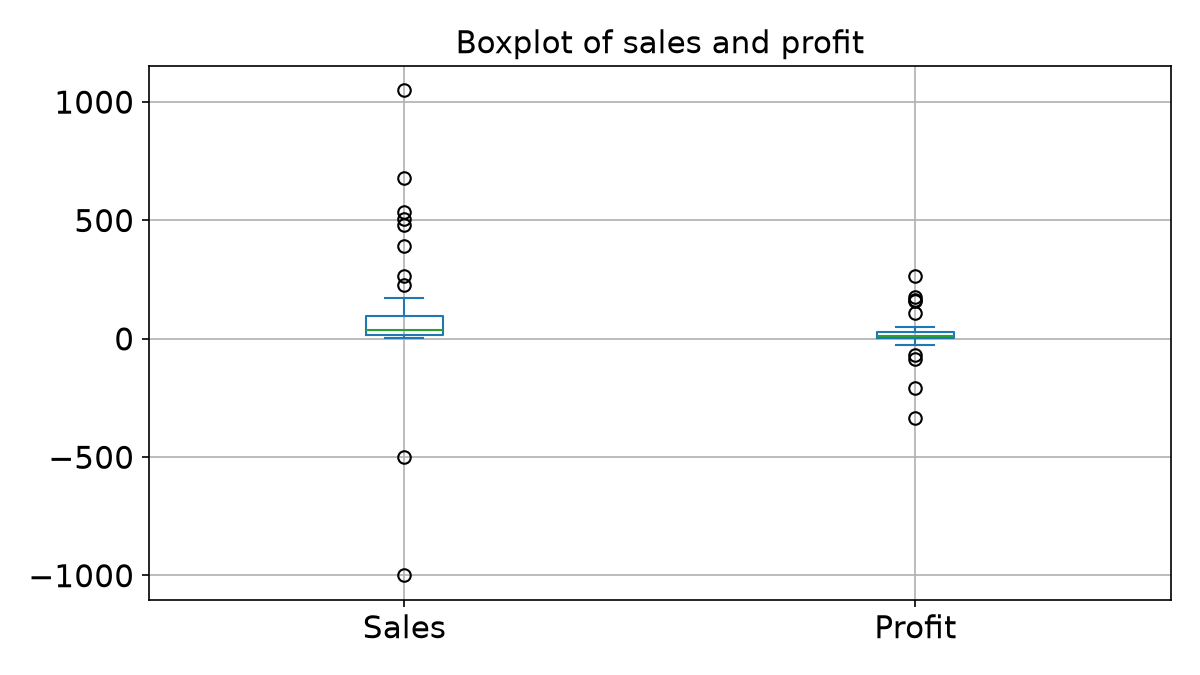
لا يمكن أن تكون قيمة البيع سالبة أبدا، لذا فالنقطتان البعيدتان أسفل صندوق Sales هما الخطآن. وأضفنا random_state=1 لتخرج العينة، ومعها هذا المخطط، متطابقة في كل مرة.
يزرع الدفتر القيم باستخدام df_sample['Sales'].iloc[5] = -1000.0. وهذا إسناد متسلسل (chained assignment): يعيد القوس الأول Series منفصلا، وتكتب القيمة فيه. وفي pandas 3 لا يغير هذا شيئا في df_sample (وما زال pandas 2.2 يغيره، مع تحذير). أما df_sample.iloc[5, 2]، أي موضع الصف 5 وموضع العمود 2 (Sales)، فيكتب في DataFrame نفسه.
مثال محلول: concat
خذ ثلاثة جداول صغيرة، في كل منها 2 من الطلبات، بالأعمدة Customer ID وState وSales وProfit: يضم a الصفين 0 و1، وb الصفين 2 و3، وc الصفين 4 و5. (يأخذ الدفتر ثلاث عينات عشوائية في كل منها 4 طلبات، أما الصفوف الثابتة فتعطي الأرقام نفسها في كل مرة.)
سؤال. ما شكل pd.concat([a, b, c], axis=0)، وما شكل pd.concat([a, b, c], axis=1)؟
الإجابة.
- يكدس
axis=0الصفوف: الشكل(6, 4). - يضع
axis=1الجداول جنبا إلى جنب ويحاذيها حسب الفهرس: الشكل(6, 12). ولا تظهر أي تسمية فهرس في جدولين، لذا يحمل كل صف قيما في كتلة واحدة فقط من 4 أعمدة، و48 من الخلايا الـ72 قيمتهاNaN.
مثال محلول: merge على مفتاح
يضم merge جدولين عبر عمود مشترك هو المفتاح (key). ويضم الدفتر الجدولين حسب اسم العميل، وهنا نستخدم Customer ID، الذي يعطي النتيجة نفسها:
df_1 = df[['Customer ID', 'Ship Date', 'Ship Mode']][0:4]
df_2 = df[['Customer ID', 'Sub-Category', 'Quantity']][0:4]
يضم الجدولان الصفوف 0 إلى 3، ومفاتيحها CG-12520 وCG-12520 وDV-13045 وSO-20335.
سؤال. كم صفا في ناتج pd.merge(df_1, df_2, on='Customer ID', how='inner')؟
الإجابة. يقترن كل صف في الجدول الأيسر بكل صف في الجدول الأيمن له المفتاح نفسه. ويظهر CG-12520 في 2 من الصفوف في كل جانب، لذا يعطي 2 × 2 = 4 صفوف، ويعطي كل من DV-13045 وSO-20335 1 من الصفوف. والمجموع 4 + 1 + 1 = 6 صفوف:
  Customer ID  Ship Date       Ship Mode Sub-Category  Quantity
0    CG-12520 2016-11-11    Second Class    Bookcases         2
1    CG-12520 2016-11-11    Second Class       Chairs         3
2    CG-12520 2016-11-11    Second Class    Bookcases         2
3    CG-12520 2016-11-11    Second Class       Chairs         3
4    DV-13045 2016-06-16    Second Class       Labels         2
5    SO-20335 2015-10-18  Standard Class       Tables         5
يكرر الصفان 2 و3 الصفين 0 و1، لأن صفي CG-12520 في df_1 متطابقان. ويحذفهما .drop_duplicates() فتبقى 4 صفوف.
inner وleft وright وouter
نضم الآن df_1 إلى df_3 = df[['Customer ID', 'Sub-Category', 'Quantity']][2:6]، ومفاتيحه DV-13045 وSO-20335 وSO-20335 وBH-11710. ويحدد الخيار how المفاتيح التي تبقى:
| how | ما يبقيه | الصفوف |
|---|---|---|
inner | المفاتيح الموجودة في الجدولين | 3 |
left | كل صفوف df_1 | 5 |
right | كل صفوف df_3 | 4 |
outer | كل مفاتيح الجدولين، مرتبة | 6، ثم 5 بعد drop_duplicates() |
ناتج الضم outer بعد drop_duplicates():
  Customer ID  Ship Date       Ship Mode Sub-Category  Quantity
0    BH-11710        NaT             NaN  Furnishings       7.0
1    CG-12520 2016-11-11    Second Class          NaN       NaN
3    DV-13045 2016-06-16    Second Class       Labels       2.0
4    SO-20335 2015-10-18  Standard Class       Tables       5.0
5    SO-20335 2015-10-18  Standard Class      Storage       2.0
يملأ المطابق المفقود بالقيمة NaN، وبالقيمة NaT ("not a time"، أي ليس وقتا) في عمود التاريخ. ولأن Quantity صار يحمل NaN، فقد تحول إلى عمود أعداد عشرية.
ويؤدي join العمل نفسه على الفهرس بدلا من عمود. فبعد df_1.set_index(['Customer ID'], inplace=True) والشيء نفسه مع df_3، يعطي df_1.join(df_3, how='outer').drop_duplicates() الصفوف الـ5 نفسها، مع Customer ID فهرسا.
sample وvalue_counts
- يعيد
df.sample(n=5)5 صفوف عشوائية، ويعيدdf.sample(frac=0.001)نسبة 0.1 في المئة من الصفوف، أي 10 من 9994. ويختار كل تشغيل صفوفا مختلفة ما لم تمررrandom_state. - يعد
df['Ship Mode'].value_counts()كل قيمة مختلفة: Standard Class 5968، وSecond Class 1945، وFirst Class 1538، وSame Day 543. ويشغله الدفتر على عمود العميل ليجد أكثر العملاء تكرارا، وبحسبCustomer IDفإن أولهم،WB-21850، له 37 بندا.
pivot_table
يجمع pivot_table حسب أعمدة index، ويطبق aggfunc على أعمدة values:
df.pivot_table(values=['Sales', 'Quantity', 'Profit'], index=['Region'], aggfunc='mean')بعد التقريب إلى 2 من المنازل العشرية:
| Region | Profit | Quantity | Sales |
|---|---|---|---|
| Central | 17.09 | 3.78 | 215.77 |
| East | 32.14 | 3.73 | 238.34 |
| South | 28.86 | 3.83 | 241.80 |
| West | 33.85 | 3.83 | 226.49 |
يشغله الدفتر على عينة عشوائية من 100 طلب مع index=['Region', 'State']، فينتج صفا واحدا لكل زوج من المنطقة والولاية. أما على البيانات كاملة فيبقى كل رقم هو نفسه في كل تشغيل.
sort_values
يرتب df_subset.sort_values(by='Sales') الصفوف الـ10 من أصغر قيمة بيع إلى أكبرها: يأتي الصف 6 (7.28) أولا والصف 3 (957.5775) أخيرا، ويحتفظ كل صف بتسمية فهرسه. ويرتب sort_values(by=['State', 'Sales']) حسب State أولا، ثم يرتب الصفوف المتساوية فيه حسب Sales، لذا تأتي صفوف California الستة أولا، من 7.28 إلى 907.152.
مثال محلول: تطبيق دالة باستخدام apply
يستدعي apply دالة مرة واحدة لكل قيمة في عمود، ويعيد الإجابات في Series جديد:
def categorize_sales(price):
    if price < 50:
        return "Low"
    elif price < 200:
        return "Medium"
    else:
        return "High"

df_subset['Sales Price Category'] = df_subset['Sales'].apply(categorize_sales)
سؤال. ماذا تعيد categorize_sales للقيم 261.96 و14.62 و114.9؟
الإجابة. القيمة 261.96 ليست أقل من 200، إذن High؛ و14.62 أقل من 50، إذن Low؛ و114.9 ليست أقل من 50 لكنها أقل من 200، إذن Medium. وعلى الطلبات الـ9994 كلها، الفئات هي Low 4849، وHigh 2579، وMedium 2566.
يمكن كتابة دالة قصيرة في مكانها باستخدام lambda. يعطي df_subset['Sales'].apply(lambda x: 0.85*x if x > 200 else x) خصما بنسبة 15 في المئة على كل بيع أكبر من 200: يصبح الصف 0 0.85 × 261.96 = 222.666، ويبقى الصف 2، 14.62، كما هو. ويعيد apply(len) على عمود نصي طول كل قيمة، فيعطي على State القيمة 8 لـKentucky والقيمة 10 لـCalifornia.
الأخطاء الشائعة
- عمود واحد بعد القراءة: قيمة
sepلا تطابق الملف. - فقدان الصف الأول: الملف بلا سطر عناوين، لذا مرر
header=None. namesدونheader=0على ملف له سطر عناوين: يصبح سطر العناوين القديم صف بيانات.- قراءة اسم ملف مجرد في Colab: الملف غير موجود هناك، فاستخدم عنوان المستودع.
- نسيان القوسين حول كل شرط مربوط بـ
&أو|. - تشغيل استدعاءات الدفتر القديمة كما هي:
fillna(method=...)، وmean()على DataFrame فيه أعمدة نصية، والإسناد المتسلسل مثلdf['Sales'].iloc[5] = value. - الضم على مفتاح يتكرر في الجانبين دون التحقق من عدد الصفوف الناتجة.
مرحلة المشروع: كون فريقك
تبدأ مرحلة هذا الأسبوع مشروع المقرر:
- كون فريقا عدد أعضائه 3 بفكرة مشروع، أو فريقا عدد أعضائه 2 بورقة بحثية.
- اكتب السؤال الذي يجيب عنه مشروعك، أو الورقة التي ستدرسها.
- ابحث عن مجموعة البيانات (dataset) وحملها بدالة القراءة التي تناسب صيغتها:
read_csvأوread_excelأوread_htmlأوread_jsonأو غيرها من الجزء 1. - بعد التحميل مباشرة، افحص
shapeوأسماء الأعمدة وisnull().sum().
في الأسبوع القادم تكون المرحلة هي مقترح المشروع أو الورقة البحثية، ويحول الدرس جداول DataFrame إلى مخططات باستخدام Matplotlib وSeaborn.
الخلاصة
- لـpandas دالة قراءة لكل صيغة، وتعيد كل منها DataFrame، ما عدا
read_htmlوread_pdfاللتين تعيدان قائمة منها، وread_excelمعsheet_name=Noneالتي تعيد قاموسا. - افحص الشكل وأسماء الأعمدة بعد القراءة مباشرة، فهي تكشف قيمة خاطئة لـ
sep، أو سطر عناوين مفقودا، أو أسطرا زائدة لا قيمة لها. - استخدم القناع المنطقي لتصفية الصفوف، و
groupbyوpivot_tableلتلخيص المجموعات. - اعثر على القيم المفقودة باستخدام
isnull، ثم قرر هل تملؤها أم تحذفها. - استخدم
concatأوmergeأوjoinلضم الجداول، ثم عد صفوف الناتج.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في آخر الصفحة.
التمرين 1: ملف تصدير غير مرتب (نحو 5 دقائق)
أنتج نظام المعمل عند التصدير هذا الملف، p1_scores.txt:
Exported by the lab system
Section 3
ID;Name;Quiz;Lab
101;A1;7;9
102;B2;5;8
103;C3;9;10
104;D4;6;7
End of export- ما الشكل الذي يعطيه
pd.read_csv('p1_scores.txt')دون خيارات، ولماذا؟ - اكتب استدعاء
read_csvالذي يعطي جدولا سليما، واذكر شكله وأسماء أعمدته. - عدل استدعاءك ليقرأ أول 2 من الطلاب فقط.
التمرين 2: القناع وgroupby وapply (نحو 8 دقائق)
  Region       Ship Mode  Sales
0   East     First Class  120.0
1   West  Standard Class   45.5
2   East  Standard Class  310.0
3  South    Second Class   80.0
4   West     First Class  220.0
5  South  Standard Class   15.0
6   East    Second Class   95.0
7 West Standard Class 60.5- ما الصفوف التي يبقيها
df[(df['Sales'] > 100) & (df['Region'] != 'West')]؟ - احسب مجموع
Salesومتوسطه لكل منطقة باستخدامgroupby('Region'). - طبق
categorize_salesعلىSales. كم طلبا يقع في كل فئة؟
التمرين 3: القيم المفقودة (نحو 5 دقائق)
في DataFrame ثلاثة أعمدة و5 صفوف:
Qty: 4, NaN, 6, NaN, 10Price: 2.5, 3.0, NaN, 4.0, 5.5Item: pen, ink, None, pad, tape
- اكتب
Qtyبعدffill()وبعدbfill(). - اكتب
Qtyبعد ملئه بمتوسطه. - ما الصفوف التي تبقى بعد
dropna(axis=0)؟ وما الأعمدة التي تبقى بعدdropna(axis=1, thresh=4)؟
التمرين 4: عد صفوف الضم (نحو 5 دقائق)
left:Key= K1, K2, K2, K3 وA= 1, 2, 3, 4right:Key= K2, K3, K3, K4 وB= 10, 20, 30, 40
كم صفا يعيد pd.merge(left, right, on='Key', how=...) عندما تكون قيمة how هي 'inner' و'left' و'right' و'outer'؟ فسر كل عدد قبل أن تشغل الكود.
التمرين 5: في Colab، على بيانات المتجر (نحو 7 دقائق)
حمل طلبات المتجر كما في الجزء 2، ثم:
- كم طلبا من Texas؟
- احسب مجموع
SalesوProfitلكلCategoryباستخدامgroupby. - كم طلبا خسر مالا (قيمة
Profitأقل من 0)؟ - استخدم
pivot_tableمعaggfunc='sum'لتحصل على مجموعProfitلكلRegion. ما المنطقة الأدنى؟
الإجابات
الإجابة 1
- دون خيارات يكون الشكل
(7, 1). يصبح السطر الأول،Exported by the lab system، سطر العناوين، ولأن الملف يستخدم الفواصل المنقوطة لا الفواصل، يبقى كل سطر آخر قطعة واحدة. - تخط 2 من الأسطر في الأعلى و1 في الأسفل، وحدد الفاصل:
pd.read_csv('p1_scores.txt', sep=';', skiprows=2, skipfooter=1, engine='python') ID Name Quiz Lab
0 101 A1 7 9
1 102 B2 5 8
2 103 C3 9 10
3 104 D4 6 7الشكل (4, 4)، والأعمدة هي ID وName وQuiz وLab.
- يقرأ
pd.read_csv('p1_scores.txt', sep=';', skiprows=2, nrows=2)الطالبين 101 و102. احذفskipfooterهنا: ترفض pandas الجمع بينه وبينnrows(ValueError: 'skipfooter' not supported with 'nrows')، ومعnrows=2لا تصل القراءة إلى السطر الختامي أصلا.
الإجابة 2
- الصفان 0 و2. في الصفوف 0 و2 و4 مبيعات أكبر من 100، والصف 4 في المنطقة West.
- المجاميع: East
120 + 310 + 95 = 525.0، وSouth80 + 15 = 95.0، وWest45.5 + 220 + 60.5 = 326.0. المتوسطات: East525 / 3 = 175.0، وSouth95 / 2 = 47.5، وWest326 / 3 = 108.666667. - الفئات بترتيب الصفوف هي Medium وLow وHigh وMedium وHigh وLow وMedium وMedium، إذن Medium 4، وLow 2، وHigh 2.
الإجابة 3
ffill(): 4, 4, 6, 6, 10. وbfill(): 4, 6, 6, 10, 10.- متوسط القيم المعروفة
(4 + 6 + 10) / 3 = 6.666667، لذا يصبحQty: 4, 6.666667, 6, 6.666667, 10. - لا يخلو من القيم المفقودة إلا الصفان 0 و4. ومع
thresh=4يبقىPrice(4 قيم) وItem(4 قيم)، ويحذفQty(3 قيم).
الإجابة 4
| how | الصفوف | السبب |
|---|---|---|
inner | 4 | K2: عدد صفوفه 2 في الجدول الأيسر × 1 في الأيمن = 2؛ وK3: 1 × 2 = 2 |
left | 5 | صفوف inner الـ4، ومعها K1 مع B = NaN |
right | 5 | صفوف inner الـ4، ومعها K4 مع A = NaN |
outer | 6 | صفوف inner الـ4، ومعها K1 وK4 |
الإجابة 5
- قيمة
df[df['State'] == 'Texas'].shapeهي(985, 19)، أي 985 طلبا. df.groupby('Category')[['Sales', 'Profit']].sum():
| Category | Sales | Profit |
|---|---|---|
| Furniture | 741999.7953 | 18451.2728 |
| Office Supplies | 719047.0320 | 122490.8008 |
| Technology | 836154.0330 | 145454.9481 |
تبيع Furniture بقدر ما تبيعه كل من الفئتين الأخريين تقريبا، لكن ربحها أقل بكثير.
- قيمة
(df['Profit'] < 0).sum()هي 1871 طلبا. - يعطي
df.pivot_table(values=['Profit'], index=['Region'], aggfunc='sum')القيم Central 39706.3625، وEast 91522.7800، وSouth 46749.4303، وWest 108418.4489. والأدنى هي Central.