

تصوير البيانات باستخدام Matplotlib وSeaborn
لا يكون النموذج أفضل من فهمك للبيانات التي يتعلم منها، وأسرع طريق لفهم مجموعة بيانات (dataset) هو أن تنظر إليها. يعلمك هذا القسم مكتبتي الرسم المستخدمتين في جميع دفاتر (notebooks) المقرر: Matplotlib، التي ترسم أي مخطط تصفه، وSeaborn، التي ترسم المخططات الإحصائية من DataFrame في سطر واحد. سترسم أنواع المخططات نفسها التي يرسمها دفتر الأسبوع 2، وتحسب يدويا مدرجا تكراريا (histogram) ومخططا صندوقيا (boxplot) وارتباطا (correlation)، وتتعلم أي مخطط يجيب عن أي سؤال.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- رسم مخطط انتشار (scatter plot) ومخطط أعمدة (bar chart) ومدرج تكراري ومخطط خطي (line plot) ومخطط صندوقي باستخدام Matplotlib، وإضافة عنوان وتسميات للمحاور (labels) وعلامات تدريج (ticks) وشبكة (grid) ونص وخطوط ومفتاح رسم (legend).
- حساب فئات (bins) المدرج التكراري يدويا، وأجزاء المخطط الصندوقي: الوسيط (median)، والربيعين (quartiles)، والشاربين (whiskers)، والقيم الشاذة (outliers).
- الرسم مباشرة من DataFrame في pandas باستخدام
df.plot.scatterوdf.plot.hist. - رسم مقارنات المجموعات والاتجاهات باستخدام Seaborn:
boxplotوviolinplotوregplotوlmplot. - حساب معامل الارتباط (correlation coefficient)، وبناء مصفوفة الارتباط (correlation matrix) باستخدام
np.corrcoef، وقراءتها في صورة خريطة حرارية (heatmap). - اختيار المخطط الذي يناسب سؤالا ومجموعة بيانات، واستخدام هذه المخططات في مقترح مشروعك.
موقع الدرس من المقرر
للأسبوع 2 في الخطة ثلاثة أجزاء:
- الدفتر.
Matplotlib_Seaborn_basicsمن مستودع المقرر، على ثلاث مجموعات بيانات صغيرة. - سيناريو من الواقع. تترك الخطة هذا العمود فارغا في الأسبوع 2، لذا نعمل على مواقف الدفتر نفسه: مرضى يزورون عيادة، وشهر من استطلاعات الرأي لمرشحين اثنين، وجدول من 178 عينة نبيذ يصف كل منها 13 قياسا.
- مرحلة المشروع (project milestone). مقترح المشروع أو الورقة البحثية (Project/Paper Proposal): في هذا الأسبوع يكتب فريقك مقترح مشروعه أو ورقته البحثية.
في الأسبوع 1 حملت البيانات في DataFrame في pandas وتعاملت معها. وفي هذا الأسبوع تنظر إلى هذه البيانات. ومن الأسبوع 3 فصاعدا، يبدأ كل نموذج بالمخططات التي تتعلمها اليوم.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | Matplotlib على بيانات العيادة: الانتشار، والتنسيق، والأعمدة، والمدرج التكراري يدويا | 30 دقيقة |
| 2 | بيانات الاستطلاع: مخطط خطي، ومخطط صندوقي يدويا | 20 دقيقة |
| 3 | pandas وSeaborn على بيانات النبيذ | 20 دقيقة |
| 4 | الارتباط، والخريطة الحرارية، واختيار المخطط | 15 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 35 دقيقة |
افتح الدفتر
افتح Matplotlib_Seaborn_basics في Colab
تغييران يجعلان تشغيلك مطابقا لهذه الصفحة تماما:
- يستخدم المخطط الخطي أعدادا عشوائية (
np.random.randn)، لذا يعطي كل تشغيل شهرا مختلفا من الاستطلاعات. أضفnp.random.seed(0)قبل الخلية التي تنشئcandidate_Aوcandidate_B، فتحصل على الأعداد المعروضة هنا. - تسرد بيانات العيادة كل مريض باسمه الأول. وتستخدم هذه الصفحة المعرفات
P1إلىP12بالترتيب نفسه.
كل شكل في هذه الصفحة ناتج عن تشغيل كود الدفتر.
الجزء 1: Matplotlib على بيانات العيادة
البيانات
زار اثنا عشر مريضا عيادة. ونعرف لكل منهم العمر بالسنوات، والوزن بالكجم، والطول بالسم:
people = ['P1', 'P2', 'P3', 'P4', 'P5', 'P6',
          'P7', 'P8', 'P9', 'P10', 'P11', 'P12']
age = [21, 12, 32, 45, 37, 18, 28, 52, 5, 40, 48, 15]
weight = [55, 35, 77, 68, 70, 60, 72, 69, 18, 65, 82, 48]
height = [160, 135, 170, 165, 173, 168, 175, 159, 105, 171, 155, 158]
هذه قوائم Python عادية: تقبل Matplotlib القوائم ومصفوفات NumPy وأعمدة DataFrame على حد سواء.
أول مخطط انتشار
يرسم مخطط الانتشار نقطة واحدة لكل صف، مع رقم على كل محور. وهو يجيب عن السؤال: هل يتغير هذان الرقمان معا؟
import matplotlib.pyplot as plt

plt.scatter(age, height)
plt.show()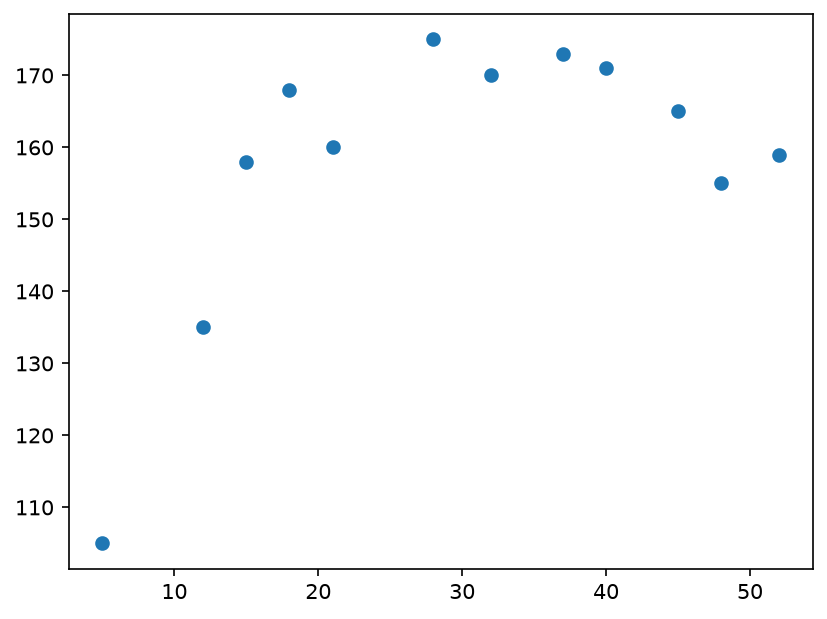
يزداد الطول بسرعة خلال الطفولة ثم يتوقف عن الزيادة: تقع أطوال كل المرضى الذين تزيد أعمارهم على 20 سنة تقريبا بين 155 و175 سم. والنقطة في أسفل اليسار هي P9، طفل عمره 5 سنوات وطوله 105 سم.
إضافة اللمسات الإضافية
المخطط أعلاه صحيح لكنه خال من الإضافات. ويضيف الدفتر، بسطر واحد لكل منها: حجم الشكل (figure)، وعنوانا، وتسميتين للمحورين، وعلامات تدريج مخصصة، وشبكة، ونصا على المخطط، وخطا رأسيا وخطا أفقيا، ومفتاح رسم.
plt.figure(figsize=(8, 6))
plt.title("Plot of Age vs. Height (in cms)\n", fontsize=20, fontstyle='italic')
plt.xlabel("Age (years)", fontsize=16)
plt.ylabel("Height (cms)", fontsize=16)
plt.grid(True)
plt.ylim(100, 200)
plt.xticks([i * 5 for i in range(12)], fontsize=15)
plt.yticks(fontsize=15)
plt.scatter(x=age, y=height, c='orange', s=150, edgecolors='k')
plt.text(x=15, y=105, s="Height increases up to around \n20 years and then tapers off",
         fontsize=15, rotation=30, linespacing=2)
plt.text(x=22, y=185, s="Nobody has a height beyond 180 cm", fontsize=15)
plt.vlines(x=20, ymin=100, ymax=180, linestyles='dashed', color='blue', lw=3)
plt.hlines(y=180, xmin=0, xmax=55, linestyles='dashed', color='red', lw=3)
plt.legend(['Height in cms'], loc=2, fontsize=14)
plt.show()| الاستدعاء | ما يفعله |
|---|---|
plt.figure(figsize=(8, 6)) | شكل جديد بحجم 8 في 6 بوصات |
plt.title وplt.xlabel وplt.ylabel | النصوص المحيطة بالمخطط، مع حجم خطها |
plt.ylim(100, 200) | المدى الظاهر من المحور y |
plt.xticks(list) | مواضع علامات التدريج على المحور x |
plt.scatter(..., c, s, edgecolors) | لون النقطة وحجمها ولون إطارها |
plt.text(x, y, s) | يكتب النص s عند نقطة البيانات (x, y) |
plt.vlines وplt.hlines | قطع مستقيمة رأسية وأفقية |
plt.legend(list, loc=2) | مفتاح رسم في الركن العلوي الأيسر |
مثال محلول: أي علامات تدريج؟
يستقبل plt.xticks([i * 5 for i in range(12)]) القائمة التي يبنيها تعبير بناء القائمة (list comprehension). ويعطي range(12) القيم i = 0, 1, ..., 11، فتكون القائمة i * 5:
[0, 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55]اثنتا عشرة علامة تدريج من 0 إلى 55، علامة كل 5 سنوات، وهذا يغطي أكبر المرضى سنا (52).
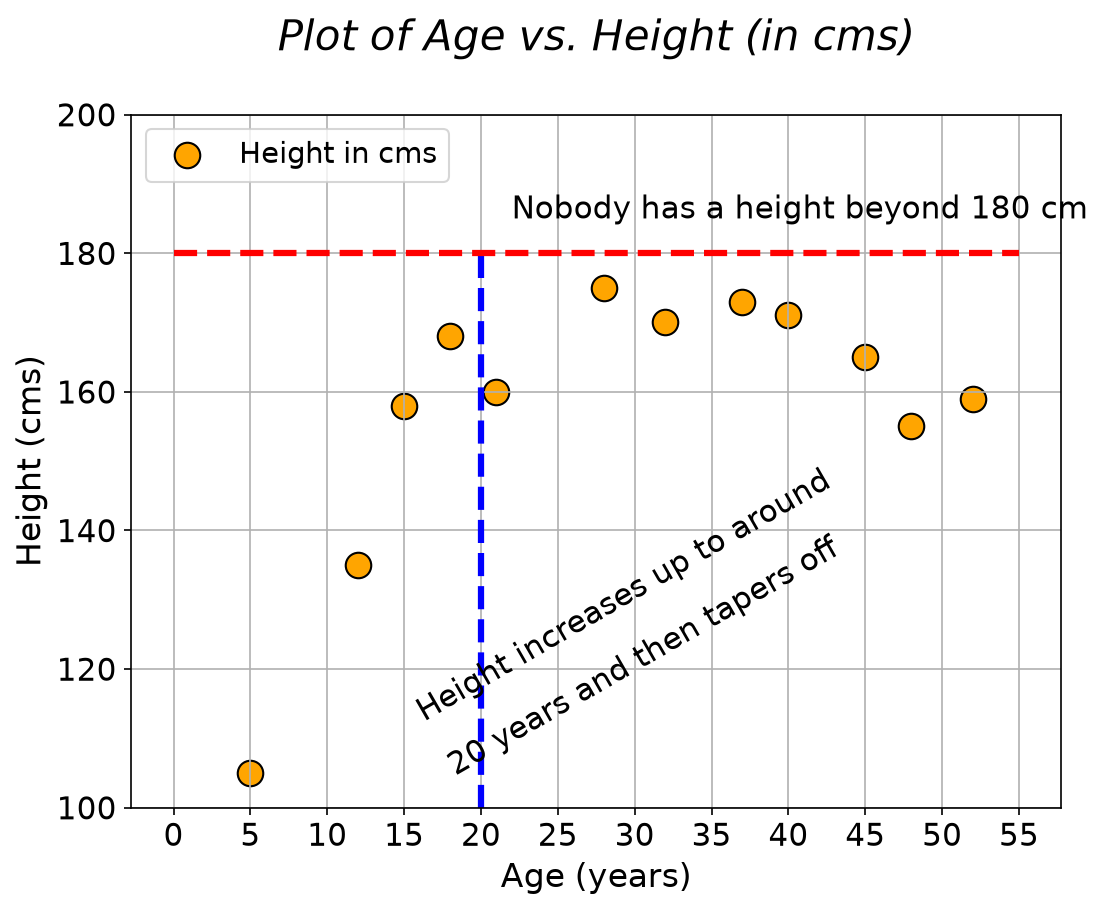
يحدد الخط الأزرق المتقطع عمر 20 سنة، حيث تتوقف الزيادة، ويحدد الخط الأحمر المتقطع 180 سم، وهو طول لا يبلغه أحد. فالنص والخطوط يحولان المخطط إلى حجة.
مخطط الأعمدة
يقارن مخطط الأعمدة رقما واحدا بين عناصر مسماة. يبدأ كل عمود من الصفر، لذا يمكن مقارنة الارتفاعات مباشرة.
plt.figure(figsize=(12, 4))
plt.title("People's weight in kgs", fontsize=16, fontstyle='italic')
plt.bar(x=people, height=weight, width=0.6, color='orange', edgecolor='k', alpha=0.6)
plt.xlabel("People", fontsize=15)
plt.xticks(fontsize=14, rotation=30)
plt.yticks(fontsize=14)
plt.ylabel("Weight (in kgs)", fontsize=15)
plt.show()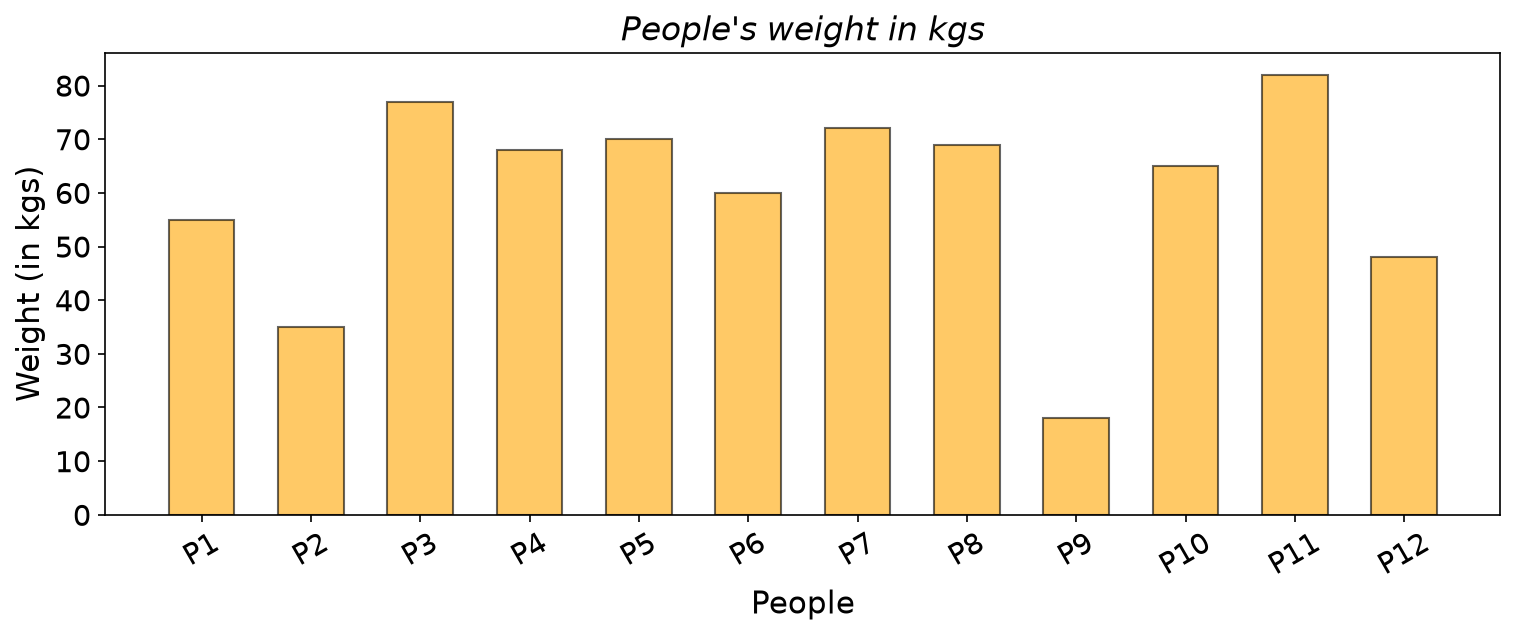
يجعل width=0.6 كل عمود بعرض 60 بالمئة من المساحة المخصصة له، ويجعله alpha=0.6 شفافا جزئيا، ويميل rotation=30 التسميات حتى لا تتداخل. أطول عمود هو P11 (82 كجم) وأقصر عمود هو P9 (18 كجم).
المدرج التكراري
يعرض المدرج التكراري شكل عمود رقمي واحد: فهو يقسم مدى القيم إلى فترات متساوية تسمى الفئات، ويرسم عمودا لكل فئة، ارتفاعه عدد القيم الواقعة داخلها.
plt.figure(figsize=(7, 5))
plt.hist(weight, color='red', edgecolor='k', alpha=0.75, bins=5)
plt.title("Histogram of patient weight", fontsize=18)
plt.xlabel("Weight in kgs", fontsize=15)
plt.show()
مثال محلول: الفئات الخمس للأوزان يدويا
الخطوة 1: عرض الفئة وحوافها. مع bins=5، تقسم Matplotlib المدى من أصغر قيمة (18) إلى أكبر قيمة (82) إلى 5 فئات متساوية:
width = (82 - 18) / 5 = 64 / 5 = 12.8
edges = 18, 30.8, 43.6, 56.4, 69.2, 82
الخطوة 2: العد. تضم كل فئة حافتها اليسرى وتستثني حافتها اليمنى، إلا الفئة الأخيرة التي تضم 82 أيضا.
| الفئة | الأوزان داخلها | العدد |
|---|---|---|
| 18 إلى 30.8 | 18 | 1 |
| 30.8 إلى 43.6 | 35 | 1 |
| 43.6 إلى 56.4 | 55, 48 | 2 |
| 56.4 إلى 69.2 | 68, 60, 69, 65 | 4 |
| 69.2 إلى 82 | 77, 70, 72, 82 | 4 |
مجموع التكرارات 12، واحد لكل مريض. ويعيد plt.hist التكرارات نفسها، [1, 1, 2, 4, 4]، والحواف نفسها.
الخطوة 3: المقارنة مع المخطط.
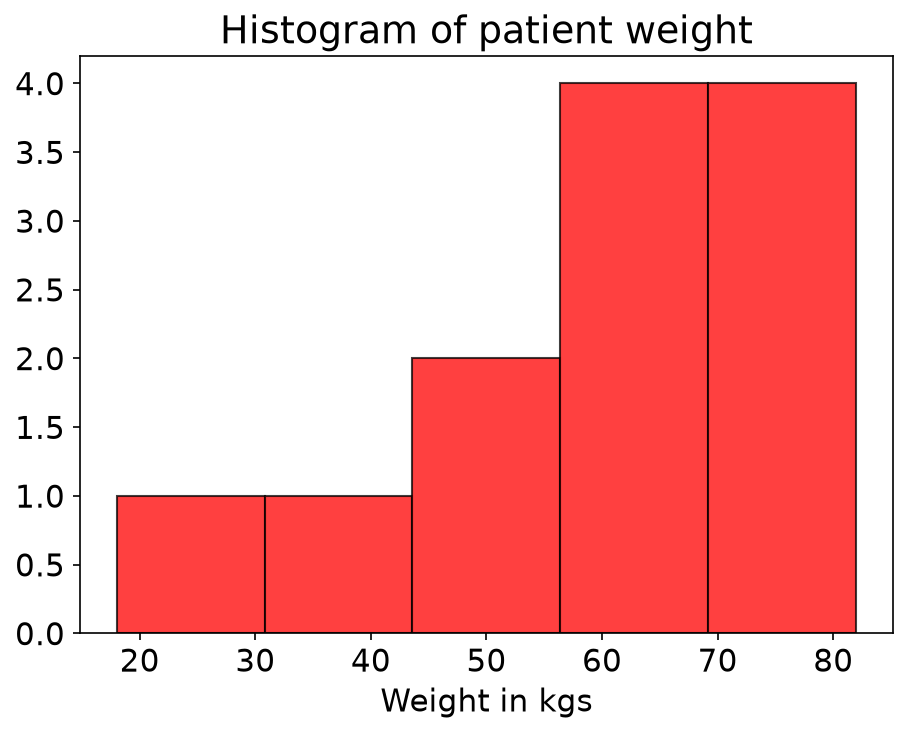
وزن معظم المرضى بين 56.4 و82 كجم؛ والعمودان القصيران على اليسار هما الطفلان.
الجزء 2: بيانات الاستطلاع
شهر من الاستطلاعات
ينشئ الدفتر نتائج استطلاع افتراضية لمدة 30 يوما لمرشحين اثنين. يبدأ المرشح A عند 50 بالمئة ويكسب 0.07 نقطة يوميا؛ ويبدأ المرشح B عند 50 بالمئة ويخسر 0.1 نقطة يوميا. ويضاف تشويش (noise) عشوائي إلى كليهما:
import numpy as np

np.random.seed(0)          # added: makes the random numbers repeatable
days = np.arange(1, 31)
candidate_A = 50 + days * 0.07 + 2 * np.random.randn(30)
candidate_B = 50 - days * 0.1 + 3 * np.random.randn(30)
يولد np.random.randn(30) 30 عددا عشوائيا من التوزيع الطبيعي المعياري (standard normal distribution)؛ والضرب في 2 أو 3 يحدد مقدار التشويش لكل مرشح.
المخطط الخطي
يصل المخطط الخطي كل نقطة بالتي تليها، لذا يناسب البيانات التي لمحورها x ترتيب حقيقي، وهو الزمن غالبا.
ymin = min(candidate_A.min(), candidate_B.min())
ymax = max(candidate_A.max(), candidate_B.max())

plt.style.use('fivethirtyeight')
plt.figure(figsize=(12, 5))
plt.title("Time series plot of poll percentage over a month\n", fontsize=20, fontstyle='italic')
plt.xlabel("Days", fontsize=16)
plt.ylabel("Poll percentage (%)", fontsize=16)
plt.grid(True)
plt.ylim(ymin * 0.98, ymax * 1.02)
plt.xticks([i * 2 for i in range(16)], fontsize=14)
plt.yticks(fontsize=15)
plt.plot(days, candidate_A, 'o-', markersize=10, c='blue', lw=2)
plt.plot(days, candidate_B, '^-', markersize=10, c='green', lw=2)
plt.legend(['Poll percentage of candidate A (%)', 'Poll percentage of candidate B (%)'],
           loc=2, fontsize=14)
plt.show()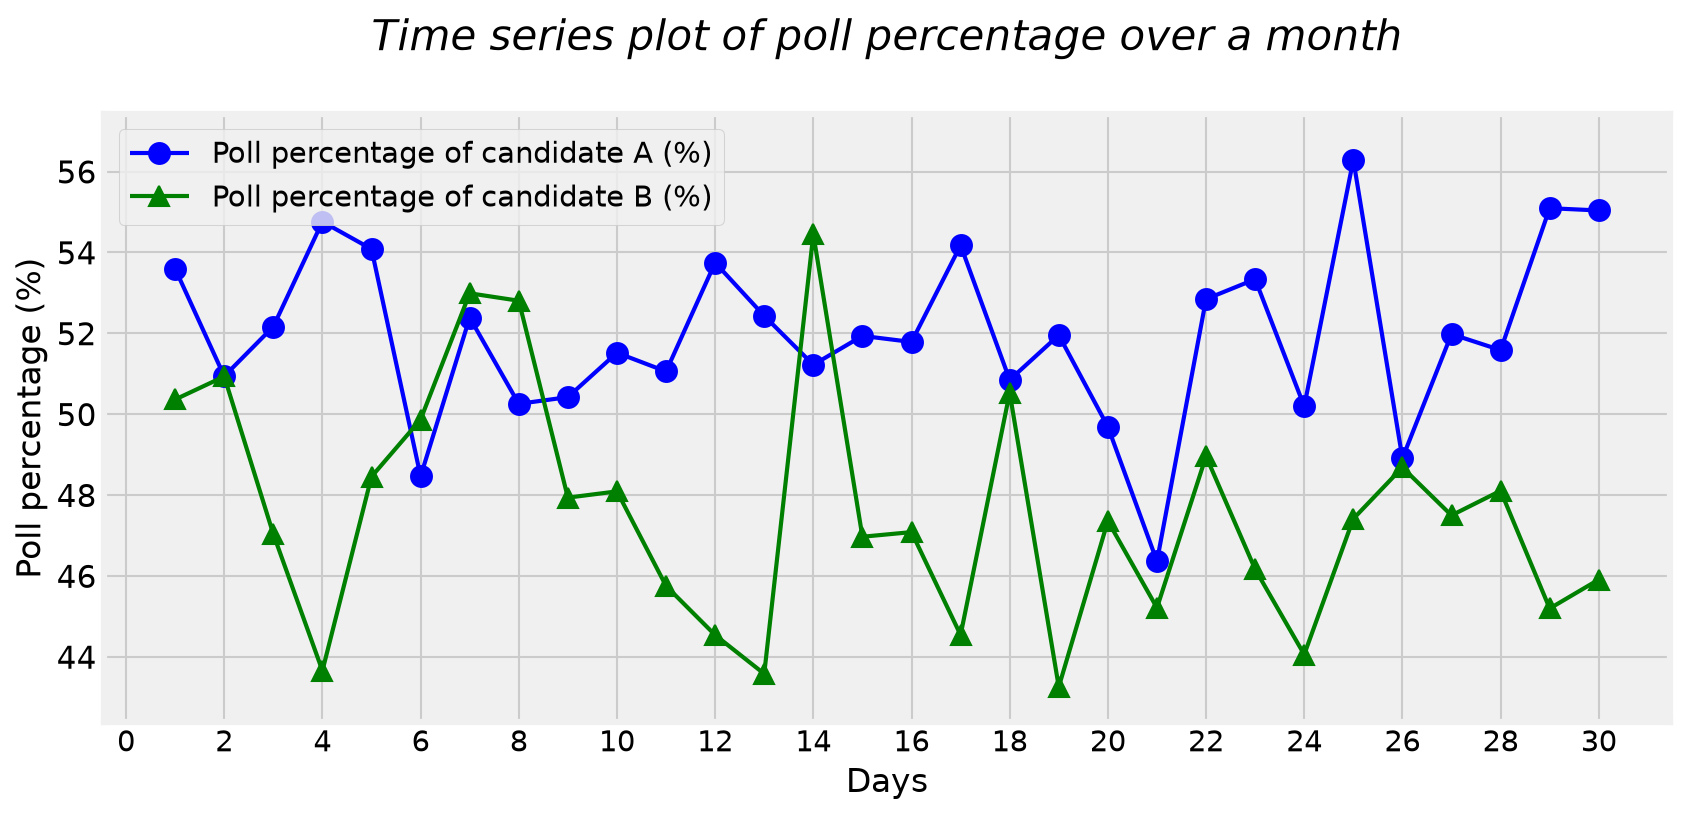
- تعني
'o-'علامات دائرية يصلها خط متصل، وتعني'^-'مثلثات يصلها خط. - يغير
plt.style.use('fivethirtyeight')المظهر كله (الخلفية ونوع الخط والشبكة). ويبقى النمط (style) مفعلا في كل المخططات التالية حتى تغيره. - أصغر قيمة هي
43.258(المرشح B) وأكبرها56.290(المرشح A)، لذا يعرضplt.ylim(ymin * 0.98, ymax * 1.02)المدى من42.393إلى57.415: هامش 2 بالمئة أسفل البيانات وأعلاها. - المرشح A أعلى من المرشح B في 26 يوما من 30؛ ولا يتقدم B إلا في الأيام 6 و7 و8 و14.
المخطط الصندوقي: الفكرة
يلخص المخطط الصندوقي عمودا رقميا واحدا بخمسة أرقام ويحدد القيم غير المعتادة:
- الوسيط هو القيمة الوسطى في البيانات المرتبة. وهو الخط داخل الصندوق.
- الربيع الأول
Q1والربيع الثالثQ3يفصلان الربع الأدنى والربع الأعلى من البيانات. يمتد الصندوق من Q1 إلى Q3، فيضم النصف الأوسط من البيانات. - المدى الربيعي (interquartile range) هو
IQR = Q3 - Q1، أي طول الصندوق. - يقع الحدان (fences) على بعد 1.5 IQR أسفل Q1 و1.5 IQR أعلى Q3. ولا يظهران في الرسم؛ وإنما يحددان ما هو غير معتاد.
- يمتد الشاربان من الصندوق إلى أبعد القيم التي ما زالت داخل الحدين.
- القيم الواقعة خارج أحد الحدين هي القيم الشاذة، وتظهر منفردة على شكل دوائر.
تجد Matplotlib الربيع بالطريقة نفسها التي يتبعها np.percentile: رتب القيم الـn، ورقمها من الموضع 0 إلى n - 1، ثم اذهب إلى الموضع 0.25 (n - 1) لـQ1، و0.5 (n - 1) للوسيط، و0.75 (n - 1) لـQ3. وإذا وقع الموضع بين قيمتين، فخذ تلك النسبة من الفرق بينهما.
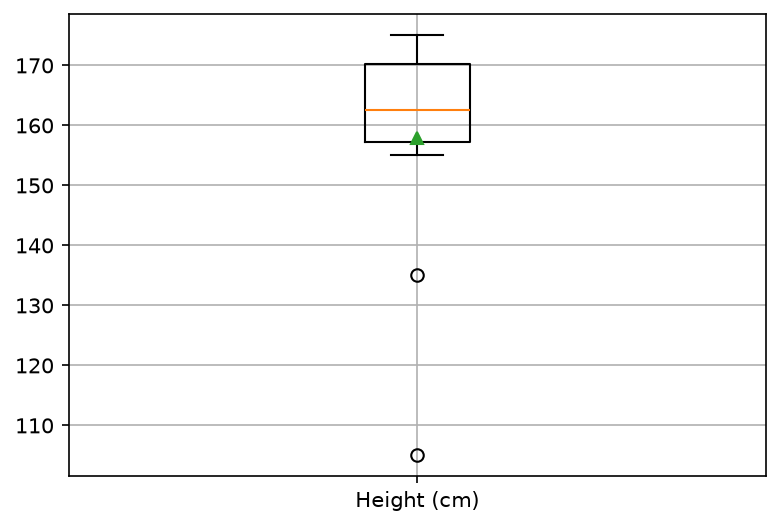
مثال محلول: مخطط صندوقي للأطوال الـ12 يدويا
الخطوة 1: الترتيب وإيجاد الوسيط.
sorted: 105, 135, 155, 158, 159, 160, 165, 168, 170, 171, 173, 175
position:  0    1    2    3    4    5    6    7    8    9   10   11
n = 12، لذا يقع الوسيط عند الموضع 0.5 x 11 = 5.5، في منتصف المسافة بين 160 (الموضع 5) و165 (الموضع 6):
median = 160 + 0.5 x (165 - 160) = 162.5الخطوة 2: الربيعان.
Q1 at position 0.25 x 11 = 2.75:  155 + 0.75 x (158 - 155) = 157.25
Q3 at position 0.75 x 11 = 8.25:  170 + 0.25 x (171 - 170) = 170.25
الخطوة 3: المدى الربيعي والحدان.
IQR = 170.25 - 157.25 = 13
lower fence = 157.25 - 1.5 x 13 = 137.75
upper fence = 170.25 + 1.5 x 13 = 189.75
الخطوة 4: الشاربان والقيم الشاذة والمتوسط.
- يمتد الشارب الأدنى إلى أصغر طول ما زال عند 137.75 أو أعلى منها: 155. ويمتد الشارب الأعلى إلى أكبر طول عند 189.75 أو أدنى منها: 175.
- القيمتان 105 و135 أدنى من الحد الأدنى، فهما قيمتان شاذتان: الطفلان P9 وP2.
- المتوسط (mean) هو
1894 / 12 = 157.83، وهو أقل من الوسيط 162.5: تسحب القيمتان الصغيرتان المتوسط إلى أسفل، بينما يكاد الوسيط لا يتأثر بهما.
يرسم plt.boxplot(x=[height], showmeans=True) هذه الأرقام بالضبط:
لإعادة البناء خطوة بخطوة، افتح أداة بناء المخطط الصندوقي في وضع ملء الشاشة. اضغط زر خطوة لإضافة جزء واحد من الصندوق في كل مرة، واسحب أي نقطة لترى كيف يستجيب الوسيط والربيعان والقيم الشاذة.
المخطط الصندوقي للاستطلاعات في الدفتر
plt.style.use('ggplot')
plt.boxplot(x=[candidate_A, candidate_B], showmeans=True)
plt.grid(True)
plt.xticks([1, 2], ['Candidate A', 'Candidate B'])
plt.show()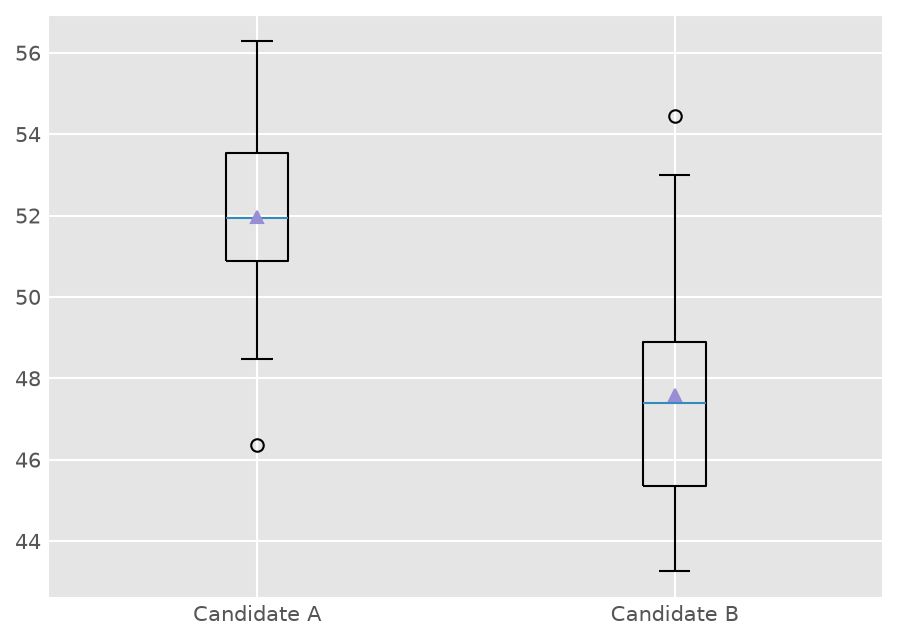
يؤدي تمرير قائمة من مصفوفتين إلى رسم صندوقين متجاورين، ويضع plt.xticks([1, 2], [...]) أسماء مكان أرقام العلامات الافتراضية 1 و2.
| المرشح A | المرشح B | |
|---|---|---|
| الوسيط | 51.947 | 47.389 |
| Q1 إلى Q3 | 50.872 إلى 53.533 | 45.349 إلى 48.892 |
| الشاربان | 48.465 إلى 56.290 | 43.258 إلى 52.991 |
| القيم الشاذة | 46.364 | 54.452 |
| المتوسط (المثلث) | 51.971 | 47.581 |
بالكاد يتداخل الصندوقان: ففي معظم الأيام يحصل المرشح A على نسبة أعلى. أظهر المخطط الخطي الاتجاه عبر الزمن؛ أما المخطط الصندوقي فيهمل الزمن ويقارن التوزيعين.
الجزء 3: pandas وSeaborn على بيانات النبيذ
تحميل البيانات
import pandas as pd

df = pd.read_csv("https://raw.githubusercontent.com/tirthajyoti/"
                 "Stats_data_science_ValleyML/master/Notebooks/Data/wine.data.csv")
df.head()
ينزل الدفتر الملف نفسه باستخدام !wget إلى مجلد Data ثم يقرأ Data/wine.data.csv؛ وقراءة العنوان مباشرة تؤدي العمل نفسه في خطوة واحدة.
قيمة df.shape هي (178, 14): أي 178 عينة نبيذ، وعمود Class بالقيم 1 و2 و3 (59 و71 و48 عينة)، و13 قياسا مثل Alcohol وFlavanoids وColor intensity وProline.
   Class  Alcohol  Malic acid   Ash  Alcalinity of ash
0      1    14.23        1.71  2.43               15.6
1      1    13.20        1.78  2.14               11.2
2      1    13.16        2.36  2.67               18.6
قبل مخططات pandas، يعيد الدفتر ضبط النمط الذي تغير في الجزء 2:
import matplotlib as mpl
mpl.rcParams.update(mpl.rcParamsDefault)
مخططات pandas مباشرة من DataFrame
يستطيع DataFrame أن يرسم نفسه عبر Matplotlib؛ فتسمي الأعمدة بدلا من تمرير القوائم.
df.plot.scatter('Alcohol', 'Color intensity')
plt.show()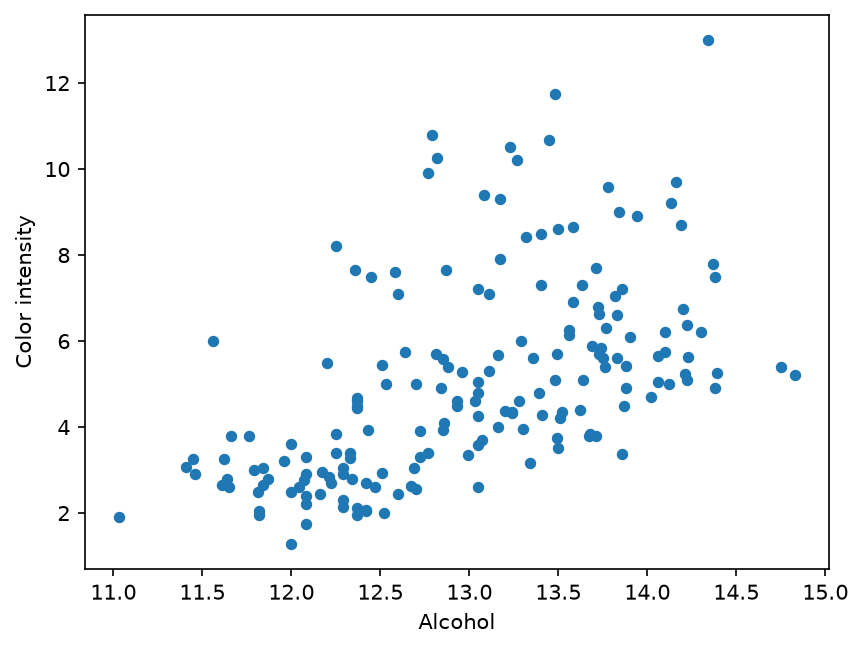
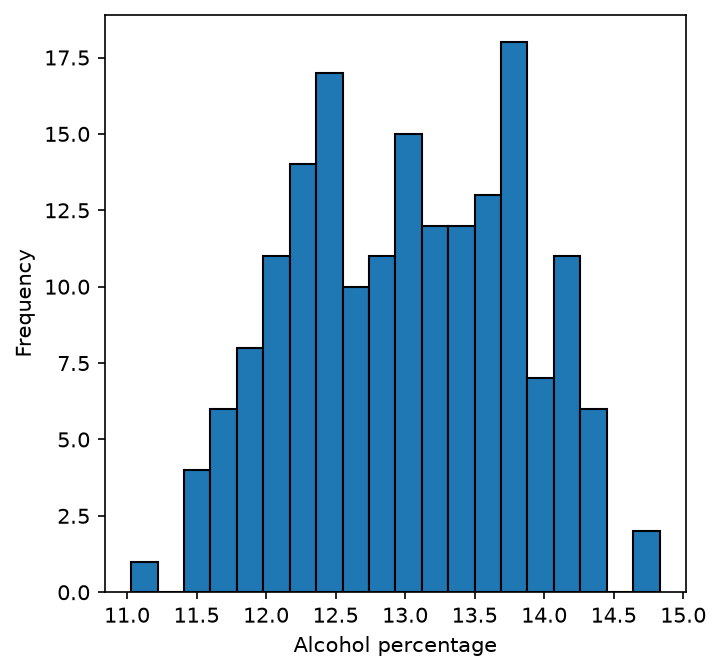
df['Alcohol'].plot.hist(bins=20, figsize=(5, 5), edgecolor='k')
plt.xlabel('Alcohol percentage')
plt.show()
مثال محلول: عرض فئات الكحول الـ20
تمتد قيم الكحول من 11.03 إلى 14.83، وعدد الفئات 20:
width = (14.83 - 11.03) / 20 = 3.80 / 20 = 0.19أطول فئة، من 13.69 إلى 13.88، تضم 18 عينة، ومجموع التكرارات الـ20 هو 178.
Seaborn: مخططات إحصائية في سطر واحد
تعمل Seaborn على DataFrame: تسمي الأعمدة باستخدام x= وy= وdata=، فتتولى هي التجميع والتلوين والتلخيص.
import seaborn as sns

sns.boxplot(x='Class', y='Alcohol', data=df)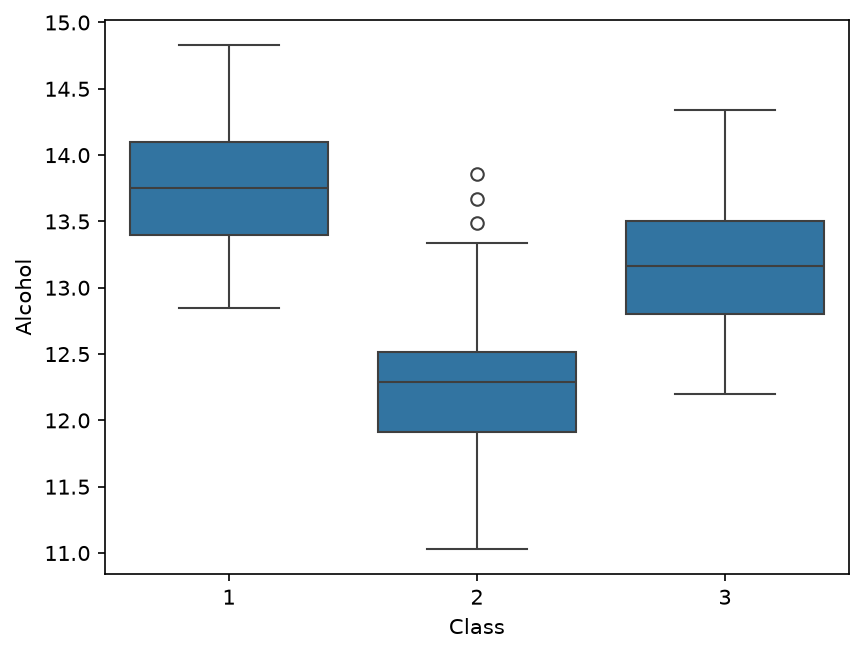
يرسم استدعاء واحد صندوقا لكل صنف. والوسيطات هي 13.75 (الصنف 1) و12.29 (الصنف 2) و13.165 (الصنف 3)، لذا فنبيذ الصنف 1 هو الأعلى كحولا ونبيذ الصنف 2 هو الأقل كحولا. وللصنف 2 ثلاث قيم شاذة فوق شاربه الأعلى: 13.49 و13.67 و13.86.
مخطط الكمان
sns.violinplot(x='Class', y='Alcohol', data=df)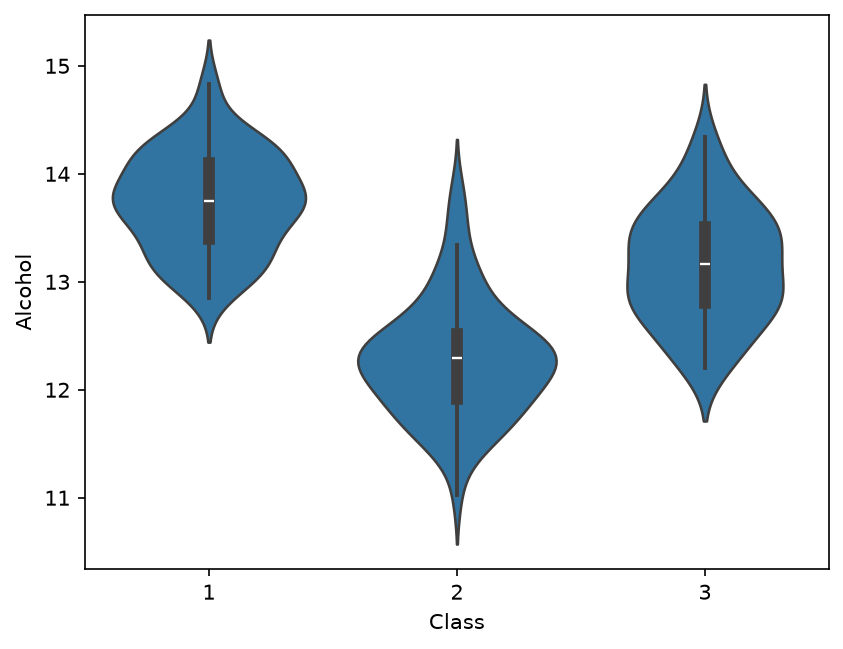
يجمع مخطط الكمان (violin plot) بين المخطط الصندوقي وشكل المدرج التكراري: يدل عرض الكمان عند كل ارتفاع على عدد العينات التي لها تلك القيمة من الكحول، ويعرض الصندوق الصغير في داخله الربيعين. وأوسع جزء في الصنف 2 قرب 12.3، وهذا ما لا يستطيع المخطط الصندوقي العادي إظهاره.
regplot: مخطط انتشار مع خط ملائم
sns.regplot(x='Alcohol', y='Color intensity', data=df)
plt.show()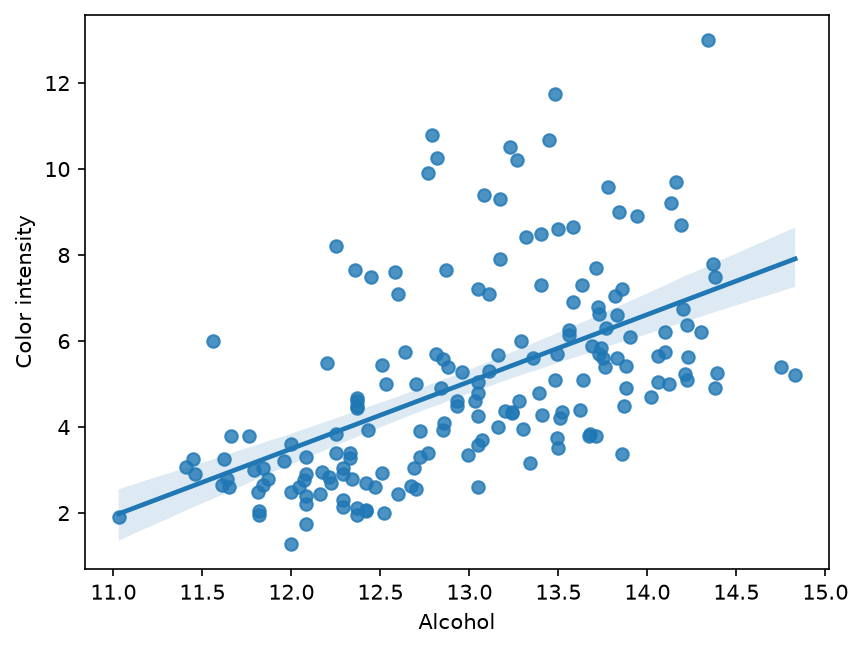
يرسم regplot مخطط الانتشار، والخط المستقيم الذي يلائمه على أفضل وجه، وهو انحدار خطي (linear regression) سندرسه في الأسبوع 3، ونطاقا مظللا هو فترة الثقة (confidence interval) يبين مقدار عدم اليقين في الخط. والخط الملائم هنا هو
Color intensity = 1.560 x Alcohol - 15.226(تأتي الأرقام من np.polyfit(df['Alcohol'], df['Color intensity'], 1)، الذي يحسب الخط نفسه).
مثال محلول: قراءة الخط عند Alcohol = 13
1.560 x 13 - 15.226 = 5.054 (5.057 with the unrounded slope and intercept)من المتوقع أن تكون شدة لون النبيذ الذي نسبة الكحول فيه 13 بالمئة قريبة من 5.05. والميل (slope) موجب: فزيادة الكحول تقترن بزيادة اللون في المتوسط.
lmplot: خط ملائم لكل مجموعة
sns.lmplot(x='Alcohol', y='Color intensity', hue='Class', data=df)
plt.show()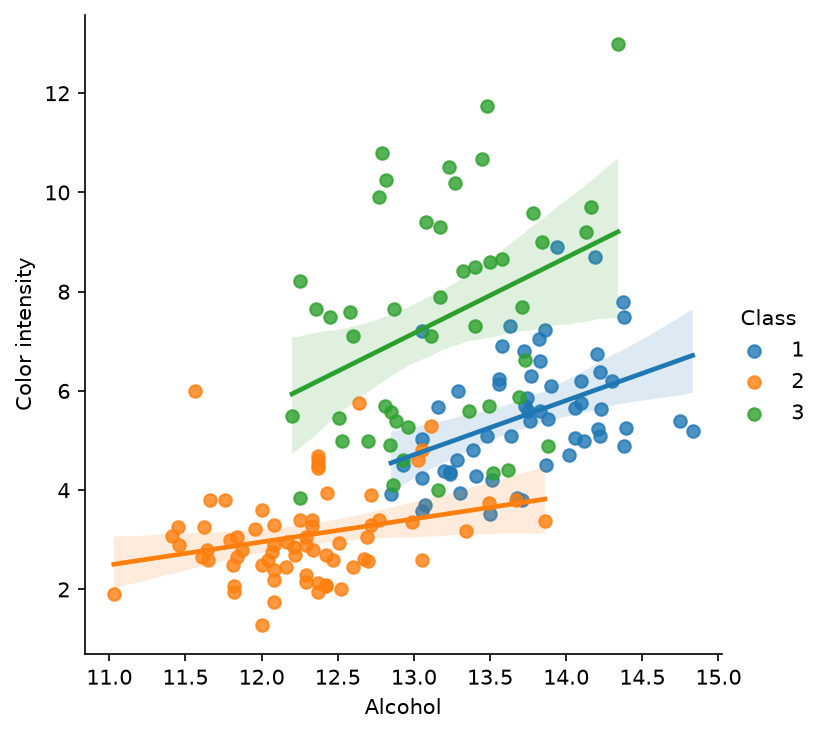
يلون hue='Class' النقاط حسب الصنف ويلائم خطا منفصلا لكل صنف. والميول مختلفة: 1.094 للصنف 1، و0.464 للصنف 2، و1.527 للصنف 3. فالخط الواحد في regplot يخلط ثلاث مجموعات تتصرف بطرق مختلفة.
الجزء 4: الارتباط والخريطة الحرارية
معامل الارتباط
يقيس معامل الارتباط r مدى اقتراب عمودين من اتباع خط مستقيم. وقيمته دائما بين -1 و1:
rقريب من 1: حين يكون أحد العمودين مرتفعا، يميل الآخر إلى الارتفاع.rقريب من -1: حين يكون أحدهما مرتفعا، يميل الآخر إلى الانخفاض.rقريب من 0: لا توجد علاقة خطية مستقيمة.
للعمودين x وy اللذين متوسطاهما mx وmy:
r = sum of (x - mx)(y - my) / square root of ( sum of (x - mx)^2 x sum of (y - my)^2 )مثال محلول: قيمة r لأربعة مرضى
خذ المرضى P1 وP4 وP6 وP10: الأطوال 160 و165 و168 و171 والأوزان 55 و68 و60 و65. والمتوسطان هما mx = 664 / 4 = 166 وmy = 248 / 4 = 62.
الخطوة 1: الانحرافات عن المتوسطين.
| المريض | x - mx | y - my | حاصل الضرب | (x - mx)^2 | (y - my)^2 |
|---|---|---|---|---|---|
| P1 | -6 | -7 | 42 | 36 | 49 |
| P4 | -1 | 6 | -6 | 1 | 36 |
| P6 | 2 | -2 | -4 | 4 | 4 |
| P10 | 5 | 3 | 15 | 25 | 9 |
| المجموع | 47 | 66 | 98 |
الخطوة 2: التعويض في صيغة r.
r = 47 / square root of (66 x 98) = 47 / 80.424 = 0.584يطبع np.corrcoef([160, 165, 168, 171], [55, 68, 60, 65])[0, 1] القيمة 0.5844. فالعلاقة موجبة لكنها غير محكمة. وعلى المرضى الـ12 كلهم يعطي الطول والوزن r = 0.848: مع أربع نقاط فقط، يغير مريض واحد الإجابة كثيرا (P4 أقصر من المتوسط لكنه أثقل).
مصفوفة الارتباط لبيانات النبيذ
corr_mat = np.corrcoef(df, rowvar=False)
corr_mat.shape                 # (14, 14)
corr_df = pd.DataFrame(corr_mat, columns=df.columns, index=df.columns)
يخبر rowvar=False مكتبة NumPy أن المتغيرات هي الأعمدة وليست الصفوف. ومع 14 عمودا توجد 14 x 14 = 196 قيمة لـr: القطر كله 1 (كل عمود مع نفسه)، والمصفوفة متماثلة، لأن r بين a وb يساوي r بين b وa. ويطبع print(np.round(corr_mat, 3)) المصفوفة كلها؛ ويضم صفها الأول ارتباطات Class مع كل عمود:
[ 1.    -0.328  0.438 -0.05   0.518 -0.209 -0.719 -0.847  0.489 -0.499
  0.266 -0.617 -0.788 -0.634]
الخريطة الحرارية
sns.heatmap(corr_df, linewidth=1, cmap='plasma')
plt.show()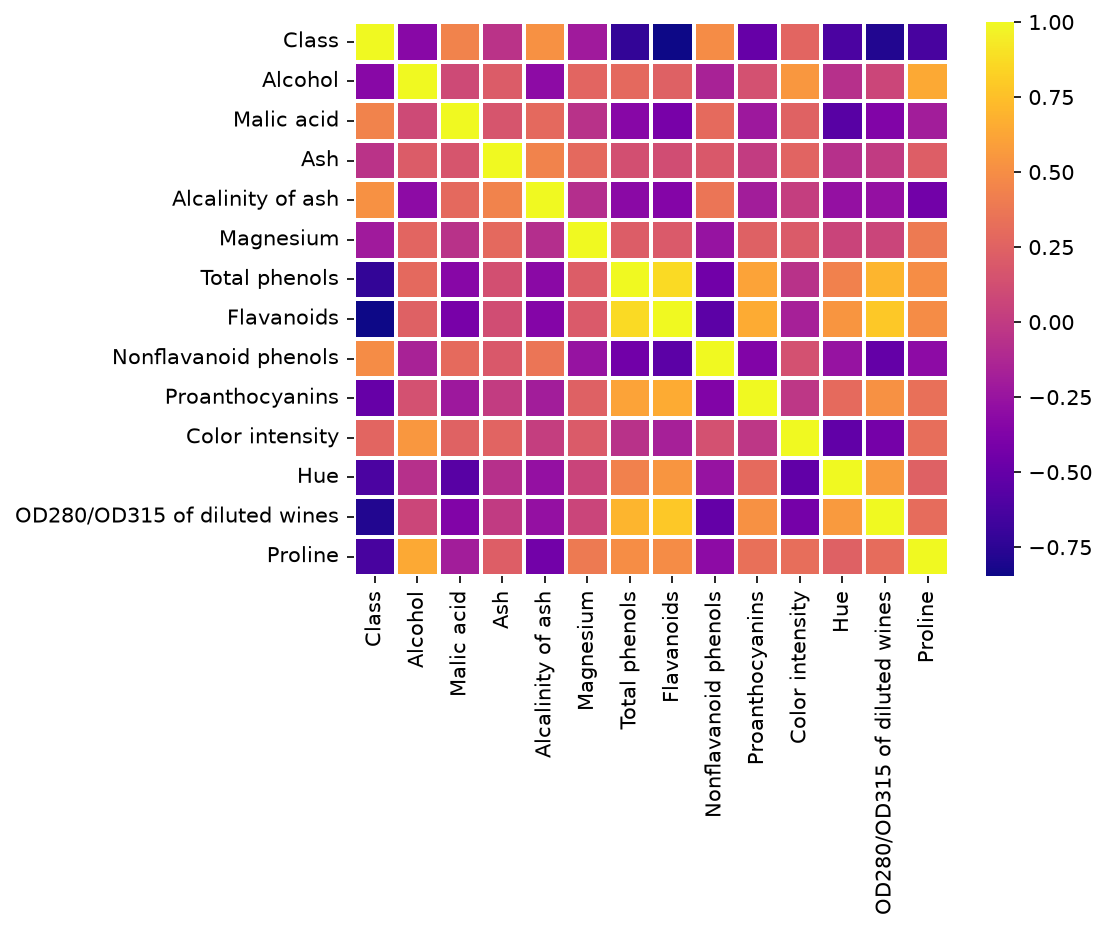
تلون الخريطة الحرارية كل خلية من المصفوفة. ومع cmap='plasma'، يعني الأصفر أن r قريب من 1، ويعني الأزرق الداكن أكثر القيم سلبية.
مثال محلول: قراءة الخريطة الحرارية
- أي قياس أكثر ارتباطا بـ
Class؟ أغمق خلية في صفClassهيFlavanoids، حيث r = -0.847: نبيذ الصنف 1 فيه أكبر كمية من الفلافانويدات ونبيذ الصنف 3 فيه أقلها. ويليهOD280/OD315 of diluted wines(-0.788) ثمTotal phenols(-0.719). - أي قياسين أكثر ارتباطا أحدهما بالآخر؟
Total phenolsوFlavanoids، حيث r = 0.865، وهي ألمع خلية خارج القطر. - أي زوج أقل ارتباطا؟
AshوOD280/OD315 of diluted wines، حيث r = 0.004.
العمود Class تسمية مرمزة بالقيم 1 و2 و3. والارتباط معه لا يقول إلا هل تميل العينات ذات رقم الصنف الأكبر إلى قيم أكبر أو أصغر من قياس ما؛ وهذا يصلح هنا لأن الأصناف الثلاثة مرتبة مصادفة على امتداد Flavanoids.
اختيار المخطط
| سؤالك | المخطط | في الدفتر |
|---|---|---|
| هل يتغير رقمان معا؟ | مخطط الانتشار، regplot | العمر مقابل الطول، والكحول مقابل اللون |
| كيف يتغير رقم واحد عبر الزمن؟ | المخطط الخطي | الاستطلاعات على مدى 30 يوما |
| كيف تتقارن عناصر مسماة في رقم واحد؟ | مخطط الأعمدة | الوزن لكل مريض |
| ما شكل عمود واحد؟ | المدرج التكراري | الأوزان، والكحول |
| كيف تختلف المجموعات في التشتت والقيم الشاذة؟ | المخطط الصندوقي، مخطط الكمان | المرشحان، والكحول لكل صنف |
| أي الأعمدة الكثيرة مرتبط بعضها ببعض؟ | الخريطة الحرارية للارتباط | أعمدة النبيذ الـ14 |
يمكن رسم البيانات نفسها بطرق كثيرة، وليست كل طريقة منطقية: المخطط الخطي عبر المرضى الـ12 يصل بين أشخاص لا علاقة بينهم، لأن المرضى ليس لهم ترتيب. افتح أداة اختيار المخطط في وضع ملء الشاشة، وبدل بين المخططات الستة على بيانات العيادة والاستطلاع والنبيذ، وغير عدد الفئات والتلوين، واقرأ متى يناسب كل مخطط.
الأخطاء الشائعة
- استخدام مخطط خطي لصفوف ليس لها ترتيب؛ استخدم بدلا منه مخطط انتشار أو مخطط أعمدة.
- الحكم على مدرج تكراري دون تجربة أعداد أخرى من الفئات: الفئات القليلة جدا تخفي الشكل، والكثيرة جدا تحوله إلى تشويش.
- نسيان أن
plt.style.useيبقى مفعلا في كل المخططات التالية؛ أعد ضبطه باستخدامmpl.rcParams.update(mpl.rcParamsDefault). - تسمية دوائر المخطط الصندوقي أخطاء. فهي مجرد قيم تتجاوز 1.5 IQR؛ افحصها قبل حذف أي شيء.
- فهم r = 0 على أنه غياب تام للعلاقة: فمعامل r لا يقيس إلا العلاقات الخطية المستقيمة.
- معاملة الارتباط على أنه سبب: فقد يتغير عمودان معا لأن كليهما يتبع عمودا ثالثا.
مرحلة المشروع: مقترح المشروع أو الورقة البحثية
في هذا الأسبوع يكتب كل فريق مقترحه. ومخططات هذا القسم تجعله ملموسا:
- اعرض الفكرة، أو الورقة البحثية التي ستعيد إنتاج نتائجها، في جملتين أو ثلاث.
- حدد مجموعة البيانات: مصدرها، وعدد صفوفها وأعمدتها، وأي عمود هو الهدف (target).
- حملها باستخدام pandas وارسم مدرجا تكراريا للهدف، أو مخطط أعمدة لأصنافه.
- ارسم مخططا صندوقيا أو مخطط انتشار للهدف مقابل العمود الذي تتوقع أنه الأهم.
- ارسم الخريطة الحرارية للارتباط ودون أقوى العلاقات التي تراها.
- ضع المخططات في المقترح مع جملة واحدة تحت كل منها تقول ما يعرضه.
في الأسبوع القادم تستمر المرحلة مع استكشاف البيانات وتنظيفها، بدءا من هذه المخططات.
الخلاصة
- تبني Matplotlib الشكل استدعاء بعد استدعاء: البيانات أولا، ثم العنوان والتسميات وعلامات التدريج والشبكة والنص والخطوط ومفتاح الرسم.
- يقسم المدرج التكراري المدى إلى فئات متساوية؛ وعدد الفئات يغير ما تراه.
- يعرض المخطط الصندوقي الوسيط والربيعين، والشاربين حتى 1.5 IQR، والقيم الشاذة خارجهما.
- ترسم pandas وSeaborn من أعمدة DataFrame بأسمائها؛ وتجمع Seaborn البيانات حسب عمود باستخدام
x=أوhue=. - يقيس r العلاقة الخطية المستقيمة بين -1 و1؛ وتعرض الخريطة الحرارية لمصفوفة الارتباط كل الأزواج دفعة واحدة.
- اختر المخطط انطلاقا من السؤال: تغير عبر الزمن، أو مقارنة، أو شكل، أو تشتت، أو علاقة.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: مدرج تكراري يدويا (نحو 7 دقائق)
لعشرة زوار هذه الأعمار: 12, 15, 21, 22, 26, 30, 31, 33, 38, 44. عند استدعاء plt.hist(ages, bins=4):
- احسب عرض الفئة والحواف الخمس للفئات.
- عد القيم في كل فئة.
التمرين 2: مخطط صندوقي يدويا (نحو 8 دقائق)
عشر قيم: 48, 52, 55, 57, 58, 60, 61, 63, 66, 95. عند استدعاء plt.boxplot(x=[values], showmeans=True)، أوجد الوسيط وQ1 وQ3 والمدى الربيعي والحدين وطرفي الشاربين والقيم الشاذة والمتوسط.
التمرين 3: قيمة r يدويا (نحو 5 دقائق)
احسب r للقيم x = [1, 2, 3, 4] وy = [2, 4, 5, 9].
التمرين 4: في Colab، على بيانات النبيذ (نحو 10 دقائق)
- ارسم
sns.boxplot(x='Class', y='Flavanoids', data=df). أي صنف له أعلى وسيط؟ وأي الصناديق تظهر فيها قيم شاذة؟ - ارسم
df['Proline'].plot.hist(bins=10). كم عينة في أطول فئة، وما حافتاها؟ (استخدمnp.histogram(df['Proline'], bins=10)لقراءة الأرقام الدقيقة.) - ارسم
sns.regplot(x='Total phenols', y='Flavanoids', data=df). هل الميل موجب أم سالب؟ احسب r باستخدامnp.corrcoef. - ارسم الخريطة الحرارية لأربعة أعمدة فقط:
cols = ['Class', 'Alcohol', 'Flavanoids', 'Proline']، ثمnp.corrcoef(df[cols], rowvar=False). أي زوج له أكبر قيمة مطلقة لـr؟
الإجابات
الإجابة 1
- العرض:
(44 - 12) / 4 = 32 / 4 = 8. الحواف:12, 20, 28, 36, 44. - التكرارات:
| الفئة | القيم | العدد |
|---|---|---|
| 12 إلى 20 | 12, 15 | 2 |
| 20 إلى 28 | 21, 22, 26 | 3 |
| 28 إلى 36 | 30, 31, 33 | 3 |
| 36 إلى 44 | 38, 44 | 2 |
تضم الفئة الأخيرة 44. ويعيد np.histogram(ages, bins=4) القيم [2, 3, 3, 2] والحواف نفسها.
الإجابة 2
n = 10، لذا تمتد المواضع من 0 إلى 9.
- الوسيط عند الموضع
0.5 x 9 = 4.5:58 + 0.5 x (60 - 58) = 59. - Q1 عند الموضع
0.25 x 9 = 2.25:55 + 0.25 x (57 - 55) = 55.5. - Q3 عند الموضع
0.75 x 9 = 6.75:61 + 0.75 x (63 - 61) = 62.5. - المدى الربيعي:
62.5 - 55.5 = 7. الحدان:55.5 - 10.5 = 45و62.5 + 10.5 = 73. - الشاربان: من 48 (أصغر قيمة عند 45 أو أعلى منها) إلى 66 (أكبر قيمة عند 73 أو أدنى منها).
- القيمة الشاذة: 95.
- المتوسط:
615 / 10 = 61.5، وهو أعلى من الوسيط 59: فالقيمة الشاذة تسحبه إلى أعلى.
الإجابة 3
- المتوسطان:
mx = 10 / 4 = 2.5، وmy = 20 / 4 = 5. - الانحرافات: تعطي x القيم
-1.5, -0.5, 0.5, 1.5؛ وتعطي y القيم-3, -1, 0, 4. - مجموع حواصل الضرب:
4.5 + 0.5 + 0 + 6 = 11. ومجموعا المربعات:2.25 + 0.25 + 0.25 + 2.25 = 5و9 + 1 + 0 + 16 = 26. r = 11 / square root of (5 x 26) = 11 / 11.402 = 0.965.
علاقة موجبة قوية: يعطي np.corrcoef القيمة 0.9648.
الإجابة 4
- وسيطات
Flavanoidsهي 2.98 (الصنف 1) و2.03 (الصنف 2) و0.685 (الصنف 3)، لذا فأعلاها الصنف 1. وللصنف 2 قيمة شاذة واحدة في الأعلى (5.08)، وللصنف 3 قيمة شاذة واحدة في الأعلى (1.57)؛ وليس للصنف 1 أي قيمة شاذة. - تضم أطول فئة 41 عينة، بين 558.4 و698.6. والتكرارات العشرة هي
22, 37, 41, 19, 13, 19, 8, 13, 4, 2. - الميل موجب: الخط الملائم هو
Flavanoids = 1.380 x Total phenols - 1.138، وr = 0.865. - مصفوفة الأعمدة الأربعة، مقربة إلى ثلاث منازل عشرية:
| Class | Alcohol | Flavanoids | Proline | |
|---|---|---|---|---|
| Class | 1 | -0.328 | -0.847 | -0.634 |
| Alcohol | -0.328 | 1 | 0.237 | 0.644 |
| Flavanoids | -0.847 | 0.237 | 1 | 0.494 |
| Proline | -0.634 | 0.644 | 0.494 | 1 |
أكبرها قيمة مطلقة هو Class وFlavanoids، r = -0.847، وهي الخلية نفسها في الخريطة الحرارية الكاملة ذات الأعمدة الـ14: فحذف أعمدة لا يغير r للأعمدة الباقية.