Logo
تعلم الآلة (2026-2027) - تصوير البيانات باستخدام Matplotlib وSeaborn

في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.

تعلم الآلة، الأسبوع 2

تصوير البيانات باستخدام Matplotlib وSeaborn

انظر إلى البيانات قبل أن تبني نموذجها: المخططات التي يستخدمها كل دفتر في المقرر، ومتى يناسب كل منها.

الأهداف

  • رسم مخططات الانتشار (scatter) والأعمدة (bar) والمدرج التكراري (histogram) والخطي (line) والصندوقي (box) باستخدام Matplotlib، مع العناوين وتسميات المحاور (labels) وعلامات التدريج (ticks) ومفاتيح الرسم (legends)
  • حساب فئات (bins) المدرج التكراري وأجزاء المخطط الصندوقي (boxplot) يدويا
  • الرسم مباشرة من DataFrame باستخدام df.plot.scatter وdf.plot.hist
  • مقارنة المجموعات باستخدام Seaborn: boxplot وviolinplot وregplot وlmplot
  • حساب معامل الارتباط (correlation) r وقراءة الخريطة الحرارية (heatmap) للارتباط
  • اختيار المخطط الذي يناسب السؤال، واستخدامه في مقترحك

الأسبوع 2 من الخطة

موقع الدرس من المقرر

  • الدفتر (notebook): Matplotlib_Seaborn_basics، على ثلاث مجموعات بيانات صغيرة
  • سيناريو من الواقع: تتركه الخطة مفتوحا هذا الأسبوع، لذا نستخدم مواقف الدفتر نفسه: مرضى العيادة، وشهرا من الاستطلاعات، و178 عينة نبيذ
  • مرحلة المشروع (project milestone) هذا الأسبوع: مقترح المشروع أو الورقة البحثية (Project/Paper Proposal)

خطة الساعتين

الجزءما نفعلهالزمن
1Matplotlib على بيانات العيادة، ومدرج تكراري يدويا30 دقيقة
2بيانات الاستطلاع: مخطط خطي، ومخطط صندوقي يدويا20 دقيقة
3pandas وSeaborn على بيانات النبيذ20 دقيقة
4الارتباط، والخريطة الحرارية، واختيار المخطط15 دقيقة
5تمارين مع الإجابات، ثم الخلاصة35 دقيقة

افتح الدفتر في Colab

text
https://colab.research.google.com/github/
tirthajyoti/Machine-Learning-with-Python/blob/master/
Pandas%20and%20Numpy/Matplotlib_Seaborn_basics.ipynb
اجمع الأسطر الثلاثة في عنوان واحد، أو اضغط رابط Colab في صفحة الدرس.

الجزء 1

Matplotlib على بيانات العيادة

شكل واحد، يبنى استدعاء بعد استدعاء

بيانات العيادة

اثنا عشر مريضا: العمر بالسنوات، والوزن بالكجم، والطول بالسم

python
people = ['P1', 'P2', 'P3', 'P4', 'P5', 'P6',
          'P7', 'P8', 'P9', 'P10', 'P11', 'P12']
age    = [21, 12, 32, 45, 37, 18,
          28, 52, 5, 40, 48, 15]
weight = [55, 35, 77, 68, 70, 60,
          72, 69, 18, 65, 82, 48]
height = [160, 135, 170, 165, 173, 168,
          175, 159, 105, 171, 155, 158]
  • قوائم Python عادية، قيمة واحدة لكل مريض، بالترتيب نفسه
  • تقبل Matplotlib القوائم ومصفوفات NumPy وأعمدة DataFrame على حد سواء
  • السؤال: هل توجد علاقة بين هذه الخصائص؟

أول مخطط انتشار

  • نقطة واحدة لكل مريض: العمر على x، والطول على y
python
import matplotlib.pyplot as plt

plt.scatter(age, height)
plt.show()
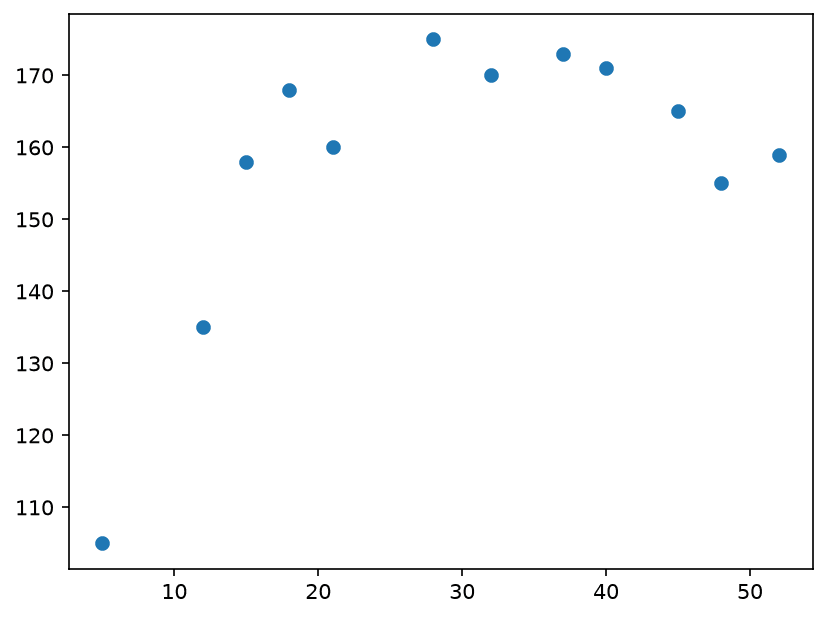
مخطط انتشار للعمر مقابل الطول للمرضى الـ12

اللمسات الإضافية

كل استدعاء إضافي يضيف عنصرا واحدا إلى الشكل نفسه

الاستدعاءما يضيفه
plt.figure(figsize=(8, 6))حجم الشكل بالبوصات
plt.title وplt.xlabel وplt.ylabelالنصوص المحيطة بالمخطط
plt.ylim(100, 200)المدى الظاهر من y
plt.xticks(list)مواضع علامات التدريج على x
الاستدعاءما يضيفه
plt.scatter(c=, s=, edgecolors=)لون النقطة وحجمها ولون إطارها
plt.text(x, y, s)نص عند نقطة بيانات
plt.vlines وplt.hlinesخطوط رأسية وأفقية
plt.legend(list, loc=2)مفتاح رسم، أعلى اليسار

مثال محلول: أي علامات تدريج؟

python
plt.xticks([i * 5 for i in range(12)],
           fontsize=15)
text
[0, 5, 10, 15, 20, 25, 30, 35, 40, 45, 50, 55]
يعطي range(12) القيم i = 0 إلى 11، مضروبة في 5: اثنتا عشرة علامة تدريج حتى 55.
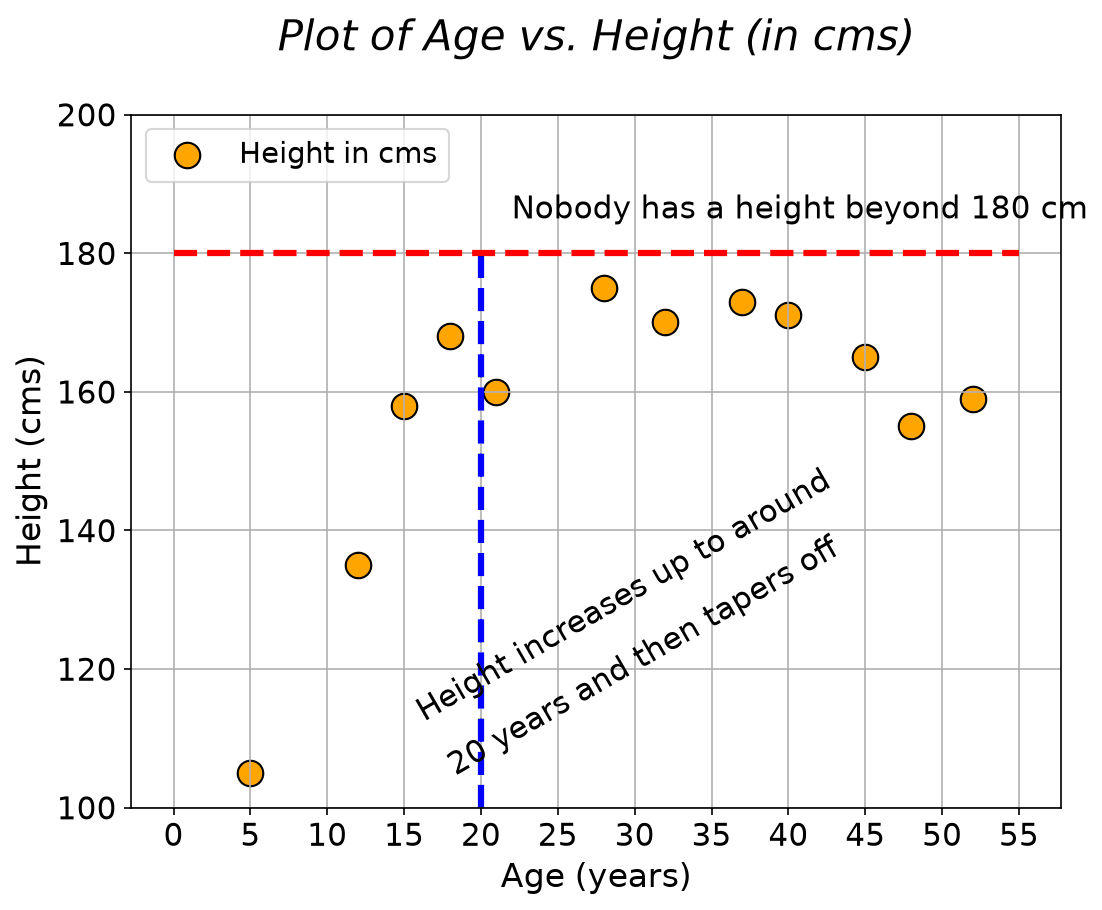
مخطط الانتشار بعد التنسيق مع العنوان والشبكة والنص والخطوط المتقطعة ومفتاح الرسم

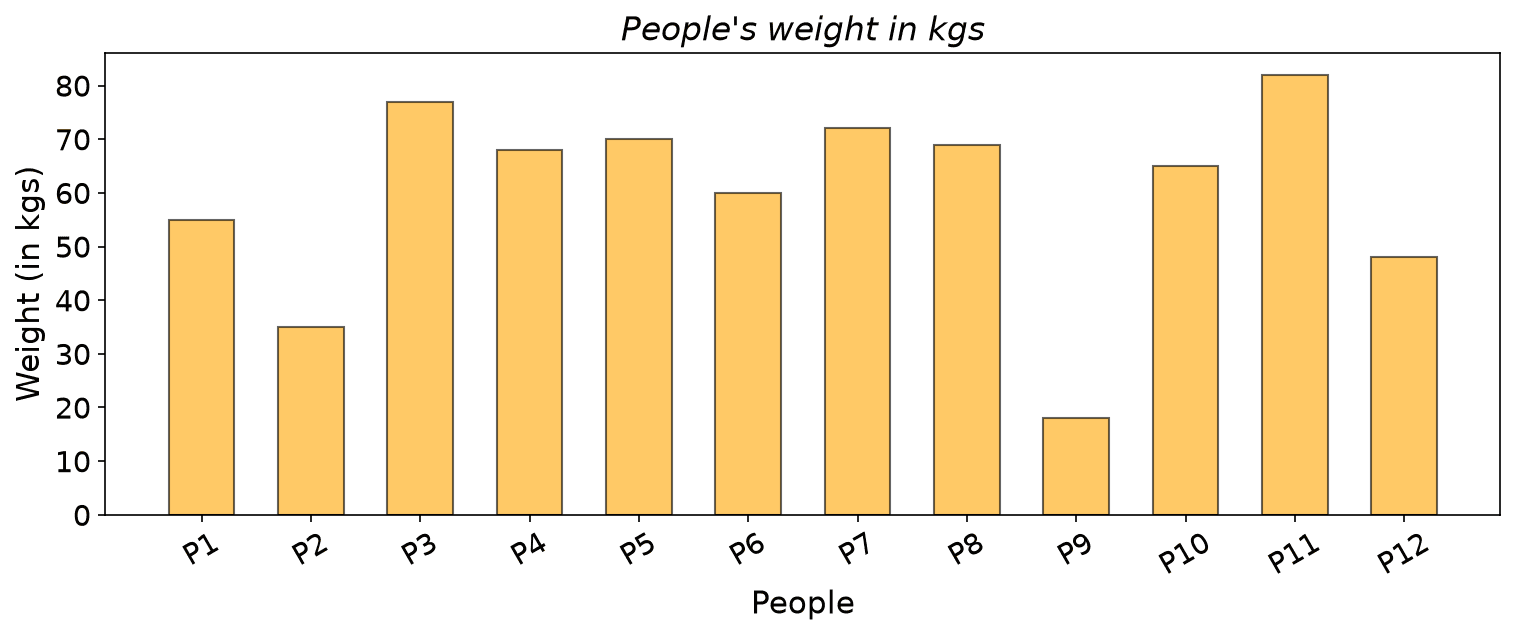
مخطط الأعمدة

مقارنة رقم واحد بين عناصر مسماة؛ ويبدأ كل عمود من الصفر

python
plt.figure(figsize=(12, 4))
plt.bar(x=people, height=weight,
        width=0.6, color='orange',
        edgecolor='k', alpha=0.6)
plt.xticks(fontsize=14, rotation=30)
plt.show()
  • width=0.6: يملأ كل عمود 60% من المساحة المخصصة له
  • alpha=0.6: شفافية جزئية
  • rotation=30: تسميات مائلة
مخطط أعمدة لوزن كل مريض

الخطوة 1 من 3

مثال محلول: فئات المدرج التكراري

python
plt.hist(weight, color='red', edgecolor='k', alpha=0.75, bins=5)
w = 82 − 185 = 645 = 12.8

الخطوة 2 من 3

الخطوة 2: عد القيم في كل فئة

تضم الفئة حافتها اليسرى دون اليمنى؛ والفئة الأخيرة تضم 82 أيضا

الفئةالأوزان داخلهاالعدد
18 إلى 30.8181
30.8 إلى 43.6351
43.6 إلى 56.455, 482
56.4 إلى 69.268, 60, 69, 654
69.2 إلى 8277, 70, 72, 824

الخطوة 3 من 3

الخطوة 3: المقارنة مع المخطط

  • مجموع التكرارات 1, 1, 2, 4, 4 هو 12، واحد لكل مريض
  • يعيد plt.hist التكرارات والحواف نفسها
  • العمودان القصيران على اليسار هما الطفلان
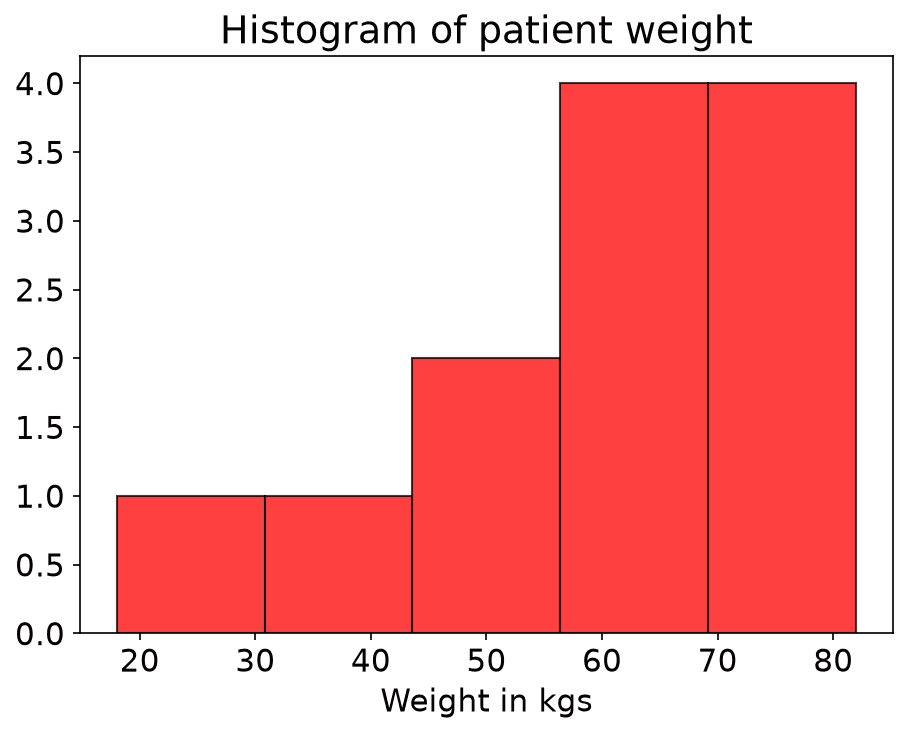
مدرج تكراري للأوزان الـ12 مع 5 فئات

الجزء 2

بيانات الاستطلاع

خط عبر الزمن، وصندوق حول التشتت

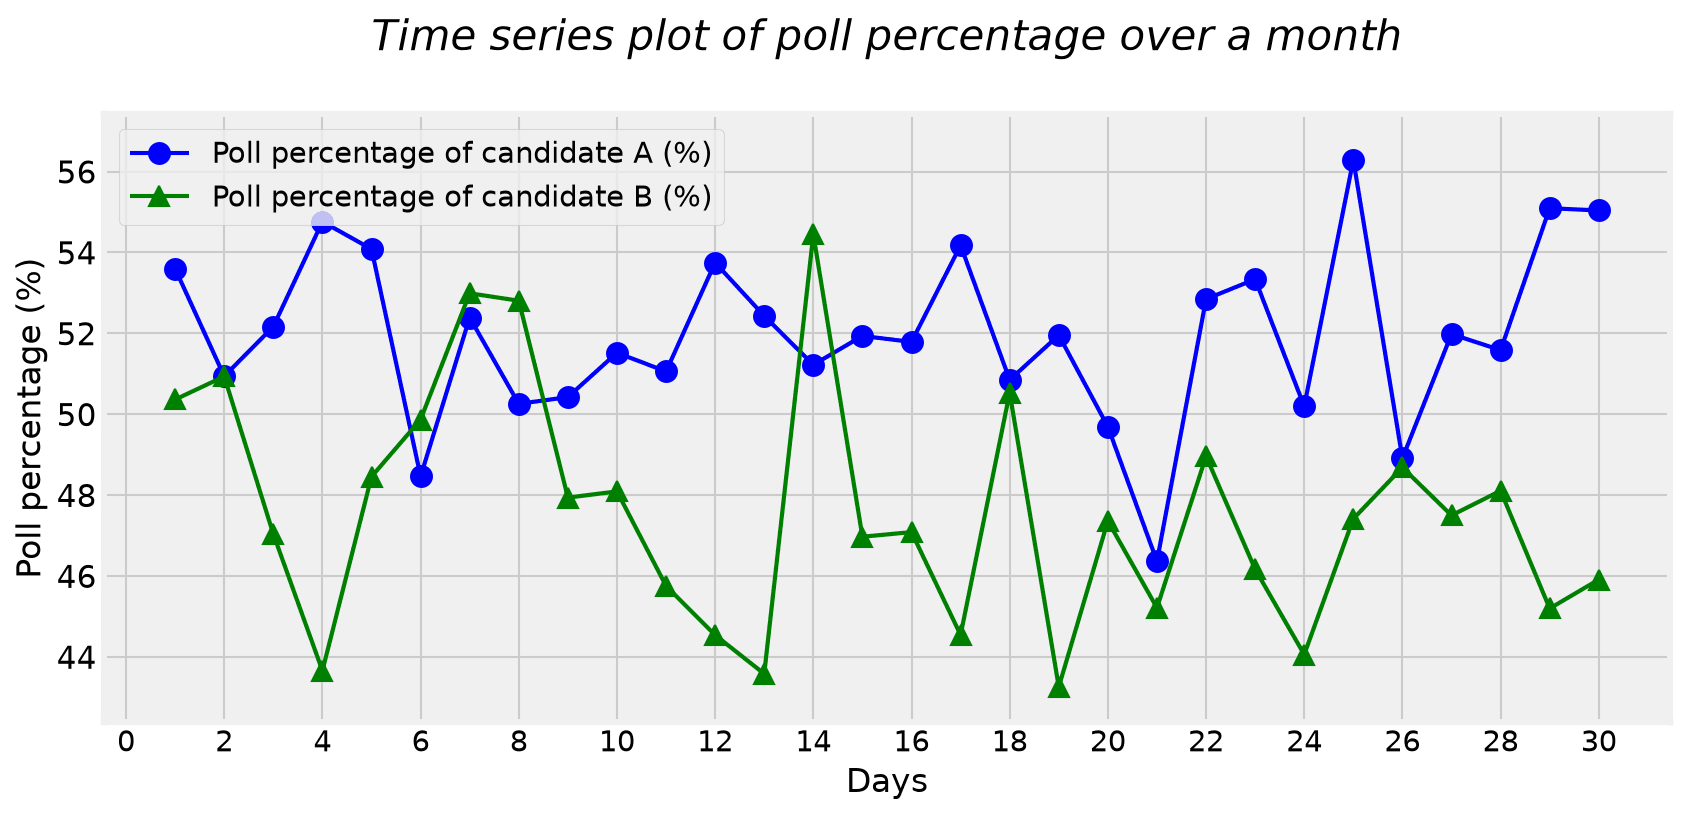
شهر من الاستطلاعات في صورة خطوط

python
np.random.seed(0)   # added
days = np.arange(1, 31)
candidate_A = 50 + days * 0.07 \
              + 2 * np.random.randn(30)
candidate_B = 50 - days * 0.1 \
              + 3 * np.random.randn(30)

plt.style.use('fivethirtyeight')
plt.plot(days, candidate_A, 'o-', c='blue')
plt.plot(days, candidate_B, '^-', c='green')
  • A: +0.07 يوميا، وB: -0.1 يوميا، مع تشويش (noise) عشوائي
  • يبقى plt.style.use مفعلا في كل المخططات التالية
مخطط خطي للمرشحين على مدى 30 يوما

أجزاء المخطط الصندوقي

  • الوسيط (median): منتصف القيم المرتبة، وهو الخط داخل الصندوق
  • Q1 وQ3: الربيعان (quartiles)؛ ويضم الصندوق النصف الأوسط
  • IQR = Q3 - Q1، المدى الربيعي (interquartile range)، أي طول الصندوق
  • الحدان (fences) على بعد 1.5 IQR خارج الصندوق يحددان ما هو غير معتاد
  • الشاربان (whiskers) يصلان إلى أبعد القيم داخل الحدين؛ وتظهر القيم الشاذة (outliers) خارجهما دوائر

الخطوة 1 من 5

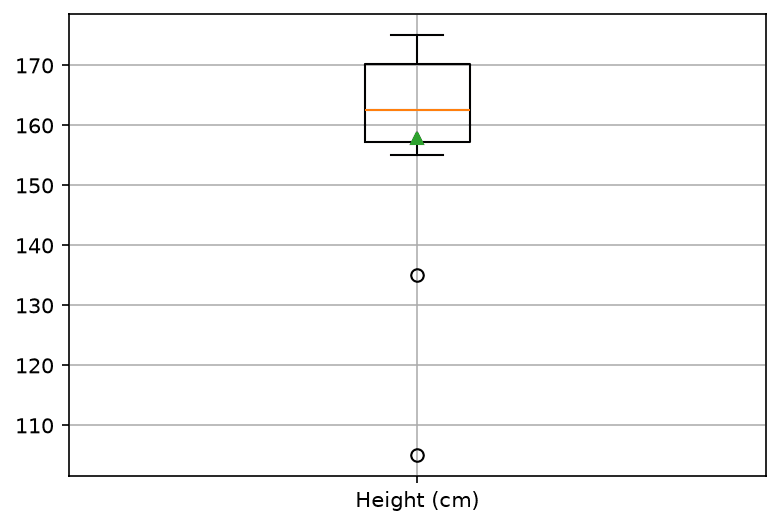
مثال محلول: صندوق الأطوال الـ12

رتب، ثم أوجد الوسيط

text
sorted:   105 135 155 158 159 160 165 168 170 171 173 175
position:   0   1   2   3   4   5   6   7   8   9  10  11
p = 0.5 (n − 1) = 0.5 × 11 = 5.5
Q2 = 160 + 0.5 × (165 − 160) = 162.5

الخطوة 2 من 5

الخطوة 2: الربيعان Q1 وQ3

Q1 = 155 + 0.75 × (158 − 155) = 157.25
Q3 = 170 + 0.25 × (171 − 170) = 170.25

الخطوة 3 من 5

الخطوة 3: المدى الربيعي والحدان

Q3 − Q1 = 170.25 − 157.25 = 13
Q1 − 1.5 × 13 = 137.75 Q3 + 1.5 × 13 = 189.75

الخطوة 4 من 5

الخطوة 4: الشاربان والقيم الشاذة

الحدان: 137.75 و189.75

الجزءالقيمةالسبب
الشارب الأدنى155أصغر طول عند 137.75 أو أعلى
الشارب الأعلى175أكبر طول عند 189.75 أو أدنى
القيم الشاذة105, 135أدنى من الحد الأدنى: P9 وP2، الطفلان

الخطوة 5 من 5

الخطوة 5: المتوسط، ثم التحقق

python
plt.boxplot(x=[height], showmeans=True)
μ = 189412 ≈ 157.83
مخطط صندوقي للأطوال الـ12 فيه قيمتان شاذتان والمتوسط على شكل مثلث

جرب بنفسك: ابن المخطط الصندوقي خطوة بخطوة

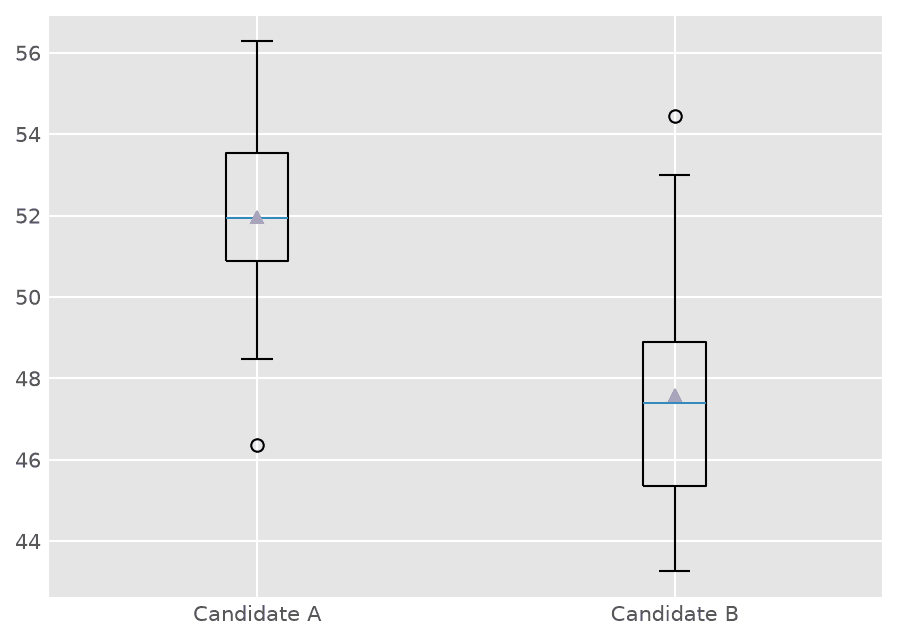
المخطط الصندوقي للاستطلاعات في الدفتر

python
plt.style.use('ggplot')
plt.boxplot(x=[candidate_A, candidate_B],
            showmeans=True)
plt.xticks([1, 2], ['Candidate A', 'Candidate B'])
AB
الوسيط51.94747.389
Q1 إلى Q350.87 إلى 53.5345.35 إلى 48.89
القيمة الشاذة46.36454.452
المتوسط51.97147.581
مخططان صندوقيان متجاوران للمرشحين

الجزء 3

pandas وSeaborn على بيانات النبيذ

سم الأعمدة، ودع المكتبة تتولى الباقي

تحميل بيانات النبيذ

python
df = pd.read_csv("https://raw.githubusercontent.com/tirthajyoti/"
                 "Stats_data_science_ValleyML/master/Notebooks/Data/wine.data.csv")
df.head()
  • قيمة df.shape هي (178, 14): 178 عينة نبيذ، و14 عمودا
  • يأخذ Class القيم 1 و2 و3 (59 و71 و48 عينة)
  • 13 قياسا، مثل Alcohol وFlavanoids وColor intensity وProline

مخططات pandas مباشرة من DataFrame

python
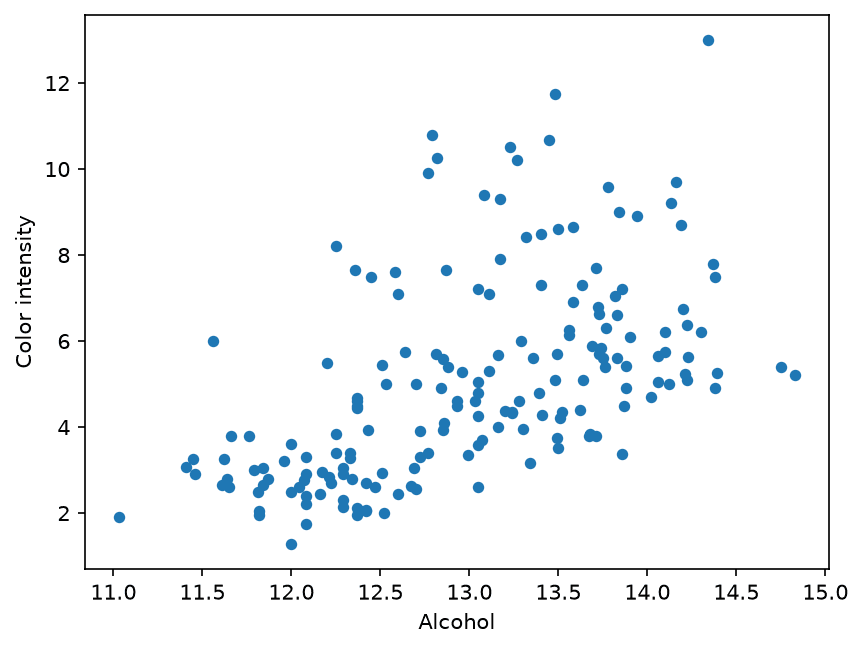
df.plot.scatter('Alcohol', 'Color intensity')
plt.show()
  • سم الأعمدة؛ لا حاجة إلى تمرير قوائم
  • تستدعي pandas مكتبة Matplotlib نيابة عنك، لذا تظل plt.xlabel وأمثالها تعمل
  • كل نقطة عينة نبيذ واحدة
مخطط انتشار من pandas للعمود Alcohol مقابل Color intensity

مثال محلول: 20 فئة للكحول

python
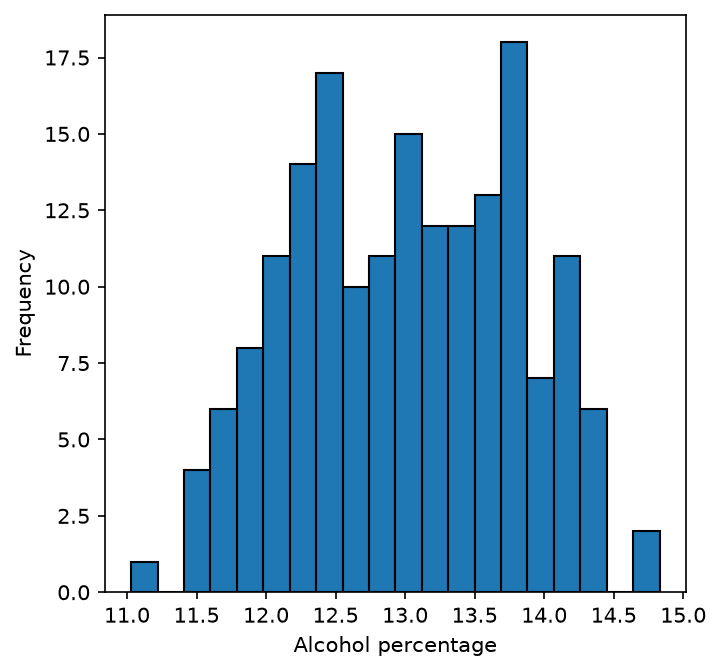
df['Alcohol'].plot.hist(bins=20, figsize=(5, 5),
                         edgecolor='k')
w = 14.83 − 11.0320 = 3.8020 = 0.19
مدرج تكراري للعمود Alcohol مع 20 فئة

Seaborn: صندوق لكل صنف

python
import seaborn as sns

sns.boxplot(x='Class', y='Alcohol', data=df)
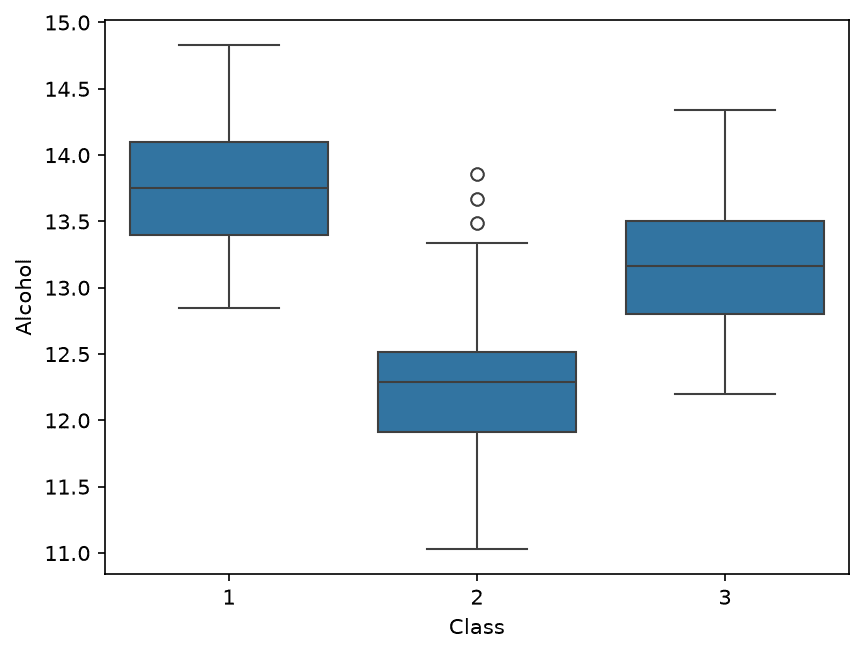
مخططات صندوقية من Seaborn للعمود Alcohol لكل صنف

مخطط الكمان

python
sns.violinplot(x='Class', y='Alcohol', data=df)
مخطط الكمان (violin plot)
مخطط صندوقي مضافا إليه شكل التوزيع: يدل العرض عند كل ارتفاع على عدد العينات التي لها تلك القيمة.
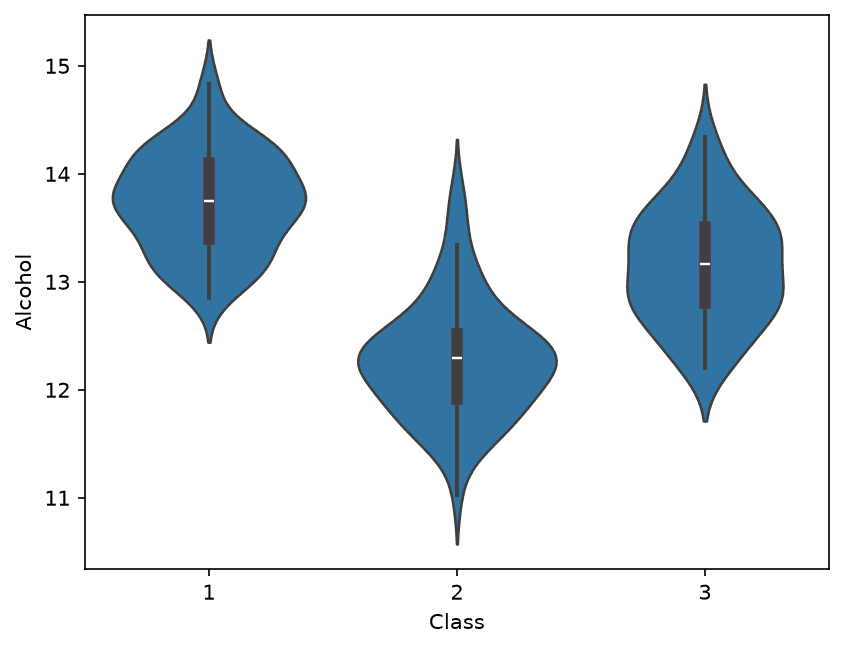
مخططات الكمان من Seaborn للعمود Alcohol لكل صنف

regplot: مخطط انتشار مع خط ملائم

python
sns.regplot(x='Alcohol', y='Color intensity',
            data=df)
  • الخط الذي يلائم النقاط على أفضل وجه: انحدار خطي (linear regression)، موضوع الأسبوع القادم
  • النطاق المظلل هو فترة الثقة (confidence interval): مقدار عدم اليقين في الخط
  • الخط الملائم هنا: الميل (slope) 1.560، والمقطع (intercept) -15.226
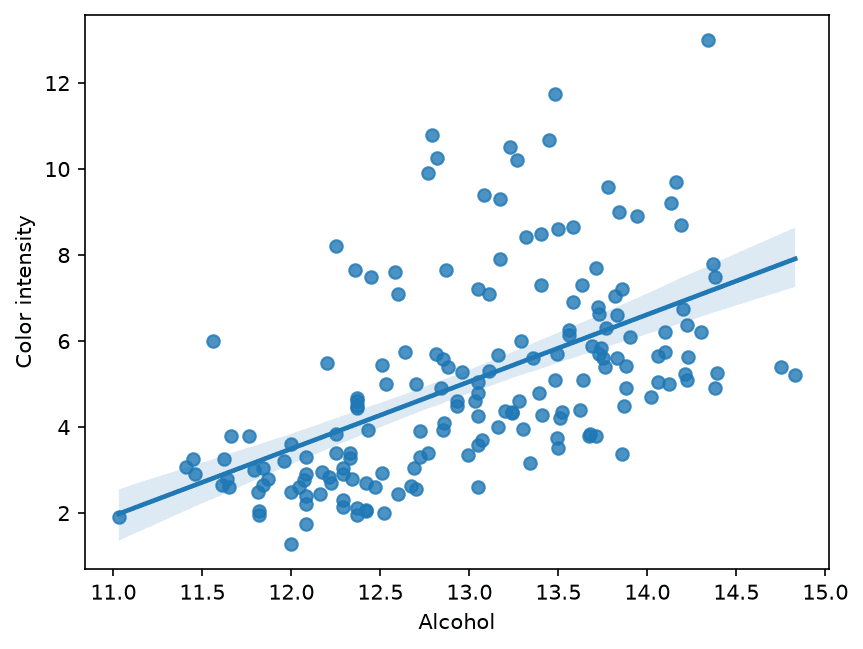
مخطط regplot من Seaborn للعمود Alcohol مقابل Color intensity مع خط انحدار

مثال محلول: قراءة الخط عند نسبة كحول 13

ŷ = 1.560 x − 15.226
ŷ = 1.560 × 13 − 15.226 ≈ 5.05

lmplot: خط لكل مجموعة

python
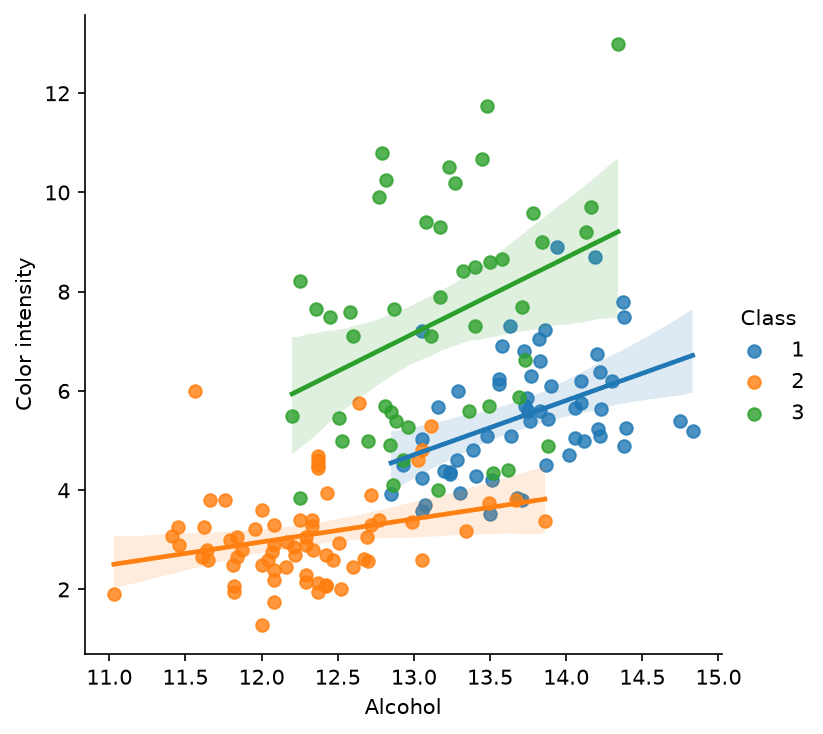
sns.lmplot(x='Alcohol', y='Color intensity',
           hue='Class', data=df)
  • يلون hue='Class' النقاط حسب الصنف ويلائم خطا لكل صنف
الصنفالميل
11.094
20.464
31.527
مخطط lmplot من Seaborn مع خط انحدار لكل صنف

الجزء 4

الارتباط والخريطة الحرارية

كل زوج من الأعمدة في صورة واحدة

معامل الارتباط r

r = ∑ (x − μx)(y − μy)√(∑ (x − μx)2 × ∑ (y − μy)2)
  • r قريب من 1: القيم المرتفعة من x تقترن بقيم مرتفعة من y
  • r قريب من -1: القيم المرتفعة من x تقترن بقيم منخفضة من y
  • r قريب من 0: لا علاقة خطية مستقيمة

الخطوة 1 من 2

مثال محلول: قيمة r لأربعة مرضى

P1 وP4 وP6 وP10: الأطوال 160 و165 و168 و171 والأوزان 55 و68 و60 و65

المريضالانحرافاتحاصل الضربالمربعات
P1-6, -74236, 49
P4-1, 6-61, 36
P62, -2-44, 4
P105, 31525, 9
المجموع4766, 98

الخطوة 2 من 2

الخطوة 2: التعويض في صيغة r

r = 47√(66 × 98) = 4780.424 ≈ 0.584

مصفوفة الارتباط وخريطتها الحرارية

python
corr_mat = np.corrcoef(df, rowvar=False)
corr_mat.shape      # (14, 14)
corr_df = pd.DataFrame(corr_mat,
    columns=df.columns, index=df.columns)
sns.heatmap(corr_df, linewidth=1,
            cmap='plasma')
  • rowvar=False: المتغيرات هي الأعمدة
  • 14 x 14 = 196 قيمة لـr
  • القطر كله 1؛ والمصفوفة متماثلة
  • الأصفر: r قريب من 1؛ والأزرق الداكن: الأكثر سلبية
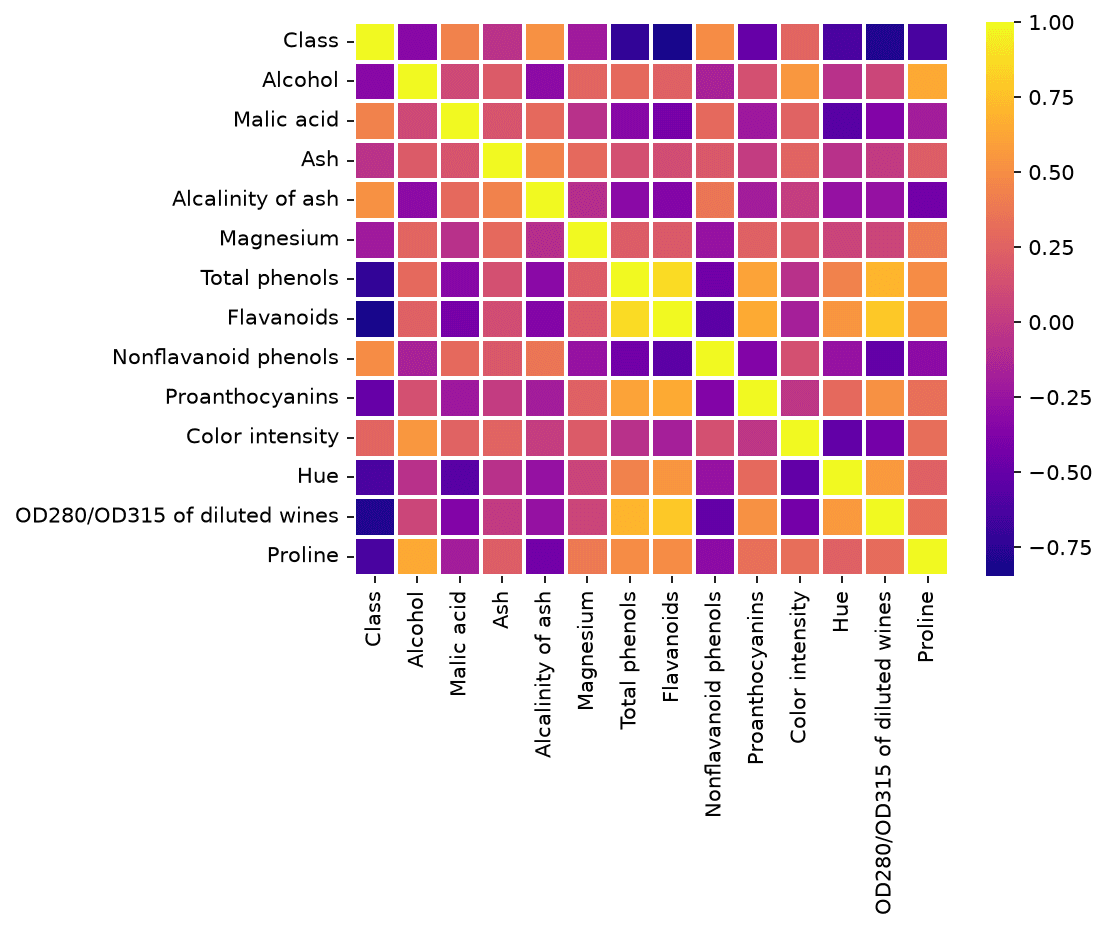
خريطة حرارية لمصفوفة الارتباط 14 في 14 لبيانات النبيذ

مثال محلول: قراءة الخريطة الحرارية

السؤالالإجابةr
الأكثر ارتباطا بـClassFlavanoids-0.847
التاليانOD280/OD315 وTotal phenols-0.788, -0.719
الزوج الأكثر ارتباطاTotal phenols وFlavanoids0.865
الزوج الأقل ارتباطاAsh وOD280/OD3150.004

اختيار المخطط

السؤالالمخطط
هل يتغير رقمان معا؟الانتشار، regplot
كيف يتغير رقم عبر الزمن؟الخطي
كيف تتقارن عناصر مسماة؟الأعمدة
السؤالالمخطط
ما شكل عمود واحد؟المدرج التكراري
كيف تختلف المجموعات في التشتت؟الصندوقي، الكمان
أي الأعمدة الكثيرة مرتبط بعضها ببعض؟الخريطة الحرارية

جرب بنفسك: أداة اختيار المخطط

الأخطاء الشائعة

  • مخطط خطي عبر صفوف ليس لها ترتيب، مثل المرضى الـ12
  • الحكم على مدرج تكراري بعدد فئات واحد فقط
  • نسيان أن plt.style.use يبقى مفعلا في المخططات التالية
  • حذف القيم الشاذة في المخطط الصندوقي دون فحصها: فهي مجرد قيم تتجاوز 1.5 IQR
  • فهم r = 0 على أنه غياب للعلاقة: فمعامل r لا يرى إلا العلاقات الخطية المستقيمة
  • معاملة الارتباط على أنه سبب

مرحلة المشروع: مقترح المشروع أو الورقة البحثية

  1. اعرض الفكرة، أو الورقة البحثية التي ستعيد إنتاج نتائجها، في جملتين أو ثلاث
  2. حدد مجموعة البيانات (dataset): المصدر، والصفوف، والأعمدة، وعمود الهدف (target)
  3. ارسم مدرجا تكراريا للهدف، أو مخطط أعمدة لأصنافه
  4. ارسم مخططا صندوقيا أو مخطط انتشار للهدف مقابل العمود الذي تتوقع أنه الأهم
  5. ارسم الخريطة الحرارية للارتباط ودون أقوى العلاقات
  6. ضع المخططات في المقترح، مع جملة واحدة تحت كل منها

التمارين

التمارين: دورك

نحو 30 دقيقة

نحو 7 دقائق

التمرين 1: مدرج تكراري يدويا

w = 44 − 124 = 8
الفئةالقيمالعدد
12 إلى 2012, 152
20 إلى 2821, 22, 263
28 إلى 3630, 31, 333
36 إلى 4438, 442

نحو 8 دقائق

التمرين 2: مخطط صندوقي يدويا

الجزءالموضعالقيمة
Q10.25 x 9 = 2.2555 + 0.25 x 2 = 55.5
الوسيط0.5 x 9 = 4.558 + 0.5 x 2 = 59
Q30.75 x 9 = 6.7561 + 0.75 x 2 = 62.5

نحو 5 دقائق

التمرين 3: قيمة r يدويا

∑ (x − μx)(y − μy) = 4.5 + 0.5 + 0 + 6 = 11
r = 11√(5 × 26) = 1111.402 ≈ 0.965

نحو 10 دقائق

التمرين 4: في Colab، على بيانات النبيذ

  1. sns.boxplot(x='Class', y='Flavanoids', data=df): أي صنف له أعلى وسيط؟ وأي الصناديق تظهر فيها قيم شاذة؟
  2. df['Proline'].plot.hist(bins=10): كم عينة في أطول فئة، وبين أي حافتين؟ (يعطي np.histogram الأرقام الدقيقة)
  3. sns.regplot(x='Total phenols', y='Flavanoids', data=df): ما إشارة الميل؟ وما قيمة r باستخدام np.corrcoef؟
  4. الخريطة الحرارية للأعمدة ['Class', 'Alcohol', 'Flavanoids', 'Proline'] فقط: أي زوج له أكبر |r|؟

التمرين 4: الإجابة

المهمةالإجابة
1الوسيطات 2.98 و2.03 و0.685: الصنف 1. القيم الشاذة: الصنف 2 (5.08)، والصنف 3 (1.57)
241 عينة بين 558.4 و698.6
3موجب: الميل 1.380، وr = 0.865
4Class وFlavanoids، r = -0.847، كما في الخريطة الحرارية الكاملة

الخلاصة

  1. تبني Matplotlib الشكل استدعاء بعد استدعاء: البيانات، ثم العنوان والتسميات وعلامات التدريج والنص والخطوط ومفتاح الرسم
  2. يقسم المدرج التكراري المدى إلى فئات متساوية؛ وعدد الفئات يغير الصورة
  3. يعرض المخطط الصندوقي الوسيط والربيعين، والشاربين حتى 1.5 IQR، والقيم الشاذة خارجهما
  4. ترسم pandas وSeaborn أعمدة DataFrame بأسمائها؛ ويقسم x= أو hue= البيانات حسب المجموعة
  5. يقيس r العلاقة الخطية المستقيمة؛ وتعرض الخريطة الحرارية كل الأزواج دفعة واحدة
  6. اختر المخطط انطلاقا من السؤال: الزمن، أو المقارنة، أو الشكل، أو التشتت، أو العلاقة

افتح هذا الدرس

Mahmoud Abasتصوير البيانات باستخدام Matplotlib وSeaborn