

الانحدار الخطي
يقدم هذا القسم أول نموذج تنبؤ حقيقي في المقرر: الانحدار الخطي (linear regression). يتنبأ هذا النموذج بعدد، وهو هنا سعر منزل، انطلاقا من عدد واحد أو أكثر من المدخلات، وذلك بملاءمة (fitting) خط مستقيم للبيانات (أو صورته التي تضم خصائص كثيرة). ستلائم أولا خطا يدويا لخمسة منازل حقيقية بطريقة المربعات الصغرى (least squares)، ثم تستكشف مجموعة بيانات من 5000 منزل وتنظفها وتبني لها نموذجا باستخدام دفتر (notebook) الأسبوع 3، وتحكم على النموذج بمقاييس الخطأ الخاصة به.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- شرح ما يتنبأ به الانحدار الخطي، والفرق بين الانحدار الخطي البسيط (simple linear regression) والانحدار الخطي المتعدد (multiple linear regression).
- تعريف الباقي (residual) وخط المربعات الصغرى، وحساب الميل (slope) والمقطع (intercept) يدويا.
- حساب MAE وMSE وRMSE وR² لخط ملائم.
- استكشاف مجموعة بيانات باستخدام
infoوdescribeومدرج تكراري (histogram) وخريطة حرارية (heatmap) للارتباط (correlation)، وتجهيزها للنموذج. - ملاءمة
LinearRegressionفي scikit-learn، وقراءة مقطعه ومعاملاته (coefficients)، والتنبؤ يدويا بسعر منزل جديد انطلاقا منها. - تقييم النموذج على بيانات الاختبار باستخدام رسوم البواقي ومقاييس الخطأ، وتطبيق الخطوات نفسها على مشروع فريقك.
موقع الدرس من المقرر
للأسبوع 3 في الخطة ثلاثة أجزاء:
- الدفتر. الدفتر
Linear_Regression_Practiceمن مستودع المقرر، وهو يبني نموذجا لأسعار 5000 منزل في الولايات المتحدة. - سيناريو من الواقع. التنبؤ بأسعار المنازل (Predict House Pricing).
- مرحلة المشروع (project milestone). استكشاف بيانات المشروع وتنظيفها (Project Data Exploration and Data Cleaning): في هذا الأسبوع يستكشف فريقك مجموعة بياناته الخاصة وينظفها.
في الأسبوع 2 رسمت sns.regplot الخط المستقيم الذي يلائم مخطط الانتشار (scatter plot) على أفضل وجه. وفي هذا الأسبوع تتعلم كيف يحدد هذا الخط وكيف تستخدمه للتنبؤ.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | الفكرة، والمربعات الصغرى، ومثال محلول يدويا | 35 دقيقة |
| 2 | الدفتر: استكشاف بيانات المنازل وتجهيزها | 20 دقيقة |
| 3 | الدفتر: ملاءمة النموذج وقراءة معاملاته | 20 دقيقة |
| 4 | تقييم النموذج على مجموعة الاختبار، ومشروعك | 15 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1: فكرة الانحدار الخطي
ما الانحدار الخطي
يبدأ الدفتر بهذا التعريف: الانحدار الخطي طريقة خطية لنمذجة العلاقة بين متغير تابع (dependent variable) عددي (scalar) y ومتغير تفسيري (explanatory variable) واحد أو أكثر (وتسمى أيضا المتغيرات المستقلة، independent variables) يرمز لها بالرمز X.
- إذا كان هناك متغير تفسيري واحد سمي الانحدار الخطي البسيط.
- وإذا كان هناك أكثر من متغير واحد سمي الانحدار الخطي المتعدد.
- وغالبا ما تلاءم نماذج الانحدار الخطي بطريقة المربعات الصغرى.
في سيناريو أسعار المنازل، y هو سعر المنزل، وX يضم أعدادا تصف منطقته، مثل متوسط دخل سكانها.
النموذج خط مستقيم
مع خاصية (feature) واحدة x، يكون النموذج خطا:
ŷ = b0 + b1 · xxهو المدخل، مثل متوسط دخل المنطقة.ŷ(تقرأ "y hat") هي القيمة المتنبأ بها (predicted value)، مثل السعر المتنبأ به.b1هو الميل: مقدار تغيرŷعندما تزيدxبمقدار 1.b0هو المقطع: قيمةŷعندماx = 0. وهو يحدد ارتفاع الخط أو انخفاضه.
مع خمس خصائص من x1 إلى x5، تصبح الفكرة نفسها ŷ = b0 + b1·x1 + b2·x2 + b3·x3 + b4·x4 + b5·x5، بمعامل واحد لكل خاصية. وهذا هو نموذج الدفتر.
البواقي
لنقطة بيانات قيمتها الحقيقية y وقيمتها المتنبأ بها ŷ، يكون الباقي هو خطأ التنبؤ:
e = y - ŷالنقطة الواقعة فوق الخط لها باق موجب، والنقطة الواقعة تحته لها باق سالب. وعلى الرسم، الباقي هو المسافة الرأسية من النقطة إلى الخط.
المربعات الصغرى
تمر خطوط كثيرة قرب النقاط. وخط المربعات الصغرى (least-squares line) هو الخط الذي يكون مجموع مربعات بواقيه أصغر ما يمكن:
SSE = e1² + e2² + ... + en² = Σ (yi - ŷi)²SSE هو مجموع مربعات الأخطاء (sum of squared errors)، وn هو عدد النقاط. يجعل التربيع كل خطأ يحسب موجبا، ويعاقب الأخطاء الكبيرة أكثر من الصغيرة. ومع خاصية واحدة، يكون الميل والمقطع اللذان يجعلان SSE أصغر ما يمكن هما:
b1 = Σ (xi - x̄)(yi - ȳ) / Σ (xi - x̄)²

b0 = ȳ - b1 · x̄
x̄ وȳ هما متوسطا (means) x وy. وتعني المعادلة الثانية أن خط المربعات الصغرى يمر دائما بالنقطة (x̄, ȳ).
مثال محلول: خمسة منازل يدويا
نأخذ خمسة منازل حقيقية من مجموعة بيانات الدفتر، USA_Housing.csv. ولكي تبقى الحسابات صغيرة نقيس الدخل بوحدة 10,000 دولار والسعر بوحدة 100,000 دولار، ونقرب كليهما إلى أقرب وحدة كاملة.
| المنزل | رقم الصف في مجموعة البيانات | متوسط دخل المنطقة | السعر | x | y |
|---|---|---|---|---|---|
| H1 | 4034 | $50,016.43 | $497,368.04 | 5 | 5 |
| H2 | 375 | $59,768.81 | $897,291.12 | 6 | 9 |
| H3 | 1920 | $69,528.56 | $995,137.20 | 7 | 10 |
| H4 | 427 | $79,627.63 | $1,196,064.33 | 8 | 12 |
| H5 | 4841 | $89,548.15 | $1,403,802.50 | 9 | 14 |
سؤال. أوجد خط المربعات الصغرى ŷ = b0 + b1·x، وقس خطأه، وتنبأ بسعر منزل في منطقة متوسط دخلها 75,000 دولار.
الخطوة 1: المتوسطان
x̄ = (5 + 6 + 7 + 8 + 9) / 5 = 35 / 5 = 7

ȳ = (5 + 9 + 10 + 12 + 14) / 5 = 50 / 5 = 10
الخطوة 2: الانحرافات عن المتوسطين
| المنزل | x - x̄ | y - ȳ | (x - x̄)(y - ȳ) | (x - x̄)² |
|---|---|---|---|---|
| H1 | -2 | -5 | 10 | 4 |
| H2 | -1 | -1 | 1 | 1 |
| H3 | 0 | 0 | 0 | 0 |
| H4 | 1 | 2 | 2 | 1 |
| H5 | 2 | 4 | 8 | 4 |
| المجموع | 21 | 10 |
الخطوة 3: الميل والمقطع
b1 = 21 / 10 = 2.1

b0 = ȳ - b1 · x̄ = 10 - 2.1 × 7 = 10 - 14.7 = -4.7
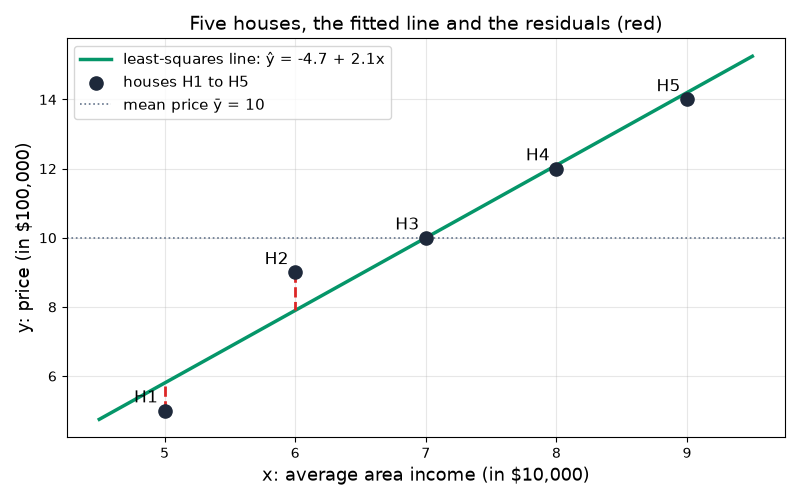
خط المربعات الصغرى هو ŷ = -4.7 + 2.1x. ويعني الميل أن كل 10,000 دولار إضافية من دخل المنطقة تضيف 2.1 وحدة، أي 210,000 دولار، إلى السعر المتنبأ به. أما المقطع، -4.7، فهو السعر الذي يعطيه الخط عند دخل يساوي صفرا؛ ولا توجد منطقة بهذا الدخل، لذا فهو يحدد موضع الخط فقط.
وتتفق scikit-learn مع هذه النتيجة: LinearRegression().fit(xh, yh) على هذه النقاط الخمس يعطي intercept_ = -4.7 وcoef_ = [2.1]. وعلى كل منازل التدريب في الدفتر، وعددها 3500 منزل، يحصل نموذج خاصيته الوحيدة هي الدخل على معامل قدره 20.9961 دولار من السعر لكل دولار من الدخل، أي 209,961 دولار لكل 10,000 دولار: وهو ميل يكاد يطابق ميل منازلنا الخمسة.
الخطوة 4: التنبؤات والبواقي
| المنزل | x | y | ŷ = -4.7 + 2.1x | e = y - ŷ | e² |
|---|---|---|---|---|---|
| H1 | 5 | 5 | 5.8 | -0.8 | 0.64 |
| H2 | 6 | 9 | 7.9 | 1.1 | 1.21 |
| H3 | 7 | 10 | 10.0 | 0.0 | 0.00 |
| H4 | 8 | 12 | 12.1 | -0.1 | 0.01 |
| H5 | 9 | 14 | 14.2 | -0.2 | 0.04 |
مجموع البواقي هو -0.8 + 1.1 + 0 - 0.1 - 0.2 = 0. وهذا صحيح دائما لخط المربعات الصغرى الذي له مقطع، وهو فحص سريع لحساباتك.
الخطوة 5: مجموع مربعات الأخطاء
SSE = 0.64 + 1.21 + 0 + 0.01 + 0.04 = 1.90قارنه بخطين قد تخمنهما بالنظر:
| الخط | البواقي | SSE |
|---|---|---|
| ŷ = -3 + 2x | -2, 0, -1, -1, -1 | 7.0 |
| ŷ = -4 + 2x | -1, 1, 0, 0, 0 | 2.0 |
| ŷ = -4.7 + 2.1x (المربعات الصغرى) | -0.8, 1.1, 0, -0.1, -0.2 | 1.9 |
يبدو التخمين الثاني مثاليا على ثلاثة منازل، ومع ذلك تبلغ قيمة SSE له 2.0. ولا يستطيع أي خط أن ينزل تحت 1.9 لهذه المنازل الخمسة: وهذا هو معنى "المربعات الصغرى".
الخطوة 6: التنبؤ لمنطقة جديدة
متوسط الدخل البالغ 75,000 دولار يقابل x = 7.5:
ŷ = -4.7 + 2.1 × 7.5 = -4.7 + 15.75 = 11.05السعر المتنبأ به 11.05 وحدة، أي نحو 1,105,000 دولار. وتعيد model.predict([[7.5]]) القيمة نفسها 11.05.
لترى المربعات الصغرى وهي تتحرك، افتح أداة المربعات الصغرى التفاعلية بملء الشاشة. اسحب المنازل أو الخط، وشغل خيار إظهار المربعات، واضغط تشغيل لجمع مربعات البواقي منزلا بعد منزل، واضغط ملاءمة لينتقل الخط إلى خط المربعات الصغرى.
قياس خطأ الخط
يقيم الدفتر نموذجه بأربعة أعداد. مع n من النقاط والبواقي ei:
MAE  = (|e1| + |e2| + ... + |en|) / n
MSE  = (e1² + e2² + ... + en²) / n = SSE / n
RMSE = √MSE
R² = 1 - SSE / SST, where SST = Σ (yi - ȳ)²- MAE، متوسط الخطأ المطلق (mean absolute error): متوسط حجم الخطأ، بوحدات
y. - MSE، متوسط مربع الخطأ (mean squared error): متوسط مربعات الأخطاء. ووحدته مربع وحدة
y، لذا يصعب تفسيره وحده. - RMSE، الجذر التربيعي لمتوسط مربع الخطأ (root mean squared error): الجذر التربيعي لقيمة MSE، ويعود إلى وحدات
y. والأخطاء الكبيرة تؤثر فيه أكثر مما تؤثر في MAE. - R²، معامل التحديد (coefficient of determination):
SSTهو قيمة SSE للخط الأفقيŷ = ȳ، وهو أفضل تخمين يمكنك تقديمه دون أي خاصية. ومعامل التحديد هو نسبة ما يزيله النموذج من هذا الخطأ. القيمة 1 تعني ملاءمة تامة، والقيمة 0 تعني أن النموذج ليس أفضل من المتوسط.
مثال محلول: خطأ خط المنازل الخمسة
سؤال. احسب MAE وMSE وRMSE وR² للخط ŷ = -4.7 + 2.1x.
MAE  = (0.8 + 1.1 + 0 + 0.1 + 0.2) / 5 = 2.2 / 5 = 0.44
MSE  = 1.90 / 5 = 0.38
RMSE = √0.38 = 0.6164
بالدولار، يساوي RMSE القيمة 0.6164 × $100,000، أي نحو 61,640 دولار.
لحساب R²، نبدأ بمربعات انحرافات y عن ȳ = 10: 25, 1, 0, 4, 16.
SST = 25 + 1 + 0 + 4 + 16 = 46
R²  = 1 - 1.90 / 46 = 1 - 0.0413 = 0.9587
يزيل الخط نحو 96% من مربعات أخطاء الخط الأفقي عند متوسط السعر. وتعطي دوال metrics في scikit-learn القيم الأربع نفسها: 0.44 و0.38 و0.6164 و0.9587.
افتح أداة معامل التحديد R² بملء الشاشة لتشاهد خط المتوسط الأفقي يميل حتى يصير خط المربعات الصغرى بينما يصغر SSE، على هذه المنازل الخمسة وعلى 60 منزلا حقيقيا مع كل خاصية من الخصائص الخمس.
الجزء 2: الدفتر، استكشاف بيانات المنازل
فتح الدفتر
افتح Linear_Regression_Practice في Colab
يقرأ الدفتر البيانات باستخدام pd.read_csv("./Datasets/USA_Housing.csv"). وفي Colab لا يوجد مجلد Datasets بجوار الدفتر: ففي المستودع يوجد الملف داخل المجلد Datasets في المستوى الأعلى. اقرأه من المستودع بدلا من ذلك:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

url = ("https://raw.githubusercontent.com/"
       "tirthajyoti/Machine-Learning-with-Python/"
       "master/Datasets/USA_Housing.csv")
df = pd.read_csv(url)
df.head()
فحص المعلومات الأساسية
يعرض df.info(verbose=True) 5000 صف و7 أعمدة:
| العمود | النوع | المعنى |
|---|---|---|
| Avg. Area Income | float64 | متوسط دخل سكان المنطقة، بالدولار |
| Avg. Area House Age | float64 | متوسط عمر المنازل في المنطقة، بالسنوات |
| Avg. Area Number of Rooms | float64 | متوسط عدد الغرف في المنزل |
| Avg. Area Number of Bedrooms | float64 | متوسط عدد غرف النوم في المنزل |
| Area Population | float64 | عدد سكان المنطقة |
| Price | float64 | سعر المنزل، وهو القيمة التي نتنبأ بها |
| Address | نص | العنوان، مثل 208 Michael Ferry Apt. 674 |
يعرض كل عمود 5000 non-null، لذا لا توجد قيم مفقودة (missing values)؛ ويؤكد df.isnull().sum() القيمة 0 لكل عمود. والعمود Address نصي، والنموذج الخطي لا يستطيع إلا ضرب الأعداد، لذا سيستبعد من X.
الملخص الإحصائي
يلخص df.describe(percentiles=[0.1,0.25,0.5,0.75,0.9]) كل عمود عددي. وهذه أربعة صفوف منه للعمودين اللذين نستخدمهما أكثر من غيرهما:
| الإحصاء | Avg. Area Income | Price |
|---|---|---|
| mean | 68,583.11 | 1,232,073 |
| std | 10,657.99 | 353,118 |
| min | 17,796.63 | 15,939 |
| max | 107,701.75 | 2,469,066 |
تطبع pandas السعر بالصيغة العلمية (scientific notation)، مثل 1.232073e+06، ومعناها 1.232073 × 10⁶، أي 1,232,073.
توزيع السعر
df['Price'].plot.hist(bins=25, figsize=(8,4))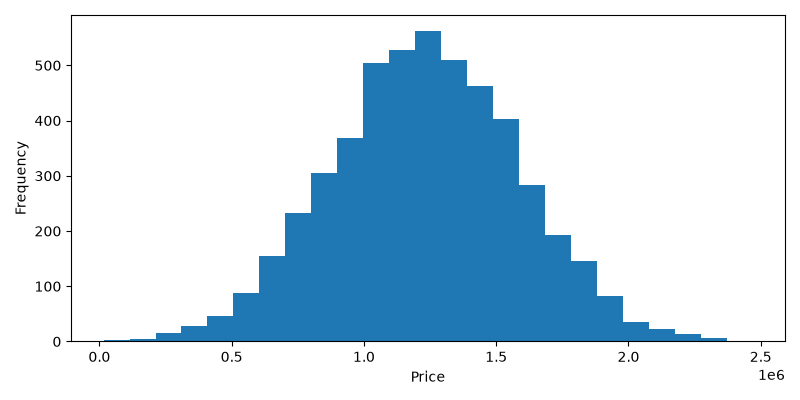
تشكل الأسعار تلا واحدا حول المتوسط البالغ نحو 1.23 مليون دولار. وسعر 97 منزلا فقط أقل من 0.5 مليون دولار، وسعر 74 منزلا فقط أعلى من 2 مليون دولار. ويعني 1e6 أسفل المحور أن أرقام التدريج بالملايين. ويرسم الدفتر أيضا التوزيع نفسه في صورة منحنى أملس باستخدام df['Price'].plot.density().
الارتباطات
يستدعي الدفتر df.corr(). وفي الإصدارات الحالية من pandas يتوقف هذا السطر بالخطأ ValueError: could not convert string to float، لأن Address نص. اطلب الأعمدة العددية فقط:
df.corr(numeric_only=True)

plt.figure(figsize=(10,7))
sns.heatmap(df.corr(numeric_only=True), annot=True, linewidths=2)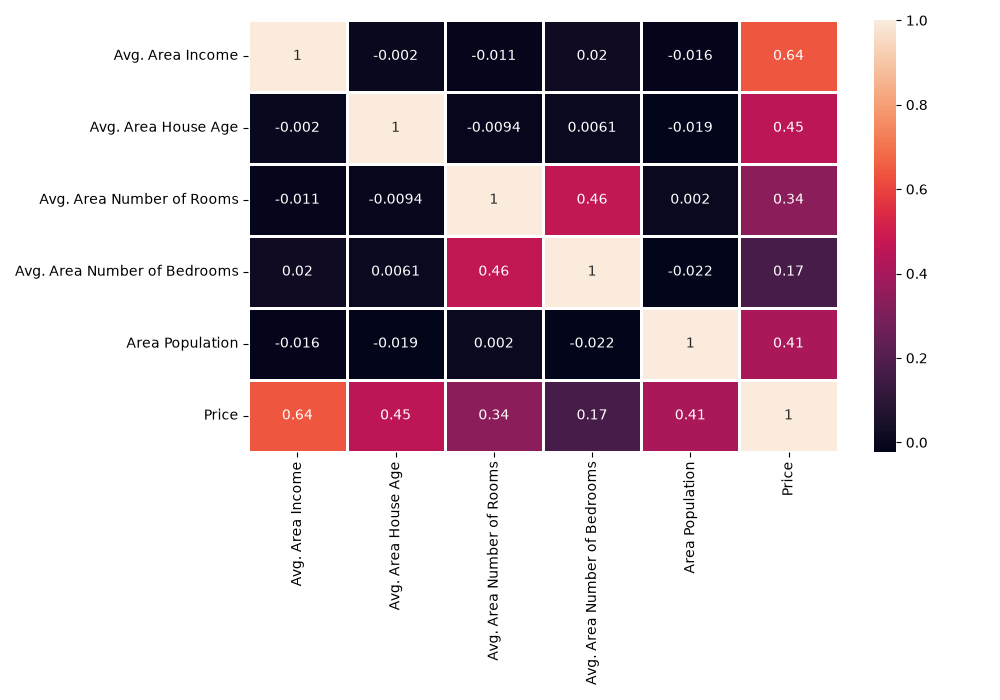
اقرأ صف Price. لكل خاصية ارتباط موجب مع السعر:
| الخاصية | الارتباط مع Price |
|---|---|
| Avg. Area Income | 0.640 |
| Avg. Area House Age | 0.453 |
| Area Population | 0.409 |
| Avg. Area Number of Rooms | 0.336 |
| Avg. Area Number of Bedrooms | 0.171 |
الدخل هو الأكثر تحركا مع السعر، وعدد غرف النوم هو الأقل. والخصائص لا تكاد ترتبط فيما بينها (قيم قريبة من 0)، باستثناء الغرف وغرف النوم بقيمة 0.46، وهذا منطقي: فالمنازل التي فيها غرف أكثر تميل إلى أن يكون فيها عدد أكبر من غرف النوم. ويرسم الدفتر أيضا sns.pairplot(df)، وهو شبكة تضم كل زوج من الأعمدة، ومخطط انتشار لكل خاصية مقابل السعر:
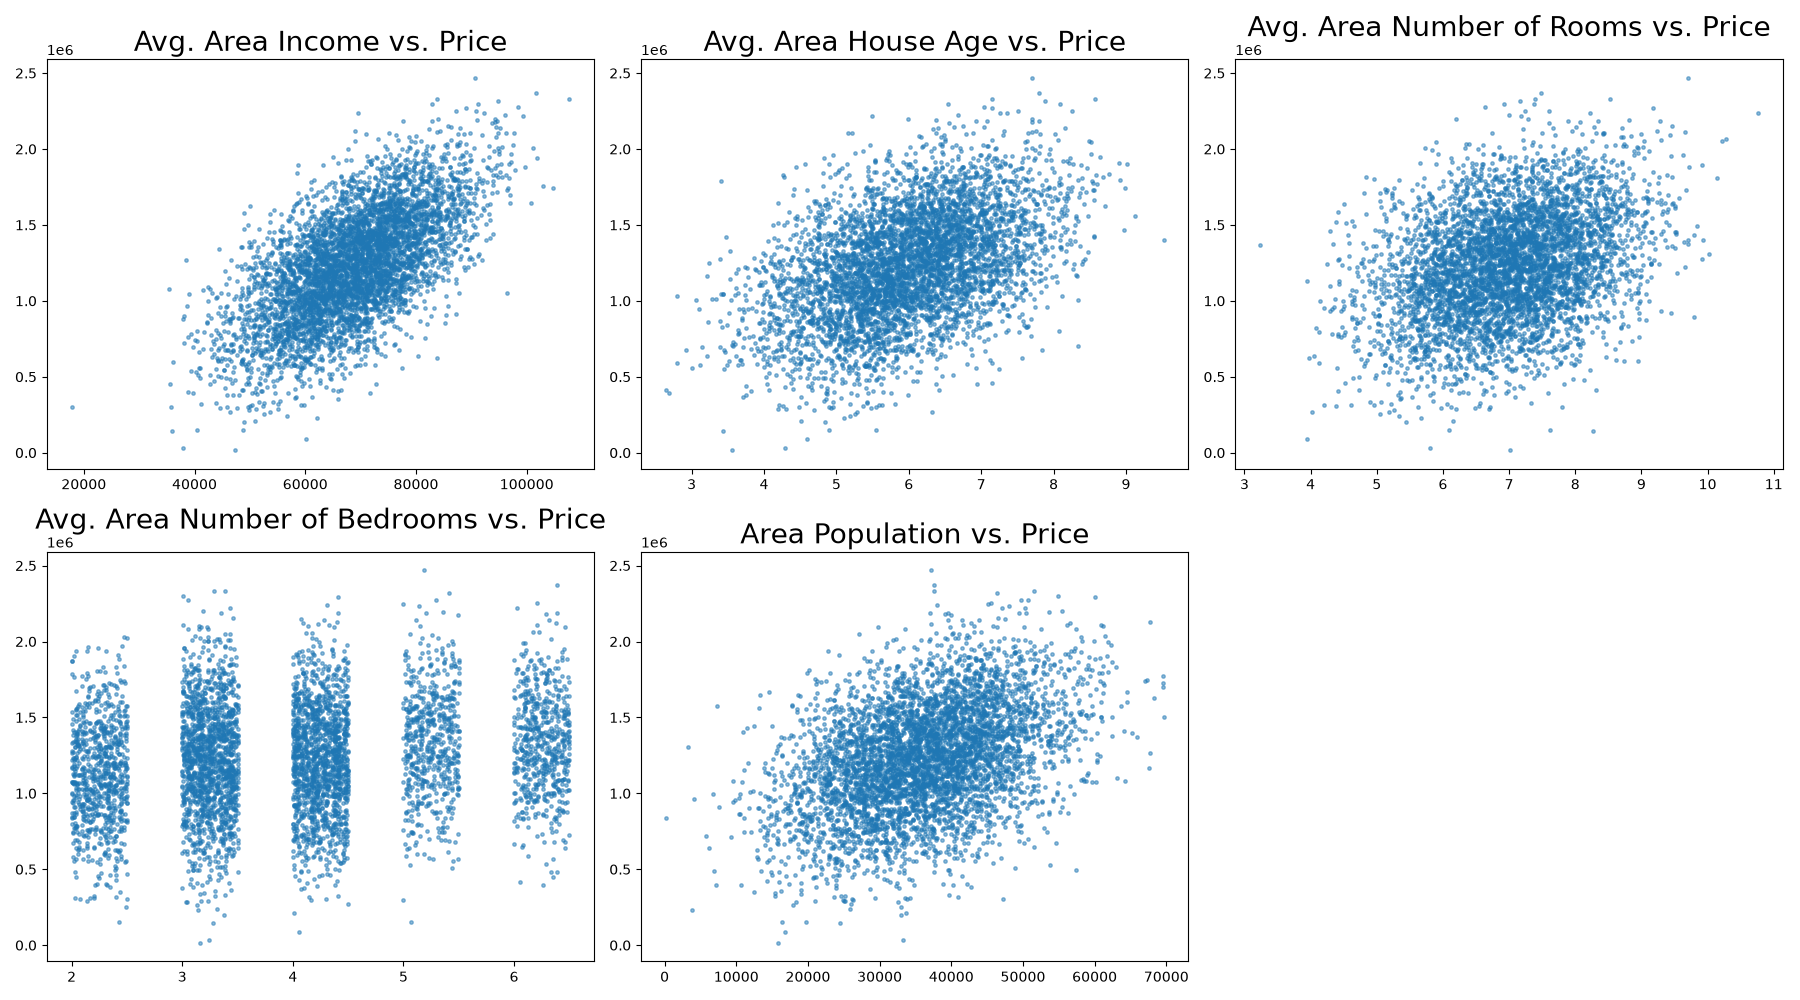
تظهر لوحة الدخل أوضح اتجاه صاعد. وتظهر لوحة غرف النوم أشرطة رأسية فوق كل عدد صحيح مباشرة، وأسعارها متماثلة تقريبا في كل شريط.
الجزء 3: الدفتر، ملاءمة النموذج
الخصائص والهدف
l_column = list(df.columns)
len_feature = len(l_column)
X = df[l_column[0:len_feature-2]]
y = df[l_column[len_feature-2]]
print("Feature set size:", X.shape)
print("Variable set size:", y.shape)
تضم قائمة الأعمدة 7 أسماء، لذا len_feature - 2 = 5. يأخذ X الأعمدة من 0 إلى 4، وهي الخصائص العددية الخمس، ويأخذ y العمود 5، وهو Price (الهدف، target). أما Address، العمود الأخير، فيستبعد. والناتج:
Feature set size: (5000, 5)
Variable set size: (5000,)
التقسيم إلى تدريب واختبار
يستورد الدفتر train_test_split من sklearn.cross_validation. وقد حذفت هذه الوحدة من scikit-learn منذ زمن طويل، لذا يفشل الاستيراد؛ والدالة موجودة الآن في sklearn.model_selection:
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=123)
يحتفظ test_size=0.3 بنسبة 30% من الصفوف للاختبار: 0.3 × 5000 = 1500 منزل اختبار و3500 منزل تدريب. وتطبع الأبعاد على الصورة (3500, 5) و(1500, 5).
الملاءمة وقراءة المعاملات
from sklearn.linear_model import LinearRegression
from sklearn import metrics

lm = LinearRegression()
lm.fit(X_train, y_train)
print("The intercept term of the linear model:", lm.intercept_)

cdf = pd.DataFrame(data=lm.coef_, index=X_train.columns, columns=["Coefficients"])
cdf
المقطع هو -2631028.9017454907، والمعاملات هي:
| الخاصية | المعامل |
|---|---|
| Avg. Area Income | 21.597602 |
| Avg. Area House Age | 165201.104954 |
| Avg. Area Number of Rooms | 119061.463868 |
| Avg. Area Number of Bedrooms | 3212.585606 |
| Area Population | 15.228121 |
إذن النموذج الملائم هو:
ŷ = -2631028.90 + 21.597602·x1 + 165201.104954·x2 + 119061.463868·x3 + 3212.585606·x4 + 15.228121·x5حيث x1 إلى x5 هي الدخل، وعمر المنزل، والغرف، وغرف النوم، والسكان، بترتيب الجدول.
كل معامل هو مقدار تغير السعر المتنبأ به عندما تزيد تلك الخاصية وحدها بمقدار 1 وتبقى الخصائص الأربع الأخرى كما هي:
- سنة إضافية من متوسط عمر المنازل تضيف 165,201.10 دولار.
- غرفة إضافية تضيف 119,061.46 دولار.
- دولار إضافي من دخل المنطقة يضيف 21.60 دولار، لذا فزيادة الدخل بمقدار 10,000 دولار تضيف 215,976 دولار.
يعتمد المعامل على وحدة خاصيته. فالدخل مقيس بالدولار، لذا يبدو معامله صغيرا، ومع ذلك فالدخل هو الخاصية الأكثر تأثيرا في السعر. لا ترتب الخصائص حسب حجم معاملاتها.
مثال محلول: التنبؤ يدويا بسعر منزل اختبار
سؤال. منزل الاختبار الأول هو الصف 2648 من مجموعة البيانات. تنبأ بسعره من المعاملات، ثم قارنه بسعره الحقيقي، 800,146.23 دولار.
| الخاصية | القيمة x | المعامل b | b × x |
|---|---|---|---|
| Avg. Area Income | 63824.394539 | 21.597602 | 1,378,453.87 |
| Avg. Area House Age | 4.991750 | 165201.104954 | 824,642.62 |
| Avg. Area Number of Rooms | 5.003836 | 119061.463868 | 595,764.04 |
| Avg. Area Number of Bedrooms | 4.00 | 3212.585606 | 12,850.34 |
| Area Population | 40086.458749 | 15.228121 | 610,441.44 |
Σ b × x = 1,378,453.87 + 824,642.62 + 595,764.04 + 12,850.34 + 610,441.44 = 3,422,152.31
ŷ = -2,631,028.90 + 3,422,152.31 = 791,123.41
e = 800,146.23 - 791,123.41 = 9,022.82
يتنبأ النموذج بنحو 791,123 دولار، وقد بيع المنزل بسعر 800,146 دولار: أي أن التنبؤ أقل من الحقيقة بمقدار 9,023 دولار. وتطبع lm.predict(X_test)[0] القيمة 791123.50601188؛ والفرق البالغ 10 سنتات ناتج عن تقريب المعاملات إلى ستة أرقام عشرية. فالنموذج الملائم ليس أكثر من هذا المجموع.
أي الخصائص أهم
يحسب الدفتر خطأ معياريا (standard error) لكل معامل ثم يقسم: t-statistic = coefficient / standard error. وكلما كبرت إحصائية t (t-statistic)، كان تأثير الخاصية في السعر أوضح، أيا كانت وحدتها. وهذا ناتجه مرتبا:
| الخاصية | المعامل | الخطأ المعياري | إحصائية t |
|---|---|---|---|
| Avg. Area Income | 21.597602 | 0.160361 | 134.681505 |
| Avg. Area House Age | 165201.104954 | 1722.412068 | 95.912649 |
| Area Population | 15.228121 | 0.169882 | 89.639472 |
| Avg. Area Number of Rooms | 119061.463868 | 1696.546476 | 70.178722 |
| Avg. Area Number of Bedrooms | 3212.585606 | 1376.451759 | 2.333962 |
الدخل هو الأهم وغرف النوم هي الأقل أهمية، وهو الترتيب نفسه للارتباطات مع السعر. وتعطي الملاءمة على بيانات التدريب R-squared value of this fit: 0.917.
وتنبيه على هذا الجدول: الخطأ المعياري في الدفتر صيغة مبسطة لا تأخذ في الحساب الارتباط بين الخصائص. والأخطاء المعيارية الدقيقة لطريقة المربعات الصغرى العادية (OLS) تعطي إحصائية t قدرها 62.37 للغرف (لا 70.18) و2.07 لغرف النوم (لا 2.33). ويبقى الترتيب نفسه.
الجزء 4: تقييم النموذج على مجموعة الاختبار
التنبؤ بأسعار منازل الاختبار
predictions = lm.predict(X_test)

plt.figure(figsize=(10,7))
plt.title("Actual vs. predicted house prices", fontsize=25)
plt.xlabel("Actual test set house prices", fontsize=18)
plt.ylabel("Predicted house prices", fontsize=18)
plt.scatter(x=y_test, y=predictions)
predictions مصفوفة NumPy فيها 1500 سعر، سعر واحد لكل منزل اختبار.
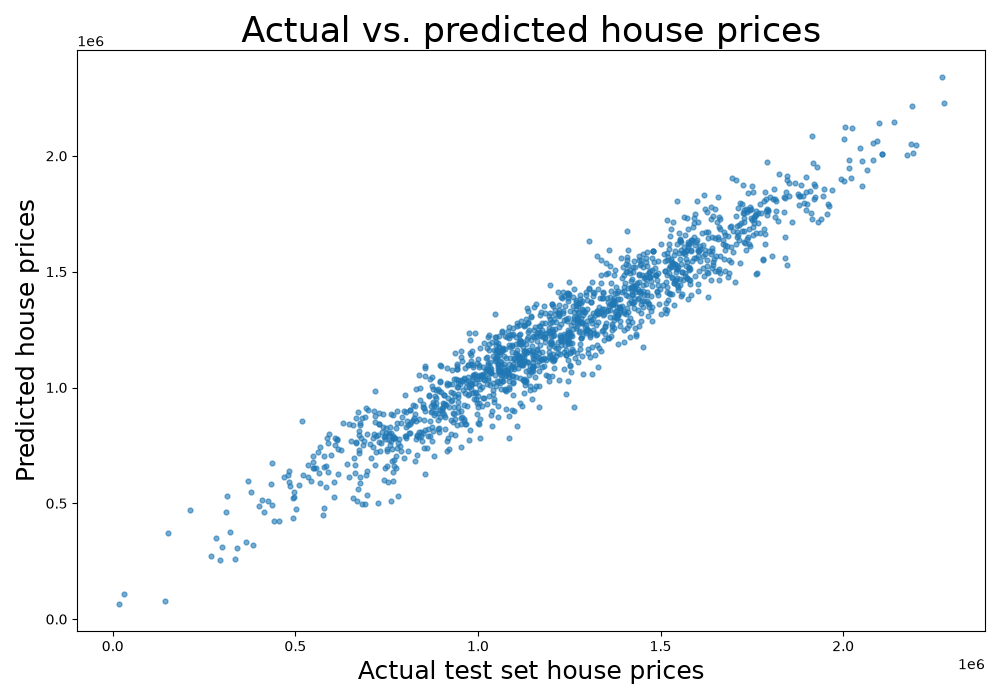
النموذج المثالي يضع كل نقطة على الخط المائل بزاوية 45 درجة، حيث يتساوى السعر المتنبأ به والسعر الفعلي. وتشكل النقاط شريطا ضيقا على امتداد هذا الخط: فالنموذج قريب من الصواب في المنازل الرخيصة والغالية على السواء.
فحص البواقي
يرسم الدفتر البواقي y_test - predictions مرتين. وهو يستخدم sns.distplot، التي تصفها الإصدارات الحالية من seaborn بأنها مهملة (deprecated)؛ والدالة sns.histplot مع kde=True ترسم الصورة نفسها:
plt.figure(figsize=(10,7))
plt.title("Histogram of residuals to check for normality", fontsize=25)
sns.histplot(y_test - predictions, kde=True)

plt.figure(figsize=(10,7))
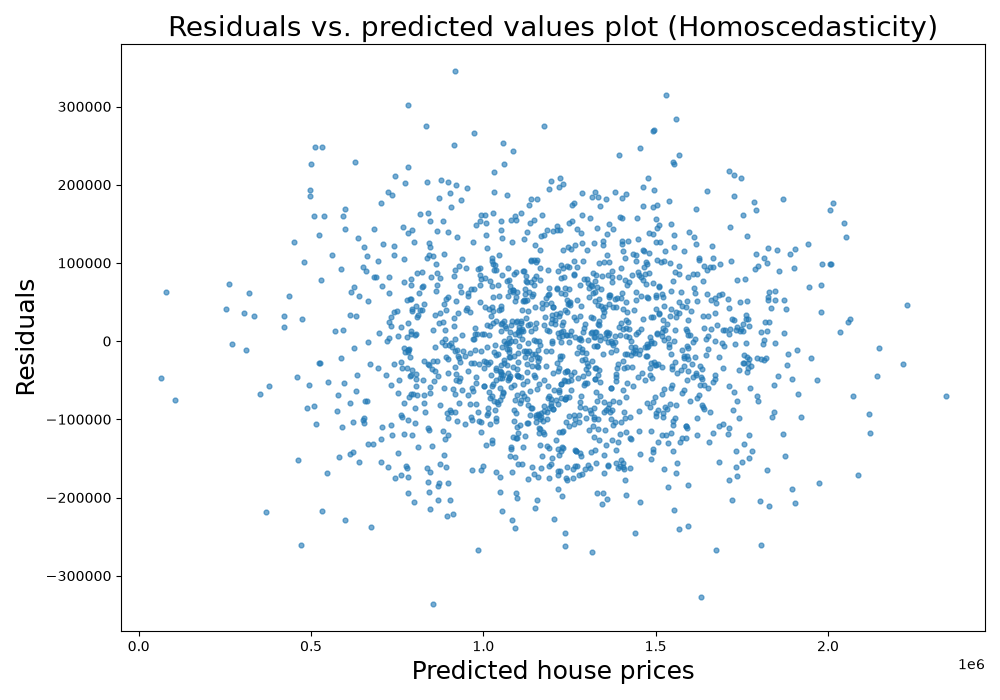
plt.title("Residuals vs. predicted values plot (Homoscedasticity)", fontsize=20)
plt.scatter(x=predictions, y=y_test - predictions)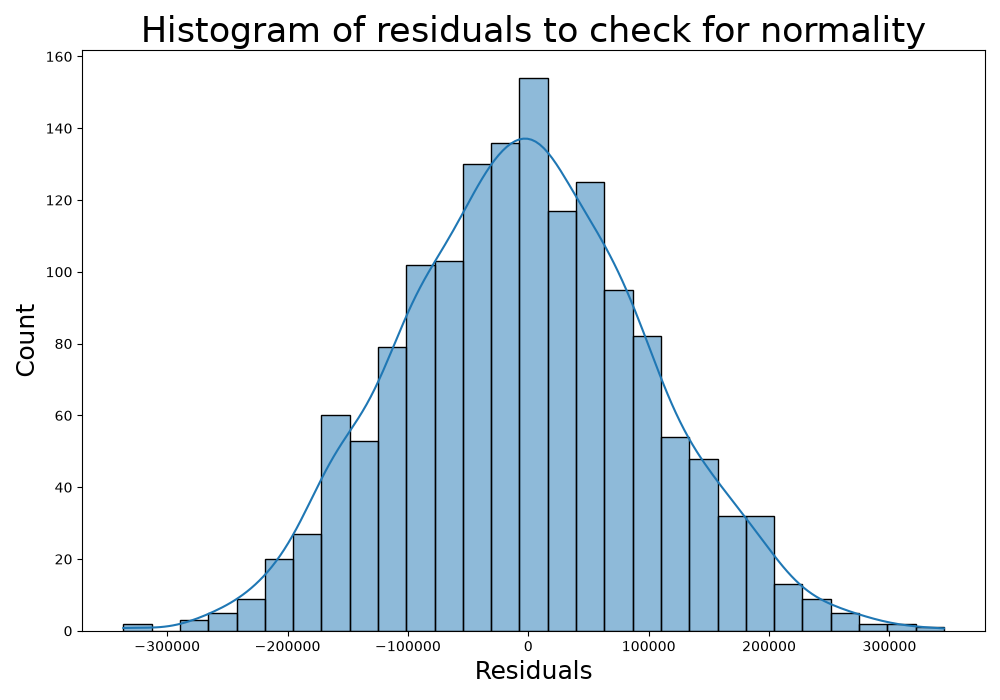
- المدرج التكراري تل واحد متماثل مركزه قرب 0 (متوسط البواقي -3,474 دولار): معظم الأخطاء صغيرة، والتنبؤ بأعلى من السعر وبأقل منه متساويان في الشيوع، وليس في النموذج انحياز (bias) ثابت. وتمتد البواقي من نحو -336,000 دولار إلى +345,000 دولار.
- في الرسم الثاني للسحابة الارتفاع نفسه عند التنبؤات المنخفضة والمرتفعة، ولا يظهر فيها أي انحناء. ويسمي الدفتر هذا تجانس التباين (homoscedasticity): حجم الأخطاء لا يعتمد على التنبؤ.
مقاييس الخطأ
print("Mean absolute error (MAE):", metrics.mean_absolute_error(y_test, predictions))
print("Mean square error (MSE):", metrics.mean_squared_error(y_test, predictions))
print("Root mean square error (RMSE):", np.sqrt(metrics.mean_squared_error(y_test, predictions)))
print("R-squared value of predictions:", round(metrics.r2_score(y_test, predictions), 3))
Mean absolute error (MAE): 81739.77482718184
Mean square error (MSE): 10489638335.804983
Root mean square error (RMSE): 102418.93543581179
R-squared value of predictions: 0.919- MAE: يبتعد تنبؤ الاختبار عن السعر الحقيقي في المتوسط بنحو 81,740 دولار.
- MSE: نحو 10.5 مليار دولار مربع، وهو عدد لا معنى له في الحياة اليومية.
- RMSE:
√10,489,638,335.80 = 102,418.94، لذا فالخطأ المعتاد نحو 102,419 دولار. وهو أكبر من MAE لأن الأخطاء الكبيرة القليلة لها وزن أكبر. - R²: 0.919 على 1500 منزل اختبار، مقابل 0.917 على 3500 منزل تدريب. يفسر النموذج نحو 92% من تشتت الأسعار في منازل لم يرها قط، وأداؤه على البيانات الجديدة جيد بقدر أدائه على بيانات تدريبه.
مع متوسط سعر قدره 1,232,073 دولار، يمثل الخطأ المعتاد البالغ 102,419 دولار نحو 8% من السعر.
الأخطاء الشائعة
- تشغيل الاستدعاءات القديمة في الدفتر كما هي:
sklearn.cross_validation، وdf.corr()على DataFrame فيه عمود نصي، وsns.distplot. - قراءة
./Datasets/USA_Housing.csvفي Colab، حيث لا يوجد هذا المجلد. - إبقاء العمود النصي
AddressفيX. - ترتيب الخصائص حسب حجم معاملاتها حين تختلف وحداتها.
- الاكتفاء بقيمة R² على بيانات التدريب؛ احكم على النموذج بمجموعة الاختبار.
- فهم R² على أنه دقة (accuracy). إنه نسبة ما يزيله النموذج من مربعات الأخطاء مقارنة بالتنبؤ بالمتوسط.
- الوثوق بتنبؤ بعيد جدا عن نطاق بيانات التدريب، مثل المقطع عند دخل يساوي صفرا.
مرحلة المشروع: استكشاف البيانات وتنظيفها
مرحلة هذا الأسبوع هي استكشاف مجموعة بيانات فريقك وتنظيفها. استخدم الخطوات نفسها التي في الجزء 2:
- حمل البيانات وافحص
shapeوأسماء الأعمدة والأنواع باستخدامinfo(). - احسب عدد القيم المفقودة باستخدام
isnull().sum()، ثم املأها باستخدامfillnaأو احذفها باستخدامdropna، كما في الأسبوع 1. - لخص كل عمود عددي باستخدام
describe()وابحث عن القيم المستحيلة، مثل عمر سالب أو أدنى سعر قريب من الصفر. - ارسم الهدف بمدرج تكراري، وكل خاصية مقابل الهدف بمخطط انتشار.
- ارسم الخريطة الحرارية للارتباط باستخدام
numeric_only=Trueولاحظ الخصائص الأكثر تحركا مع الهدف. - حدد الأعمدة التي لا يمكن أن تدخل النموذج كما هي، مثل النص الحر أو المعرفات (IDs)، واحذفها باستخدام
drop(..., axis=1).
اكتب ما وجدته وما غيرته. وفي الأسبوع القادم تستمر المرحلة باستخراج الخصائص (feature extraction) واختيار المتغير الهدف (target variable).
الخلاصة
- يتنبأ الانحدار الخطي بعدد على أنه
b0مضافا إليه مجموع موزون للخصائص. - الباقي هو
y - ŷ، وخط المربعات الصغرى يجعل مجموع مربعات البواقي أصغر ما يمكن. - مع خاصية واحدة،
b1 = Σ(x - x̄)(y - ȳ) / Σ(x - x̄)²وb0 = ȳ - b1·x̄. - استكشف البيانات ونظفها أولا: الأنواع، والقيم المفقودة، والأعمدة النصية، والتوزيعات، والارتباطات.
- المعامل هو مقدار تغير التنبؤ لكل وحدة من خاصيته، لذا قارن الخصائص بإحصائية t، لا بحجم المعامل.
- احكم على النموذج بمجموعة الاختبار باستخدام MAE وRMSE وR²، وانظر في رسوم البواقي.
التمارين
نحو 30 دقيقة. حاول حل كل تمرين قبل أن تقرأ إجابته في نهاية الصفحة.
التمرين 1: ملاءمة خط يدويا (نحو 10 دقائق)
لخمس مناطق هذه الدخول x (بوحدة 10,000 دولار) وأسعار المنازل y (بوحدة 100,000 دولار):
| المنطقة | x | y |
|---|---|---|
| A1 | 4 | 6 |
| A2 | 5 | 7 |
| A3 | 6 | 10 |
| A4 | 7 | 11 |
| A5 | 8 | 11 |
- احسب
x̄وȳوالميلb1والمقطعb0لخط المربعات الصغرى. - احسب التنبؤات والبواقي الخمسة، وتحقق من أن مجموع البواقي يساوي 0.
- احسب SSE وMSE وRMSE وMAE وR².
- تنبأ بالسعر لدخل قدره 65,000 دولار.
التمرين 2: التنبؤ يدويا بسعر منزل اختبار (نحو 5 دقائق)
منزل الاختبار الثاني هو الصف 2456. خصائصه: الدخل 67041.967661، وعمر المنزل 6.021458، والغرف 5.346830، وغرف النوم 3.39، والسكان 15633.099048. وسعره الحقيقي 707,345.06 دولار.
استخدم المقطع -2,631,028.90 ومعاملات الجزء 3 للتنبؤ بسعره، ثم احسب الباقي.
التمرين 3: قراءة المعاملات (نحو 5 دقائق)
منطقتان متطابقتان إلا في خاصية واحدة. باستخدام معاملات الجزء 3، ما مقدار الفرق بين سعريهما المتنبأ بهما عندما:
- يزيد متوسط عمر منازل المنطقة الأولى على الثانية بمقدار 2، أي بسنتين؟
- يزيد متوسط الدخل في المنطقة الأولى بمقدار 5,000 دولار؟
ثم اشرح لماذا لا يعني معامل غرف النوم، 3212.59، أن غرف النوم أهم من الدخل.
التمرين 4: في Colab (نحو 10 دقائق)
- شغل الدفتر مع الإصلاحات الثلاثة الواردة في هذه الصفحة، حتى مقاييس الخطأ.
- لائم نموذجا ثانيا يستخدم
Avg. Area Incomeفقط:lm1.fit(X_train[['Avg. Area Income']], y_train). اطبع مقطعه، ومعامله، وقيم R² وMAE وRMSE على مجموعة الاختبار. - لائم نموذجا ثالثا على كل الخصائص عدا
Avg. Area Number of Bedrooms(استخدمdrop(..., axis=1)علىX_trainوX_test). اطبع قيمة R² على الاختبار. - قارن قيم R² الثلاث. ماذا تخبرك عن الخصائص؟
الإجابات
الإجابة 1
المتوسطان: x̄ = 30 / 5 = 6 وȳ = 45 / 5 = 9.
| المنطقة | x - x̄ | y - ȳ | (x - x̄)(y - ȳ) | (x - x̄)² |
|---|---|---|---|---|
| A1 | -2 | -3 | 6 | 4 |
| A2 | -1 | -2 | 2 | 1 |
| A3 | 0 | 1 | 0 | 0 |
| A4 | 1 | 2 | 2 | 1 |
| A5 | 2 | 2 | 4 | 4 |
| المجموع | 14 | 10 |
b1 = 14 / 10 = 1.4
b0 = 9 - 1.4 × 6 = 9 - 8.4 = 0.6
الخط هو ŷ = 0.6 + 1.4x.
| المنطقة | y | ŷ | e | e² |
|---|---|---|---|---|
| A1 | 6 | 6.2 | -0.2 | 0.04 |
| A2 | 7 | 7.6 | -0.6 | 0.36 |
| A3 | 10 | 9.0 | 1.0 | 1.00 |
| A4 | 11 | 10.4 | 0.6 | 0.36 |
| A5 | 11 | 11.8 | -0.8 | 0.64 |
مجموع البواقي هو -0.2 - 0.6 + 1.0 + 0.6 - 0.8 = 0.
SSE  = 0.04 + 0.36 + 1.00 + 0.36 + 0.64 = 2.40
MSE  = 2.40 / 5 = 0.48
RMSE = √0.48 = 0.6928
MAE  = (0.2 + 0.6 + 1.0 + 0.6 + 0.8) / 5 = 3.2 / 5 = 0.64
SST  = 9 + 4 + 1 + 4 + 4 = 22
R²   = 1 - 2.40 / 22 = 0.8909
الدخل البالغ 65,000 دولار يقابل x = 6.5: ŷ = 0.6 + 1.4 × 6.5 = 9.7، أي نحو 970,000 دولار.
الإجابة 2
| الخاصية | b × x |
|---|---|
| Avg. Area Income | 21.597602 × 67041.967661 = 1,447,945.73 |
| Avg. Area House Age | 165201.104954 × 6.021458 = 994,751.52 |
| Avg. Area Number of Rooms | 119061.463868 × 5.346830 = 636,601.41 |
| Avg. Area Number of Bedrooms | 3212.585606 × 3.39 = 10,890.67 |
| Area Population | 15.228121 × 15633.099048 = 238,062.72 |
Σ b × x = 3,328,252.05
ŷ = -2,631,028.90 + 3,328,252.05 = 697,223.15
e = 707,345.06 - 697,223.15 = 10,121.91
يتنبأ النموذج بنحو 697,223 دولار، أي أقل من السعر الحقيقي بمقدار 10,122 دولار. وتطبع lm.predict القيمة 697223.19909089؛ والفرق البالغ بضعة سنتات ناتج عن التقريب.
الإجابة 3
2 × 165,201.104954 = 330,402.21: يتنبأ النموذج بأن المنطقة الأقدم أغلى بمقدار 330,402.21 دولار.5,000 × 21.597602 = 107,988.01: يتنبأ النموذج بأن المنطقة الأغنى أغلى بمقدار 107,988.01 دولار.
معامل غرف النوم محسوب لكل غرفة نوم، ومعامل الدخل لكل دولار. والتغير الواقعي في الدخل، وهو آلاف الدولارات، يحرك السعر أكثر بكثير مما تحركه غرفة نوم واحدة. وإحصائيات t تحسم الأمر: 134.68 للدخل و2.33 لغرف النوم.
الإجابة 4
| النموذج | R² على الاختبار | MAE على الاختبار | RMSE على الاختبار |
|---|---|---|---|
| الخصائص الخمس كلها | 0.919 | 81,739.77 | 102,418.94 |
| الدخل فقط | 0.417 | 218,757.30 | 275,407.48 |
| كل الخصائص عدا غرف النوم | 0.920 | 81,629.80 | 102,282.54 |
- للنموذج المعتمد على الدخل فقط مقطع قدره
-206897.41836459772ومعامل قدره20.99607335. - يفسر الدخل وحده نحو 42% من تشتت الأسعار؛ وتضيف الخصائص الأخرى البقية حتى 92%.
- حذف غرف النوم يغير R² على الاختبار من 0.919 إلى 0.920: فغرف النوم لا تضيف شيئا لا تعطيه الخصائص الأخرى أصلا، وهذا يتفق مع إحصائية t الخاصة بها البالغة 2.33 ومع ارتباطها بالغرف البالغ 0.46.