

في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 3
الانحدار الخطي
تنبأ بسعر منزل بخط مستقيم: لائمه يدويا بطريقة المربعات الصغرى، ثم ابن نموذجا لعدد 5000 منزل حقيقي في scikit-learn.
الأهداف
- ▸شرح ما يتنبأ به الانحدار الخطي (linear regression)، والفرق بين الانحدار البسيط (simple) والانحدار المتعدد (multiple)
- ▸تعريف الباقي (residual) وخط المربعات الصغرى (least-squares line)، وحساب الميل (slope) والمقطع (intercept) يدويا
- ▸حساب MAE وMSE وRMSE وR² لخط ملائم
- ▸استكشاف مجموعة بيانات وتجهيزها باستخدام
infoوdescribeومدرج تكراري (histogram) وخريطة حرارية للارتباط (correlation heatmap) - ▸ملاءمة (fit)
LinearRegression، وقراءة معاملاته (coefficients)، والتنبؤ يدويا بسعر منزل - ▸تقييم النموذج على بيانات الاختبار وتطبيق الخطوات على مشروعك
الأسبوع 3 من الخطة
موقع الدرس من المقرر
- ▸الدفتر (notebook): Linear_Regression_Practice، وفيه أسعار 5000 منزل في الولايات المتحدة
- ▸سيناريو من الواقع: التنبؤ بأسعار المنازل (Predict House Pricing)
- ▸مرحلة المشروع (project milestone) هذا الأسبوع: استكشاف بيانات المشروع وتنظيفها (Project Data Exploration and Data Cleaning)
خطة الساعتين
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | الفكرة، والمربعات الصغرى، ومثال محلول يدويا | 35 دقيقة |
| 2 | الدفتر: استكشاف بيانات المنازل وتجهيزها | 20 دقيقة |
| 3 | الدفتر: ملاءمة النموذج، وقراءة المعاملات | 20 دقيقة |
| 4 | التقييم على مجموعة الاختبار، ومشروعك | 15 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1
فكرة الانحدار الخطي
خط مستقيم عبر البيانات
ما الانحدار الخطي؟
- الانحدار الخطي (Linear regression)
- طريقة خطية لنمذجة العلاقة بين متغير تابع (dependent variable) عددي
yومتغير تفسيري (explanatory variable) واحد أو أكثرX.
- ▸متغير تفسيري واحد: الانحدار الخطي البسيط
- ▸أكثر من متغير واحد: الانحدار الخطي المتعدد
- ▸يلاءم عادة بطريقة المربعات الصغرى (least squares)
النموذج خط مستقيم
- ▸
x: المدخل، مثل دخل المنطقة - ▸
ŷ("y hat"): القيمة المتنبأ بها، مثل السعر - ▸
b₁: الميل، وهو مقدار تغيرŷعندما تزيدxبمقدار 1 - ▸
b₀: المقطع، وهو قيمةŷعندx = 0
البواقي: خطأ كل نقطة
- ▸
yهي القيمة الحقيقية، وŷهي التنبؤ - ▸النقطة الواقعة فوق الخط لها باق موجب، والواقعة تحته لها باق سالب
- ▸على الرسم، الباقي هو المسافة الرأسية من النقطة إلى الخط
المربعات الصغرى
- ▸
SSE: مجموع مربعات الأخطاء (sum of squared errors) على كل النقاط، وعددهاn - ▸خط المربعات الصغرى هو الخط الذي له أصغر SSE
- ▸التربيع يجعل كل خطأ موجبا ويعاقب الأخطاء الكبيرة أكثر
يدويا
مثال محلول: خمسة منازل حقيقية
صفوف من USA_Housing.csv. x: الدخل بوحدة 10,000 دولار، وy: السعر بوحدة 100,000 دولار، بعد التقريب
| المنزل | الدخل | السعر | (x, y) |
|---|---|---|---|
| H1 | $50,016 | $497,368 | (5, 5) |
| H2 | $59,769 | $897,291 | (6, 9) |
| H3 | $69,529 | $995,137 | (7, 10) |
| H4 | $79,628 | $1,196,064 | (8, 12) |
| H5 | $89,548 | $1,403,803 | (9, 14) |
الخطوة 1: المتوسطان
الخطوة 2: الانحرافات عن المتوسطين
| المنزل | (x − x̄, y − ȳ) | حاصل الضرب | (x − x̄)² |
|---|---|---|---|
| H1 | (-2, -5) | 10 | 4 |
| H2 | (-1, -1) | 1 | 1 |
| H3 | (0, 0) | 0 | 0 |
| H4 | (1, 2) | 2 | 1 |
| H5 | (2, 4) | 8 | 4 |
الخطوة 3: الميل والمقطع
الخطوة 4: التنبؤات والبواقي
| المنزل | ŷ | e = y − ŷ | e² |
|---|---|---|---|
| H1 | 5.8 | -0.8 | 0.64 |
| H2 | 7.9 | 1.1 | 1.21 |
| H3 | 10.0 | 0.0 | 0.00 |
| H4 | 12.1 | -0.1 | 0.01 |
| H5 | 14.2 | -0.2 | 0.04 |
الخطوة 5: هل هو حقا أفضل خط؟
| الخط | SSE |
|---|---|
| ŷ = −3 + 2x | 7.0 |
| ŷ = −4 + 2x | 2.0 |
| ŷ = −4.7 + 2.1x | 1.9 |
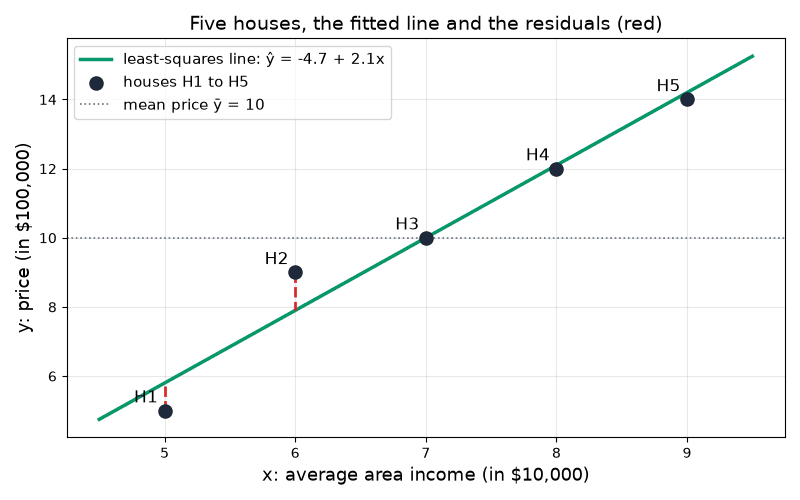
الخطوة 6: التنبؤ لمنطقة جديدة
جرب بنفسك: المربعات الصغرى مباشرة
قياس خطأ الخط
- ▸MAE، متوسط الخطأ المطلق (mean absolute error): متوسط حجم الخطأ، بوحدات
y - ▸MSE، متوسط مربع الخطأ (mean squared error): متوسط الخطأ المربع، بوحدات مربعة
- ▸RMSE، الجذر التربيعي لمتوسط مربع الخطأ (root mean squared error): يعود إلى وحدات
y، والأخطاء الكبيرة فيه أثقل وزنا منها في MAE
مثال محلول: MAE وMSE وRMSE
R²: هل الخط أفضل من المتوسط؟
- ▸
SST: قيمة SSE للخط الأفقيŷ = ȳ، وهو أفضل تخمين دون أي خاصية - ▸معامل التحديد (coefficient of determination) R² هو نسبة ما يزيله النموذج من هذا الخطأ: 1 ملاءمة تامة، و0 تعني أن النموذج ليس أفضل من المتوسط
جرب بنفسك: ماذا يقيس R²
الجزء 2
استكشاف بيانات المنازل
الدفتر، ومرحلة المشروع لهذا الأسبوع
افتح الدفتر في Colab
https://colab.research.google.com/github/
tirthajyoti/Machine-Learning-with-Python/blob/
master/Regression/Linear_Regression_Practice.ipynbتحميل البيانات وفحصها
url = ("https://raw.githubusercontent.com/"
       "tirthajyoti/Machine-Learning-with-Python/"
       "master/Datasets/USA_Housing.csv")
df = pd.read_csv(url)
df.info(verbose=True)- ▸5000 صف، و7 أعمدة، وكلها
5000 non-null: لا توجد قيم مفقودة (missing values) - ▸خمس خصائص عددية والهدف (target)
Price - ▸
Addressنص: النموذج الخطي لا يضرب إلا الأعداد، لذا يبقى خارجX
توزيع السعر
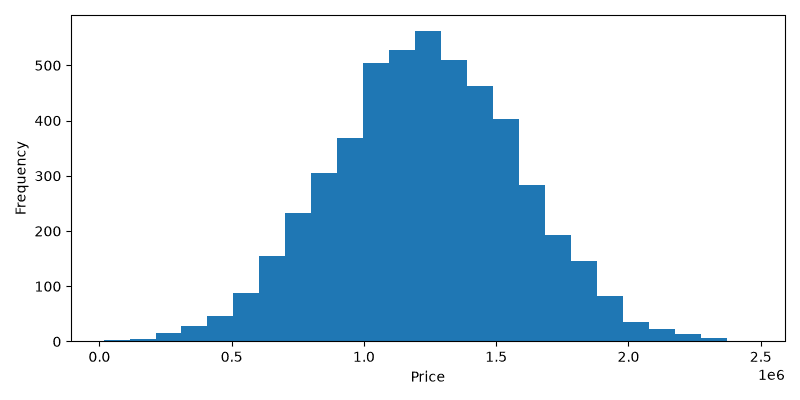
df['Price'].plot.hist(bins=25, figsize=(8,4))- ▸تل واحد حول المتوسط البالغ نحو 1.23 مليون دولار
- ▸سعر 97 منزلا فقط أقل من 0.5 مليون دولار، وسعر 74 منزلا فقط أعلى من 2 مليون دولار
- ▸
1e6أسفل المحور: أرقام التدريج بالملايين
الارتباطات مع السعر
df.corr(numeric_only=True)

sns.heatmap(df.corr(numeric_only=True),
            annot=True, linewidths=2)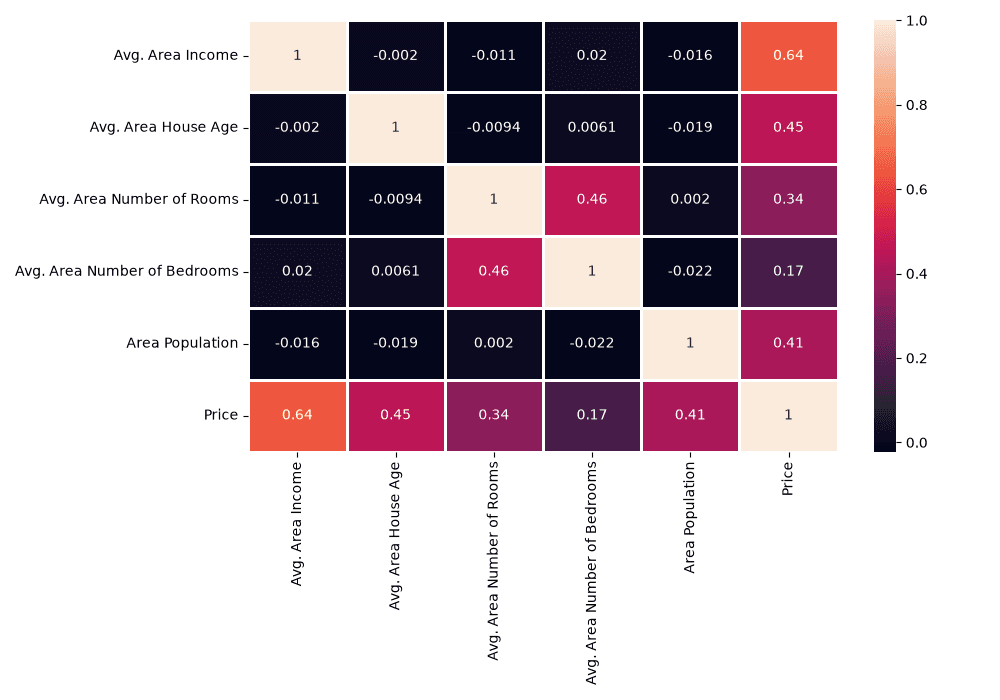
قراءة صف السعر
| الخاصية | الارتباط مع Price |
|---|---|
| Avg. Area Income | 0.640 |
| Avg. Area House Age | 0.453 |
| Area Population | 0.409 |
| Avg. Area Number of Rooms | 0.336 |
| Avg. Area Number of Bedrooms | 0.171 |
الجزء 3
ملاءمة النموذج
LinearRegression في scikit-learn
الخصائص، والهدف، والتقسيم
X = df[l_column[0:len_feature-2]]   # 5 features
y = df[l_column[len_feature-2]]     # Price

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=123)sklearn.cross_validation، وهي وحدة لم تعد موجودة: استخدم sklearn.model_selection.الملاءمة وقراءة المعاملات
lm = LinearRegression()
lm.fit(X_train, y_train)
print(lm.intercept_)

cdf = pd.DataFrame(data=lm.coef_,
    index=X_train.columns,
columns=['Coefficients'])| الخاصية | المعامل |
|---|---|
| الدخل | 21.597602 |
| عمر المنزل | 165201.104954 |
| الغرف | 119061.463868 |
| غرف النوم | 3212.585606 |
| السكان | 15.228121 |
قراءة المعامل
- ▸المعامل هو مقدار تغير
ŷعندما تزيد خاصيته وحدها بمقدار 1 وتبقى الخصائص الأخرى كما هي
مثال محلول: منزل اختبار واحد يدويا
الصف 2648، وهو منزل الاختبار الأول. السعر الحقيقي: 800,146.23 دولار
| الخاصية | x | b × x |
|---|---|---|
| الدخل | 63824.394539 | 1,378,453.87 |
| عمر المنزل | 4.991750 | 824,642.62 |
| الغرف | 5.003836 | 595,764.04 |
| غرف النوم | 4.00 | 12,850.34 |
| السكان | 40086.458749 | 610,441.44 |
مثال محلول: أضف المقطع
أي الخصائص أهم؟
يقسم الدفتر كل معامل على خطئه المعياري (standard error): والناتج هو إحصائية t (t-statistic)
| الخاصية | إحصائية t |
|---|---|
| Avg. Area Income | 134.68 |
| Avg. Area House Age | 95.91 |
| Area Population | 89.64 |
| Avg. Area Number of Rooms | 70.18 |
| Avg. Area Number of Bedrooms | 2.33 |
الجزء 4
تقييم النموذج
التنبؤ بأسعار 1500 منزل اختبار
الفعلي مقابل المتنبأ به
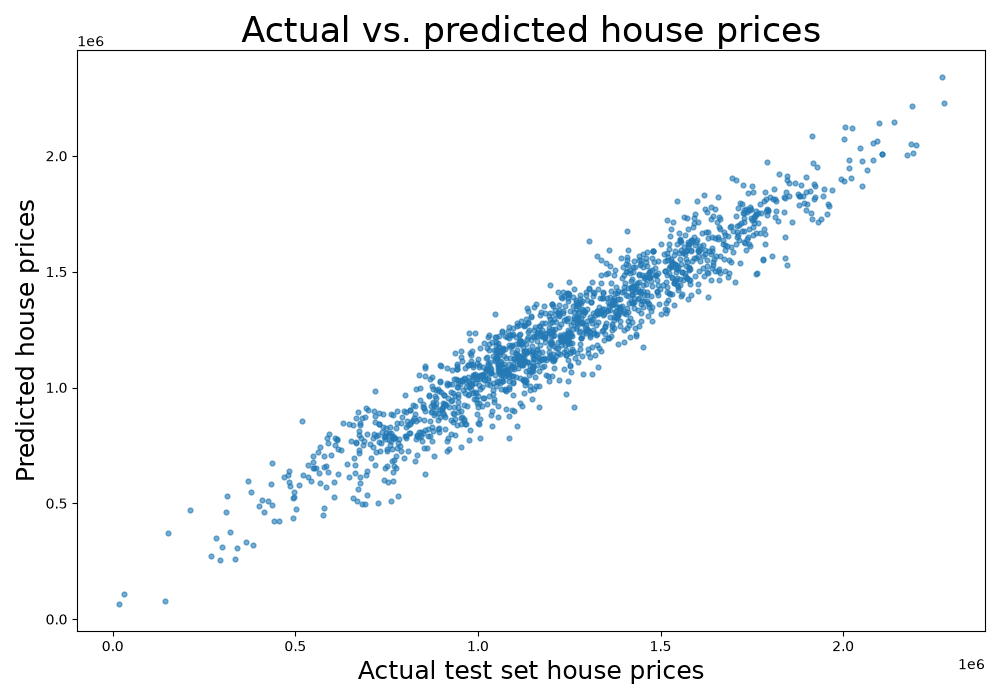
predictions = lm.predict(X_test)

plt.scatter(x=y_test, y=predictions)- ▸
predictions: 1500 سعر، سعر واحد لكل منزل اختبار - ▸النموذج المثالي يضع كل نقطة على الخط المائل بزاوية 45 درجة
- ▸تشكل النقاط شريطا ضيقا على امتداده، في المنازل الرخيصة والغالية على السواء
فحص البواقي
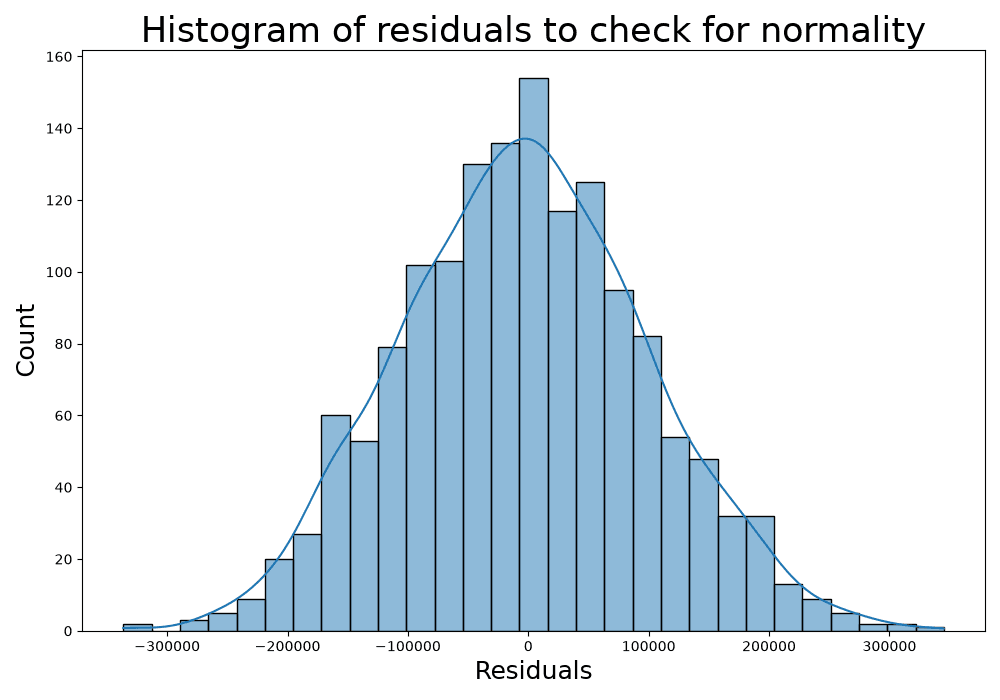
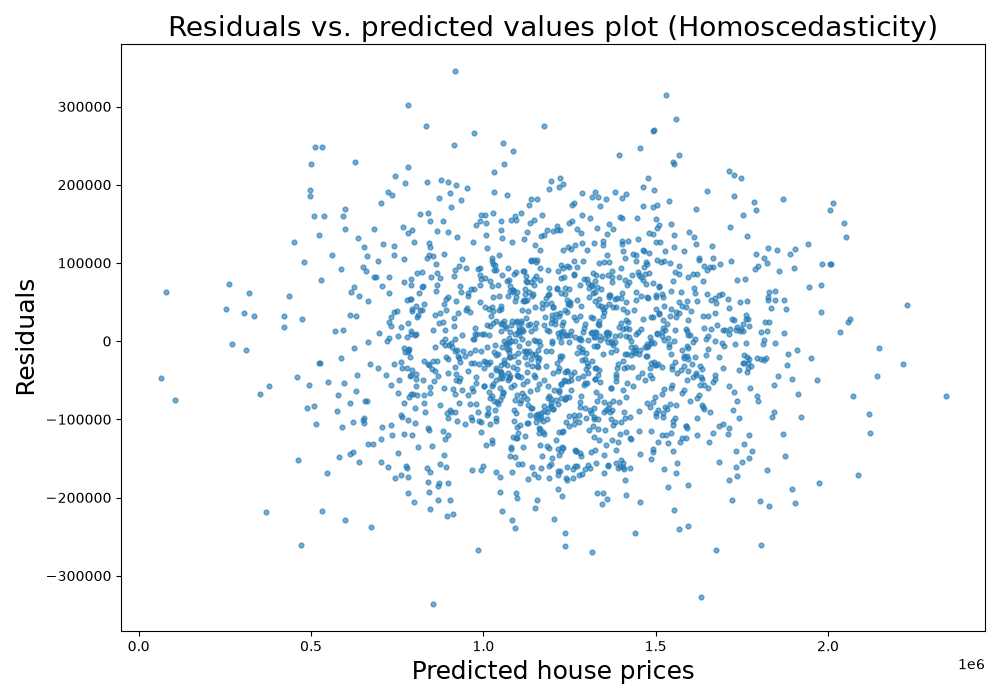
مقاييس الخطأ
Mean absolute error (MAE): 81739.77482718184
Mean square error (MSE): 10489638335.804983
Root mean square error (RMSE): 102418.93543581179
R-squared value of predictions: 0.919قراءة الأعداد
| المقياس | القيمة | المعنى |
|---|---|---|
| MAE | $81,740 | متوسط حجم الخطأ |
| RMSE | $102,419 | الخطأ المعتاد، نحو 8% من متوسط السعر |
| R² على الاختبار | 0.919 | يفسر نحو 92% من تشتت الأسعار |
| R² على التدريب | 0.917 | الأداء على المنازل الجديدة جيد بقدر الأداء على المنازل التي رآها |
قبل التمارين
الأخطاء الشائعة
- ▸تشغيل الاستدعاءات القديمة كما هي:
cross_validation، وdf.corr()مع عمود نصي، وdistplot - ▸قراءة
./Datasets/USA_Housing.csvفي Colab - ▸إبقاء العمود النصي
AddressفيX - ▸ترتيب الخصائص حسب حجم المعامل حين تختلف وحداتها
- ▸الاكتفاء بقيمة R² على التدريب
- ▸الوثوق بتنبؤ بعيد جدا خارج نطاق بيانات التدريب، مثل المقطع عند دخل 0
مشروع فريقك
مرحلة المشروع: استكشف بياناتك ونظفها
- 1افحص
shapeوالأعمدة والأنواع باستخدامinfo() - 2احسب عدد القيم المفقودة باستخدام
isnull().sum()، ثمfillnaأوdropna(الأسبوع 1) - 3شغل
describe()وابحث عن القيم المستحيلة - 4ارسم الهدف في مدرج تكراري، وكل خاصية مقابله
- 5ارسم الخريطة الحرارية للارتباط باستخدام
numeric_only=True - 6احذف الأعمدة التي لا يستطيع النموذج استخدامها، مثل النص الحر أو المعرفات (IDs)
الجزء 5
التمارين: دورك
نحو 30 دقيقة، والإجابات بعد كل تمرين
نحو 10 دقائق
التمرين 1: ملاءمة خط يدويا
| المنطقة | x (الدخل، 10,000 دولار) | y (السعر، 100,000 دولار) |
|---|---|---|
| A1 | 4 | 6 |
| A2 | 5 | 7 |
| A3 | 6 | 10 |
| A4 | 7 | 11 |
| A5 | 8 | 11 |
- ▸احسب
x̄وȳوالميلb₁والمقطعb₀ - ▸احسب البواقي وSSE وMSE وRMSE وMAE وR²
- ▸تنبأ بالسعر لدخل قدره 65,000 دولار
الإجابات
التمرين 1: الإجابة، الخط
الإجابات
التمرين 1: الإجابة، الخطأ
| المنطقة | ŷ | e | e² |
|---|---|---|---|
| A1 | 6.2 | -0.2 | 0.04 |
| A2 | 7.6 | -0.6 | 0.36 |
| A3 | 9.0 | 1.0 | 1.00 |
| A4 | 10.4 | 0.6 | 0.36 |
| A5 | 11.8 | -0.8 | 0.64 |
نحو 5 دقائق
التمرين 2: منزل اختبار ثان
الصف 2456، والسعر الحقيقي 707,345.06 دولار، والمقطع -2,631,028.90. تنبأ بالسعر، ثم أوجد الباقي.
| الخاصية | x | المعامل b |
|---|---|---|
| الدخل | 67041.967661 | 21.597602 |
| عمر المنزل | 6.021458 | 165201.104954 |
| الغرف | 5.346830 | 119061.463868 |
| غرف النوم | 3.39 | 3212.585606 |
| السكان | 15633.099048 | 15.228121 |
نحو 5 دقائق
التمرين 3: قراءة المعاملات
- ▸منطقتان تختلفان فقط في عمر المنازل بفارق 2، أي بسنتين. ما الفرق بين التنبؤين؟
- ▸وإذا اختلفتا فقط في الدخل بفارق 5,000 دولار، فما الفرق الآن؟
- ▸لماذا لا يعني معامل غرف النوم، 3212.59، أن غرف النوم أهم من الدخل؟
نحو 10 دقائق
التمرين 4: في Colab
- 1شغل الدفتر مع إصلاحات اليوم الثلاثة، حتى مقاييس الخطأ
- 2لائم
lm1علىX_train[['Avg. Area Income']]فقط: اطبع المقطع، والمعامل، وقيم R² وMAE وRMSE على الاختبار - 3لائم نموذجا على كل الخصائص عدا
Avg. Area Number of Bedrooms(drop(..., axis=1)) واطبع قيمة R² على الاختبار - 4قارن قيم R² الثلاث: ماذا تقول عن الخصائص؟
الإجابات
التمرين 4: الإجابة
| النموذج | R² على الاختبار | RMSE على الاختبار |
|---|---|---|
| الخصائص الخمس كلها | 0.919 | 102,418.94 |
| الدخل فقط | 0.417 | 275,407.48 |
| كل الخصائص عدا غرف النوم | 0.920 | 102,282.54 |
الخلاصة
- 1يتنبأ الانحدار الخطي بعدد على أنه
b0مضافا إليه مجموع موزون للخصائص - 2الباقي هو
y − ŷ؛ والمربعات الصغرى تجعل مجموع مربعات البواقي أصغر ما يمكن - 3استكشف البيانات ونظفها أولا: الأنواع، والقيم المفقودة، والأعمدة النصية، والارتباطات
- 4المعامل هو مقدار التغير لكل وحدة من خاصيته: رتب الخصائص حسب إحصائية t
- 5احكم على النموذج بمجموعة الاختبار باستخدام MAE وRMSE وR² ورسوم البواقي
افتح هذا الدرس
Mahmoud Abas|الانحدار الخطي