

جارٍ تحميل الدرس...
في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 1
تحميل البيانات من ملفات CSV والملفات النصية وExcel وHTML وJSON في DataFrame، ثم تصفيتها وتجميعها وتنظيفها وضمها وإعادة تشكيلها.
sep وheader وnames وskiprows وskipfooter وnrowsloc وقناع منطقي (boolean mask)، وتلخيص الأعمدة باستخدام describepivot_table للتجميع (aggregation)، وapply لإنشاء أعمدة جديدةisnull وfillna وdropnaconcat وmerge وjoinالأسبوع 1 من الخطة
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | قراءة البيانات من مصادر متعددة | 35 دقيقة |
| 2 | الاختيار والتصفية والتجميع | 25 دقيقة |
| 3 | القيم المفقودة وضم الجداول وإعادة التشكيل (reshaping) | 25 دقيقة |
| 4 | الأخطاء الشائعة ومرحلة المشروع | 5 دقائق |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1
دالة واحدة لكل صيغة، وDataFrame واحد في النهاية
| المصدر | دالة pandas | ما تعيده |
|---|---|---|
| CSV، وCSV مضغوط | pd.read_csv | DataFrame واحد |
| نص آخر تفصل قيمه بفاصل (separator) | pd.read_table | DataFrame واحد |
| مصنف (workbook) Excel | pd.read_excel | DataFrame واحد، أو قاموس (dict) من DataFrame |
| جداول في صفحة ويب | pd.read_html | قائمة من DataFrame |
| ملف JSON | pd.read_json | DataFrame واحد |
base = ("https://raw.githubusercontent.com/tirthajyoti/"
        "Machine-Learning-with-Python/master/Pandas%20and%20Numpy/"
        "Read_data_various_sources/")
df1 = pd.read_csv(base + "CSV_EX_1.csv")
df1.shape # (5, 4)CSV_EX_1.csv، خمسة منازل
Bedroom, Sq. foot, Locality, Price ($)
2, 1500, Good, 300000
3, 1300, Fair, 240000
3, 1900, Very good, 450000
3, 1850, Bad, 280000
2, 1640, Good, 310000df1 = pd.read_csv("CSV_EX_1.csv")
df1.shape # (5, 4)int64، وتبقى الكلمات نصايضم CSV_EX_2.csv المنازل الخمسة نفسها، دون سطر العناوين (header)
   2   1500        Good   300000
0  3   1300        Fair   240000
1  3   1900   Very good   450000
2  3   1850         Bad   280000
3 2 1640 Good 310000df2 = pd.read_csv("CSV_EX_2.csv",
header=None,
names=['Bedroom', 'Sq.ft',
'Locality', 'Price($)']) Bedroom Sq.ft Locality Price($)
0 2 1500 Good 300000
1 3 1300 Fair 240000
2 3 1900 Very good 450000
3 3 1850 Bad 280000
4 2 1640 Good 310000CSV_EX_3.csv: Bedroom; Sq. foot; Locality; Price ($)
df3.shape هي (5, 1): لا توجد فاصلة، لذا يبقى كل سطر قيمة نصية واحدةpd.read_csv("CSV_EX_3.csv", sep=';')، الذي يعطي (5, 4)CSV_EX_skipfooter.csv
Filetype: CSV,,,
,Info about some houses,,
Bedroom, Sq. foot, Locality, Price ($)
2,1500, Good,300000
...
2,1640, Good,310000
, This is the end of file,,Filetype: CSV وUnnamed: 1 وUnnamed: 2 وUnnamed: 3skiprows=2, skipfooter=1, engine='python' يعطي الجدول السليم (5, 4)rows_in_a_chunk = 10
num_chunks = 5
colnames = pd.read_csv("Boston_housing.csv", nrows=2).columns
list_of_dataframe = []
for i in range(0, num_chunks*rows_in_a_chunk, rows_in_a_chunk):
df = pd.read_csv("Boston_housing.csv", header=0, skiprows=i,
nrows=rows_in_a_chunk, names=colnames)
list_of_dataframe.append(df)nrows=2 أول 2 من الصفوف فقطi، ثم تقرأ 10 أسطر تاليةفي CSV_EX_blankline.csv سطران فارغان بين المنازل
| الخيار | الشكل | ما تراه |
|---|---|---|
الافتراضي (True) | (5, 4) | الأسطر الفارغة متخطاة |
skip_blank_lines=False | (7, 4) | صفان من NaN، وتصبح القيمة 2 هي 2.0 |
pd.read_csv("CSV_EX_1.zip") الامتداد .zip فيفك الضغط أثناء القراءةcompression هي 'infer'CSV_EX_1.csv العاديpd.read_excel("Housing_data.xlsx", sheet_name='Data_Tab_1')| الورقة | الشكل |
|---|---|
Data_Tab_1 | (9, 14) |
Data_Tab_2 | (4, 14) |
Data_Tab_3 | (16, 14) |
pd.read_table("Table_tab_separated.txt")   # (5, 4)
pd.read_table("Table_EX_1.txt")             # (5, 1)
pd.read_table("Table_EX_1.txt", sep=',') # (5, 4)read_table هي read_csv مع علامة الجدولة (tab) قيمة افتراضية للوسيط sepTable_tab_separated.txt علامات الجدولة: جدول سليم (5, 4)Table_EX_1.txt الفواصل: عمود واحد، (5, 1)، إلى أن تمرر sep=','يعيد pd.read_html(url, header=0) قائمة فيها DataFrame لكل جدول HTML
| Rank | NOC | Gold | Total |
|---|---|---|---|
| 1 | United States | 46 | 121 |
| 2 | Great Britain | 27 | 67 |
| 3 | China | 26 | 70 |
| 4 | Russia‡ | 19 | 56 |
| 5 | Germany | 17 | 42 |
[
  {"Bedroom": 2, "Sq. foot": 1500,
   "Locality": "Good", "Price ($)": 300000},
  ...
]dj = pd.read_json('houses.json')
dj[dj['Locality'] == 'Good'] # rows 0 and 4read_json قائمة من السجلات (records) إلى صفوف: الجدول (5, 4) نفسهpd.read_stata("rscfp2016.dta") ملف بيانات Stata بالطريقة نفسهاread_pdf من الحزمة المستقلة tabula-py الجداول من صفحات PDFnames عبر pandas_optionsالجزء 2
الدفتر Advanced Pandas Operations، على طلبات المتجر
https://colab.research.google.com/github/
tirthajyoti/Machine-Learning-with-Python/blob/master/
Pandas%20and%20Numpy/Advanced%20Pandas%20Operations.ipynbSample - Superstore.xls من مجلده الخاص، وهذا المجلد غير موجود في Colaburl = ("https://raw.githubusercontent.com/tirthajyoti/"
"Machine-Learning-with-Python/master/"
"Pandas%20and%20Numpy/Sample%20-%20Superstore.xls")
df = pd.read_excel(url)
df.shape # (9994, 21)
df.drop('Row ID', axis=1, inplace=True)
df.shape # (9994, 20)Sales وQuantity وDiscount وProfitOrders وReturns وPeople وMissingيأخذ loc قائمة من تسميات الفهرس (index labels) وقائمة من أسماء الأعمدة
df.loc[[i for i in range(5, 10)],
['Customer ID', 'City', 'Postal Code', 'Sales']]| الصف | Customer ID | City | Sales |
|---|---|---|---|
| 5 | BH-11710 | Los Angeles | 48.860 |
| 6 | BH-11710 | Los Angeles | 7.280 |
| 7 | BH-11710 | Los Angeles | 907.152 |
| 8 | BH-11710 | Los Angeles | 18.504 |
| 9 | BH-11710 | Los Angeles | 114.900 |
df_subset = df.loc[[i for i in
    range(100, 200)], ['Sales', 'Profit']]
df_subset.describe()| المقياس | Sales | Profit |
|---|---|---|
| mean | 262.957 | 0.348 |
| std | 858.984 | 170.745 |
| min | 1.788 | -1359.992 |
| 50% (الوسيط) | 66.960 | 9.654 |
| max | 8159.952 | 585.552 |
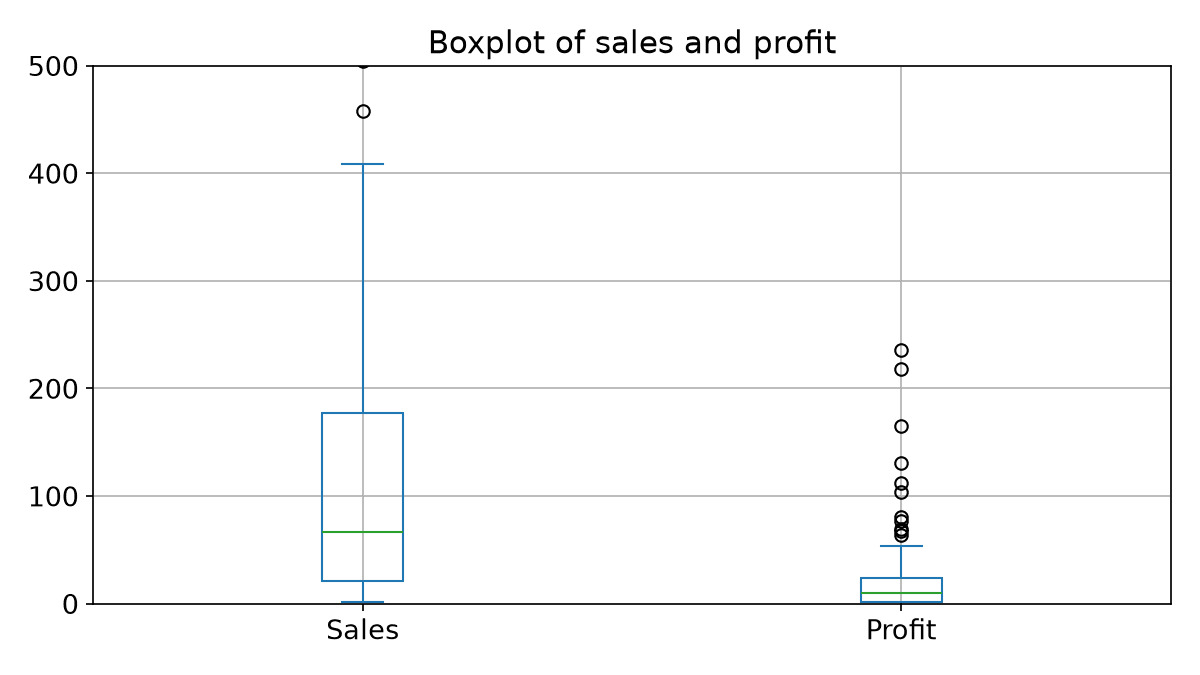
df_subset.plot.box() صندوقا لكل عمودplt.ylim(0, 500) الرسم، فتقع خارج المخطط 12 قيمة مبيعات و1 من قيم الربح فوق 500، و20 قيمة ربح سالبةdf_subset.plot.box()
plt.ylim(0, 500)
plt.grid(True)df_subset = df.loc[[i for i in range(10)], ['Ship Mode', 'State', 'Sales']]
        Ship Mode       State     Sales
0    Second Class    Kentucky  261.9600
1    Second Class    Kentucky  731.9400
2    Second Class  California   14.6200
3  Standard Class     Florida  957.5775
4  Standard Class     Florida   22.3680
5  Standard Class  California   48.8600
6  Standard Class  California    7.2800
7  Standard Class  California  907.1520
8  Standard Class  California   18.5040
9 Standard Class California 114.9000df_subset[(df_subset['State'] != 'California') & (df_subset['Sales'] > 100)]& الشرطين معا، ويعني | أحدهما على الأقل، ويحتاج كل شرط إلى قوسيه الخاصينالتقسيم
الصفوف حسب State
التطبيق
متوسط كل مجموعة
الدمج
صف لكل State
byState = df_subset.groupby('State')
byState.mean(numeric_only=True)| كود الدفتر | اليوم | اكتب بدلا منه |
|---|---|---|
byState.mean() | TypeError: لا يمكن حساب متوسط الأعمدة النصية | byState.mean(numeric_only=True) |
byState.sum() | يلصق نصوص Ship Mode بعضها ببعض | byState.sum(numeric_only=True) |
byState['Sales'].mean() | يعمل | الشيء نفسه، في صورة Series |
الجزء 3
الورقة Missing ومقتطفات صغيرة من الطلبات
df_missing = pd.read_excel(url, sheet_name='Missing')
for c in df_missing.columns:
    miss = df_missing[c].isnull().sum()
    if miss > 0:
        print('{} has {} missing value(s)'.format(c, miss))
    else:
print('{} has NO missing value!'.format(c))Customer has 1 missing value(s)
Product has 2 missing value(s)
Sales has 1 missing value(s)
Quantity has 1 missing value(s)
Discount has NO missing value!
Profit has 1 missing value(s)قيم Sales في الصفوف 2 إلى 4 هي 8.560 وNaN و22.720، ومجموع القيم الـ10 الأخرى 3015.52
ffill() القيمة التي فوقها: 8.56bfill() القيمة التي تحتها: 22.72| الاستدعاء | ما يبقى |
|---|---|
dropna(axis=0) | ؟ |
dropna(axis=1) | ؟ |
dropna(axis=1, thresh=10) | ؟ |
axis=0: 6 صفوف بلا قيم مفقودة (1، 2، 4، 6، 9، 10)axis=1: Discount وحده، العمود الكامل الوحيدthresh=10: الأعمدة التي فيها 10 قيم على الأقل، لذا لا يحذف إلا Product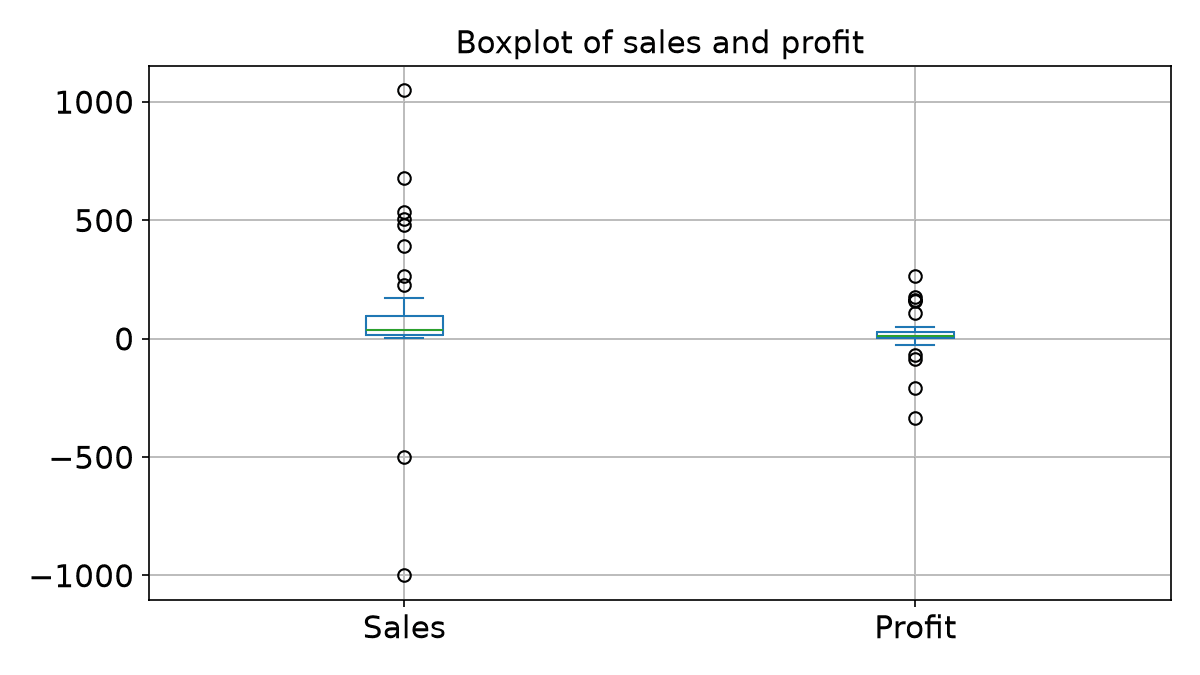
ثلاثة جداول في كل منها 2 من الطلبات، بالأعمدة Customer ID وState وSales وProfit، والصفوف 0 إلى 5
axis=0 الصفوف: (6, 4)axis=1 الجداول جنبا إلى جنب، مطابقة حسب الفهرس: (6, 12)axis=1 48 من الخلايا الـ72 بقيمة NaNdf_1 وdf_2: الصفوف 0 إلى 3، والمفاتيح (keys) CG-12520 مرتين، وDV-13045، وSO-20335
pd.merge(df_1, df_2, on='Customer ID', how='inner')df_1 مع df_3 (الصفوف 2 إلى 5: DV-13045، وSO-20335 مرتين، وBH-11710)
| how | ما يبقيه | الصفوف |
|---|---|---|
inner | المفاتيح الموجودة في الجدولين | 3 |
left | كل صفوف df_1 | 5 |
right | كل صفوف df_3 | 4 |
outer | كل المفاتيح، مرتبة | 6 |
df.pivot_table(values=['Sales', 'Quantity', 'Profit'], index=['Region'], aggfunc='mean')| Region | Profit | Quantity | Sales |
|---|---|---|---|
| Central | 17.09 | 3.78 | 215.77 |
| East | 32.14 | 3.73 | 238.34 |
| South | 28.86 | 3.83 | 241.80 |
| West | 33.85 | 3.83 | 226.49 |
df['Ship Mode'].value_counts()| Ship Mode | الطلبات |
|---|---|
| Standard Class | 5968 |
| Second Class | 1945 |
| First Class | 1538 |
| Same Day | 543 |
df_subset.sort_values(by='Sales')
df_subset.sort_values(by=['State', 'Sales'])Sales: يأتي الصف 6 (7.28) أولا والصف 3 (957.5775) أخيرا['State', 'Sales']: الترتيب حسب State أولا، ثم يفصل Sales بين الصفوف المتساويةcategorize_sales: القيمة Low لما هو أقل من 50، وMedium لما هو أقل من 200، وHigh لما سوى ذلك
def categorize_sales(price):
    if price < 50:
        return "Low"
    elif price < 200:
        return "Medium"
    else:
        return "High"

df['Sales'].apply(categorize_sales)الجزء 4
خمس دقائق قبل التمارين
قبل التمارين
sep لا تطابق الملفheader=None& أو |fillna(method=)، وmean() على الأعمدة النصية، والإسناد المتسلسل (chained assignment)مشروع فريقك
shape وأسماء الأعمدة وisnull().sum() قبل أي شيء آخرالجزء 5
نحو 30 دقيقة، وتأتي الإجابة بعد كل مهمة
نحو 5 دقائق
Exported by the lab system
Section 3
ID;Name;Quiz;Lab
101;A1;7;9
102;B2;5;8
103;C3;9;10
104;D4;6;7
End of exportpd.read_csv('p1_scores.txt', sep=';', skiprows=2,
skipfooter=1, engine='python')نحو 8 دقائق
  Region       Ship Mode  Sales
0   East     First Class  120.0
1   West  Standard Class   45.5
2   East  Standard Class  310.0
3  South    Second Class   80.0
4   West     First Class  220.0
5  South  Standard Class   15.0
6   East    Second Class   95.0
7 West Standard Class 60.5categorize_salesنحو 5 دقائق
Qty = 4, NaN, 6, NaN, 10 وPrice = 2.5, 3.0, NaN, 4.0, 5.5 وItem = pen, ink, None, pad, tape
ffill() وbfill() للعمود Qtydropna(axis=0)؟ وما الأعمدة التي تبقى بعد dropna(axis=1, thresh=4)؟نحو 5 دقائق
left: Key = K1, K2, K2, K3 مع A = 1, 2, 3, 4. وright: Key = K2, K3, K3, K4 مع B = 10, 20, 30, 40
| how | الصفوف | السبب |
|---|---|---|
inner | 4 | K2: 2 × 1، وK3: 1 × 2 |
left | 5 | صفوف inner الـ4 + K1 مع NaN |
right | 5 | صفوف inner الـ4 + K4 مع NaN |
outer | 6 | صفوف inner الـ4 + K1 + K4 |
نحو 7 دقائق
groupbypivot_table: ما المنطقة الأدنى؟الإجابات
| السؤال | الإجابة |
|---|---|
| طلبات Texas | 985 |
| Sales لكل Category | Furniture 741999.80، وOffice Supplies 719047.03، وTechnology 836154.03 |
| Profit لكل Category | Furniture 18451.27، وOffice Supplies 122490.80، وTechnology 145454.95 |
| الطلبات الخاسرة | 1871 |
| المنطقة الأدنى في Profit | Central، 39706.36 |
read_csv وread_table وread_excel وread_html وread_jsonsep أو headerpivot_table للتلخيصisnull، ثم قرر: الملء أم الحذفconcat أو merge أو join لضم الجداول، ثم عد الصفوف بعدهاMahmoud Abas|عمليات Pandas المتقدمة وقراءة البيانات من مصادر متعددة