

جارٍ تحميل الدرس...
في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 10
حول المراجعة إلى أعداد كلمات، ثم إلى درجة بين 0 و1 بالانحدار اللوجستي.
CountVectorizer: الأحرف الصغيرة (lower case)، والرموز (tokens)، وكلمات التوقف (stop words)، والكلمات المفردة (unigrams) والأزواج (bigrams)، والمفردات (vocabulary)predict_proba، وشرح مواضع خطأ حقيبة الكلمات (bag of words)الأسبوع 10 من الخطة
0 أو 1| المراجعة | ما تتوقعه الخطة |
|---|---|
| Best meal I've ever had and awesome service, too! | 0.9 أو أكثر |
| Long lines and poor customer service | أقرب إلى 0 |
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 و2 | المشاعر في صورة احتمال؛ من النص إلى الأعداد باستخدام CountVectorizer | 40 دقيقة |
| 3 | حساب درجة مراجعة يدويا | 20 دقيقة |
| 4 | الدفتر في Colab: التدريب، والتقييم، وحساب الدرجات | 20 دقيقة |
| 5 | حدود النموذج، ومشروعك | 10 دقائق |
| 6 | تمارين مع الإجابات | 30 دقيقة |
الجزء 1
التصنيف الثنائي على النص
| المصطلح | في بيانات هذا الأسبوع |
|---|---|
| العينة | مراجعة واحدة، أي سلسلة نصية |
التسمية (label) y | 0 سلبية، 1 إيجابية |
الخصائص (features) x | أعداد الكلمات في المراجعة |
الدرجة p | احتمال أن تكون التسمية 1 |
المراجعة
سلسلة نصية
التحويل إلى متجه
CountVectorizer
حساب z
b + Σ w·x
الضغط
p = σ(z)
القرار
p ≥ 0.5: إيجابية
الجزء 2
CountVectorizer وحقيبة الكلمات
vectorizer = CountVectorizer(
    ngram_range=(1, 2),
    stop_words='english',
    min_df=20)
x = vectorizer.fit_transform(
    df['Text'])
y = df['Sentiment']sklearn.feature_extraction.textpOOr هي poor_the وand، وحتى notcustomer servicemin_df=20)من الدفتر
text = vectorizer.transform(['The long l3ines   and; pOOr customer# service really turned me off...123.'])
text = vectorizer.inverse_transform(text)
print(text)the, long, l3ines, and, poor, customer, service,
really, turned, me, off, 123long, l3ines, poor, customer, service, really, turned, 123long l3ines, l3ines poor, poor customer, customer service,
service really, really turned, turned 123[array(['customer', 'long', 'poor', 'really', 'service', 'turned'],
dtype='<U25')]الكلمات المفردة وحدها. توقع الأعمدة، وخلية المراجعة 2 تحت awesome: فالمحول يعد
vec = CountVectorizer(stop_words='english')
x = vec.fit_transform(['Long lines and poor customer service',
    "Best meal I've ever had and awesome service, too!",
'Awesome meal, awesome service']) awesome best customer lines long meal poor service ve
0 0 0 1 1 1 0 1 1 0
1 1 1 0 0 0 1 0 1 1
2 2 0 0 0 0 1 0 1 0الجزء 3
الانحدار اللوجستي من الأسبوع 4، على أعداد الكلمات
| الرمز الرياضي | المعنى |
|---|---|
b | الحد الثابت، model.intercept_: هنا -0.0488 |
w_i | وزن مدخل المفردات i، من model.coef_ |
x_i | عدد مرات ظهور المدخل i: 0 في الغالب |
σ وe | الدالة السينية؛ وe = 2.71828، وσ(0) = 0.5 |
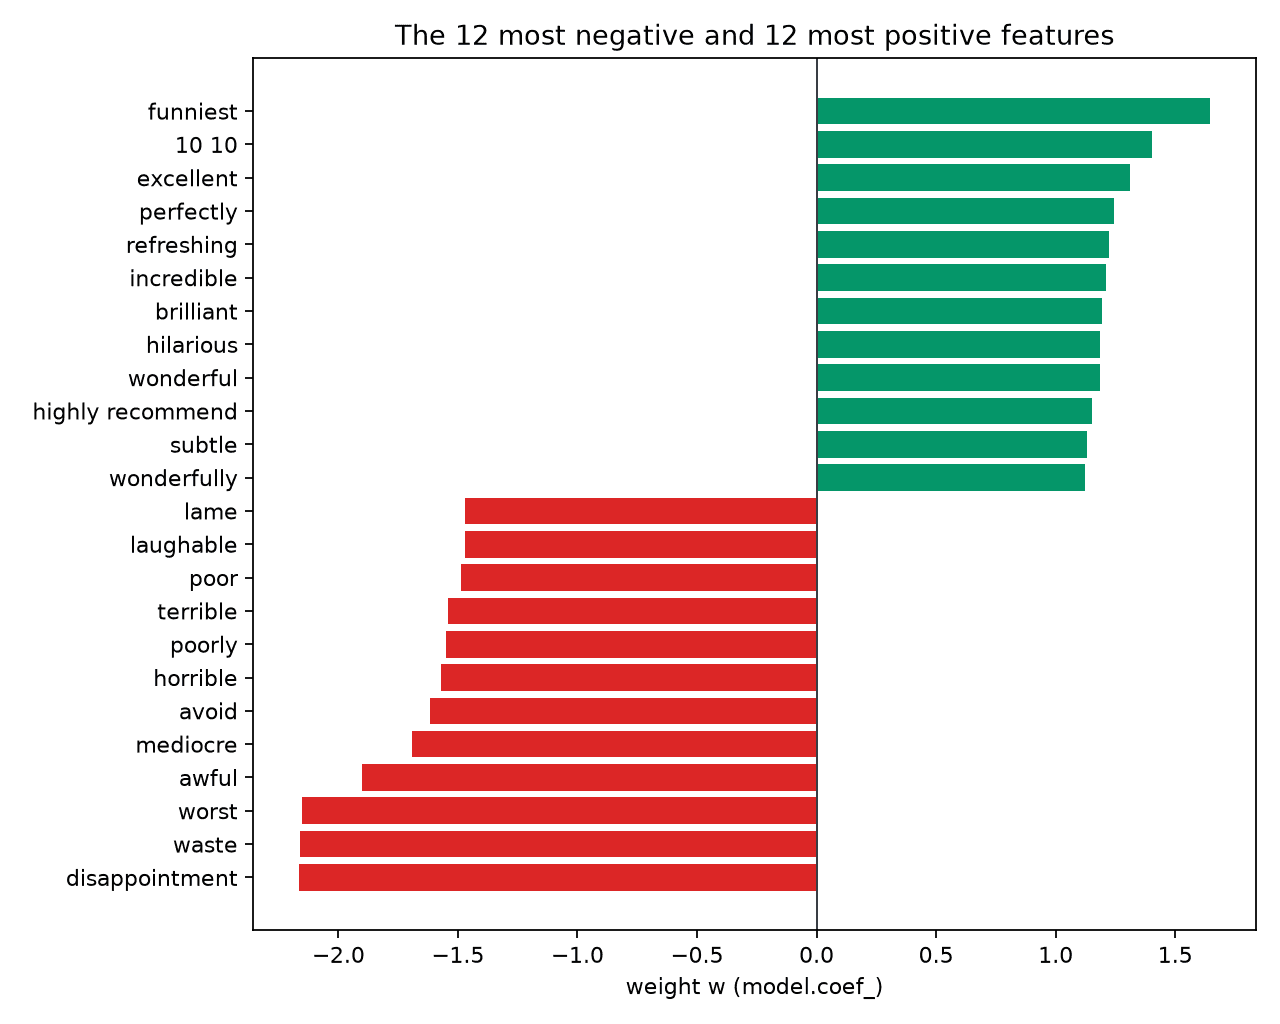
disappointment -2.1646، وwaste -2.1606، وworst -2.1519funniest 1.6471، و10 10 1.4037، وexcellent 1.3094p = σ(-0.0488) = 0.4878يدويا، الخطوة 1
ما الخصائص التي يراها النموذج؟
| الخاصية | x | w | w·x |
|---|---|---|---|
customer | 1 | -0.1980 | -0.1980 |
lines | 1 | -0.1184 | -0.1184 |
long | 1 | -0.0284 | -0.0284 |
poor | 1 | -1.4874 | -1.4874 |
service | 1 | -0.4832 | -0.4832 |
b = -0.0488، والأوزان مقربة إلى 4 منازل عشرية
يدويا، الخطوة 1
Best meal I've ever had and awesome service, too!
| الخاصية | x | w | w·x |
|---|---|---|---|
awesome | 1 | 0.7310 | 0.7310 |
best | 1 | 0.7090 | 0.7090 |
meal | 1 | 0.0062 | 0.0062 |
service | 1 | -0.4832 | -0.4832 |
ve | 1 | -0.0820 | -0.0820 |
تقول الخطة 0.9 أو أكثر
إيجابية، لكن predict_proba تعطي 0.69682
service كلمة سلبية (-0.4832)staff أيضا -0.4587، بينما لا يتجاوز وزن rude القيمة -0.0364Σ w·x صغيرا وتبقى p قرب المنتصفالجزء 4
التدريب، والتقييم، وحساب الدرجات
https://colab.research.google.com/github/
jeffprosise/Machine-Learning/blob/master/
Sentiment%20Analysis.ipynb| في الدفتر | غيره إلى |
|---|---|
read_csv('Data/reviews.csv', ...) | اقرأ الملف من المستودع (الشريحة التالية) |
plot_confusion_matrix(...) | ConfusionMatrixDisplay.from_estimator(...) |
pickle.dump(..., open('Data/sentiment.pkl', 'wb')) | احفظه في 'sentiment.pkl' |
url = ("https://raw.githubusercontent.com/"
       "jeffprosise/Machine-Learning/master/Data/reviews.csv")
df = pd.read_csv(url, encoding="ISO-8859-1")
df.groupby('Sentiment').describe()
df = df.drop_duplicates()x = vectorizer.fit_transform(df['Text'])
y = df['Sentiment']
x_train, x_test, y_train, y_test = train_test_split(
x, y, test_size=0.5, random_state=0)x.shape هو (49581, 33752): 17,528 كلمة مفردة و16,224 زوجاfrom sklearn.linear_model import LogisticRegression
model = LogisticRegression(max_iter=1000, random_state=0)
model.fit(x_train, y_train)fit 33,752 وزنا، وزنا لكل مدخل في المفردات، إضافة إلى الحد الثابت bmax_iter=1000 خوارزمية الحل (solver) مجالا لتتقارب رغم هذا العدد الكبير من الخصائص؛ واحتاج تشغيلنا إلى 78 تكراراLogisticRegression نفسه الذي استخدمناه في الأسبوع 4على مراجعات الاختبار الـ24,791
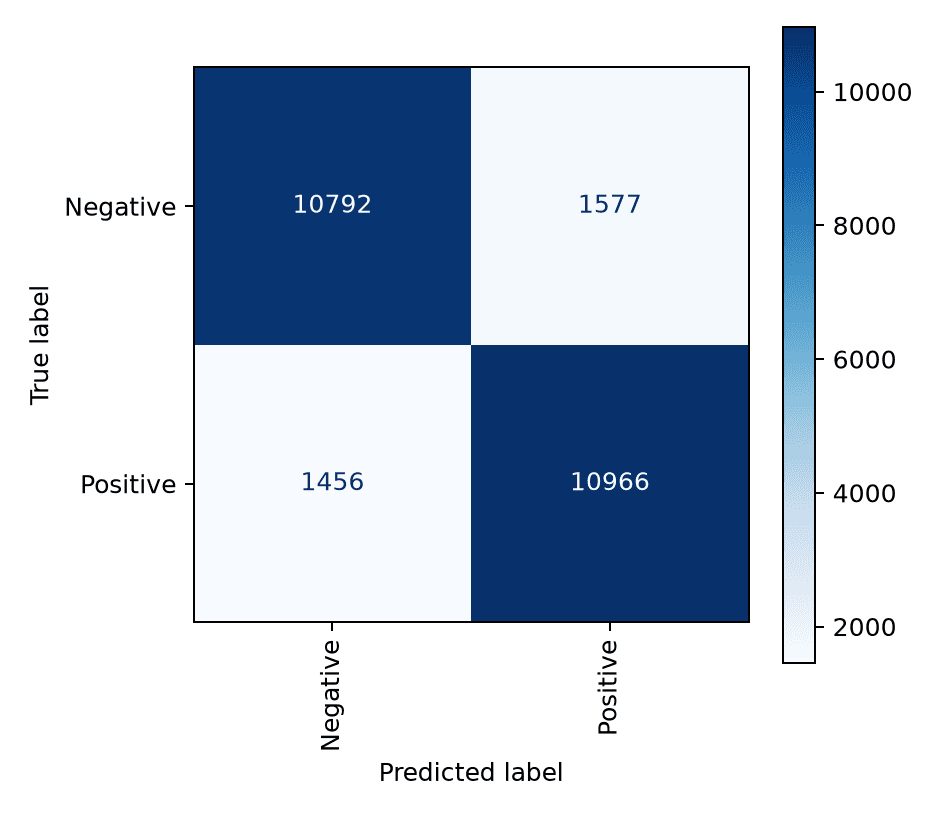
ConfusionMatrixDisplay.from_estimator(
    model, x_test, y_test,
    display_labels=['Negative', 'Positive'],
    cmap='Blues',
xticks_rotation='vertical')TN 10792، FP 1577، FN 1456، TP 10966. توقع الدقة A، والضبط P والاستدعاء R للصنف الإيجابي
from sklearn.metrics import roc_auc_score

probabilities = model.predict_proba(x_test)
roc_auc_score(y_test, probabilities[:, 1])حسبت كلتيهما يدويا. توقع الناتج
reviews = ['Long lines and poor customer service',
           "Best meal I've ever had and awesome service, too!"]
model.predict_proba(vectorizer.transform(reviews))[:, 1][0.08594148 0.69681757]الجزء 5
دقتها 88%، ومع ذلك يسهل خداعها
| المراجعة | الخصائص | p |
|---|---|---|
| The food was good | food وgood | 0.5885 |
| The food was not good | ? | ? |
| المراجعة | p |
|---|---|
| Great food but terrible service | 0.2591 |
| Terrible food but great service | 0.2591 |
قبل أن تتمرن
Data/reviews.csv في Colab من مجلد غير موجود هناكplot_confusion_matrix: استخدم ConfusionMatrixDisplay.from_estimatorfit_transform على المراجعات الجديدة: النص الجديد يحتاج إلى vectorizer.transform([...])transform: فهي تحتاج إلى قائمة من النصوصpredict_proba(...)[0][0]: درجة المشاعر هي العمود 1not الدرجة بينما تحذفها stop_words='english'مشروع فريقك
predict_proba، واحفظ النموذج والمفردات معاp، احتمال الإيجابيةCountVectorizer: أحرف صغيرة، ورموز، وحذف كلمات التوقف، وكلمات مفردة وأزواج، والمفردات وحدهاσ(b + Σ w·x): كل كلمة معروفة تدفع بمقدار وزنهاالجزء 6
نحو 30 دقيقة، والإجابة بعد كل مهمة
نحو 5 دقائق
The waiter was rude and the food was cold.
tokens:   the, waiter, was, rude, and, the, food, was, cold
kept:     waiter, rude, food, cold
n-grams: waiter, rude, food, cold, waiter rude, rude food, food coldنحو 5 دقائق
The waiter was rude and the food was cold. لا توجد في المفردات إلا هذه الكلمات الأربع؛ b = -0.0488. احسب z وp والتنبؤ.
| الخاصية | w |
|---|---|
waiter | -0.0937 |
rude | -0.0364 |
food | 0.2302 |
cold | -0.2052 |
نحو 5 دقائق
Excellent food, friendly staff, highly recommend! b = -0.0488
نحو 5 دقائق
الهدف: إيجاد أكبر عدد من المراجعات السلبية. احسب TN / (TN + FP) عند العتبتين. أي العتبتين تفوز، وبأي ثمن؟
| t | TN, FP | FN, TP |
|---|---|---|
| 0.3 | 10232, 2137 | 1028, 11394 |
| 0.7 | 11251, 1118 | 2054, 10368 |
نحو 10 دقائق
The food was good وThe food was not goodCountVectorizer(ngram_range=(1, 2), min_df=20): مع الإبقاء على كلمات التوقفrandom_state=0)، ثم أعد التدريب: ما عدد الخصائص، والدقة، وقيمة ROC AUC؟الإجابات
| السؤال | تشغيلنا |
|---|---|
| مراجعتا السيناريو | [0.08594148 0.69681757] |
| مراجعتا الطعام، مع حذف كلمات التوقف | 0.5885 و0.5885 |
| مع الإبقاء على كلمات التوقف: الخصائص، والدقة، وAUC | 74,938، و0.8967، و0.9574 |
| مراجعتا الطعام، مع الإبقاء على كلمات التوقف | good 0.7082، وnot good 0.2912 |
| السبب | أصبح not good خاصية، ووزنها -0.7838 |
Mahmoud Abas|تحليل المشاعر بالتصنيف الثنائي