

التوصيات المعتمدة على المحتوى
يبني هذا القسم نظام توصية (recommendation system) صغيرا. فإذا أعطيته فيلما أعجب المشاهد، أعاد الأفلام الأشبه به في المحتوى (content): الأنواع نفسها، والكلمات المفتاحية نفسها، وطاقم التمثيل والمخرج أنفسهم. ستحسب أولا تشابه جيب التمام (cosine similarity) يدويا على خمسة أفلام حقيقية، ثم تشغل دفتر (notebook) الأسبوع 9 على قاعدة بيانات من 4,803 أفلام وتقرأ التوصيات التي ينتجها، بما فيها الحالات التي يخطئ فيها.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- شرح كيف يختار نظام التوصية المعتمد على المحتوى (content-based) العناصر: يوصي أولا بالعناصر الأشبه بعنصر أعجبك.
- تحويل النص إلى متجهات أعداد (count vectors) باستخدام
CountVectorizer، وشرح وظيفةstop_wordsوmin_df. - حساب تشابه جيب التمام يدويا: الضرب النقطي (dot product)، والطولان (lengths)، والقسمة.
- بناء مصفوفة التشابه (similarity matrix) باستخدام
cosine_similarityوقراءة صف واحد منها. - تتبع
get_recommendationsسطرا بسطر وشرح مواضع خطئها. - إعداد عرض مشروع فريقك لمناقشة هذا الأسبوع.
موقع الدرس من المقرر
للأسبوع 9 في الخطة ثلاثة أجزاء:
- الدفتر. يحمل
Movie Recommendationsقاعدة بيانات من 4,803 أفلام تتضمن المخرج، وطاقم التمثيل، والأنواع والكلمات المفتاحية التي تصف كل فيلم، ويبني نموذجا يأخذ عنوان فيلم مدخلا ويعيد قائمة بأفلام مشابهة. - سيناريو من الواقع. توصيات الأفلام.
- مرحلة المشروع (project milestone). عروض فرق المشاريع ومناقشاتها (Project Teams Presentations and Discussions).
قابلت CountVectorizer في الأسبوع 7، حين أدخلت متجهات أعداد الرسائل إلى مصنف Naive Bayes. أما في هذا الأسبوع فلا مصنف ولا عمود هدف: تقارن متجهات أعداد الأفلام بعضها ببعض.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | الفكرة، ومثال محلول يدويا | 35 دقيقة |
| 2 | الدفتر: المتجهات ومصفوفة التشابه | 25 دقيقة |
| 3 | get_recommendations ومواضع خطئها | 20 دقيقة |
| 4 | عروض المشاريع والمناقشة | 10 دقائق |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1: الفكرة
ما نظام التوصية المعتمد على المحتوى؟
يمكن استخدام تعلم الآلة لبناء أنظمة توصية توصي بمنتجات مثل الكتب والأفلام اعتمادا على منتجات أخرى تحبها. وينظر النظام المعتمد على المحتوى إلى المنتجات نفسها: فيصف كل منتج بمحتواه، ويوصي بالمنتجات التي يكون محتواها الأقرب إلى منتج أعجب المستخدم. وكثيرا ما تستخدم أنظمة التوصية المعتمدة على المحتوى أسلوبا يسمى تشابه جيب التمام للتعبير بعدد عن مدى التشابه بين منتجين.
في جملة واحدة: صف كل فيلم بكلماته، وابحث عن الأفلام التي تكون كلماتها الأقرب إلى كلمات فيلم أعجبك، وأوص بها.
الوصفة في أربع خطوات
- الوصف: صف كل فيلم بنص واحد يضم عنوانه، وأنواعه، وكلماته المفتاحية، وطاقم تمثيله، ومخرجه.
- التحويل إلى متجهات: عد كم مرة تظهر كل كلمة من المفردات (vocabulary) في ذلك النص.
- المقارنة: احسب تشابه جيب التمام لكل زوج من الأفلام.
- التوصية: لفيلم أعجب المشاهد، أعد الأفلام صاحبة أعلى تشابه.
لا يتنبأ النموذج بشيء مقابل تسمية (label). فالنموذج هو مصفوفة التشابه نفسها.
من النص إلى الأعداد: CountVectorizer
يحول CountVectorizer قائمة من النصوص إلى جدول من الأعداد:
from sklearn.feature_extraction.text import CountVectorizer

texts = ['Action Adventure Fantasy Science Fiction',
         'Adventure Fantasy Action']
cv = CountVectorizer(stop_words='english')
m = cv.fit_transform(texts)
print(cv.get_feature_names_out())
print(m.toarray())
['action' 'adventure' 'fantasy' 'fiction' 'science']
[[1 1 1 1 1]
[1 1 1 0 0]]- تبني
fitالمفردات: كل كلمة مختلفة، بحروف صغيرة، ومرتبة. - تعطي
transformكل نص صفا من الأعداد، بعمود لكل كلمة من المفردات. - يحذف
stop_words='english'كلمات التوقف (stop words)، أي الكلمات الإنجليزية الشائعة جدا مثلtheوof. - يضيع ترتيب الكلمات. ولا يبقى إلا الأعداد.
تشابه جيب التمام
لمتجهي أعداد A وB على مفردات عدد كلماتها n:
cos(A, B) = (A · B) / (‖A‖ × ‖B‖)

A · B = a1 b1 + a2 b2 + ... + an bn
‖A‖   = √(a1² + a2² + ... + an²)
a1 ... anوb1 ... bnهي عدد مرات ظهور كل كلمة من المفردات في الفيلمين.A · Bهو الضرب النقطي: اضرب كلمة بكلمة ثم اجمع.‖A‖هو طول A: الجذر التربيعي لمجموع مربعاته.
كيف تقرأ قيمة جيب التمام:
- 1 تعني أن المتجهين يشيران إلى الاتجاه نفسه: المزيج نفسه من الكلمات.
- 0 تعني أن الفيلمين لا يشتركان في أي كلمة إطلاقا.
- الأعداد لا تكون سالبة أبدا، لذا تقع قيمة جيب التمام هنا دائما بين 0 و1.
- الاتجاه وحده هو المهم: مضاعفة كل أعداد فيلم ما لا تغير أيا من قيم جيب التمام الخاصة به (يتحقق التمرين 2 من ذلك).
لماذا لا نكتفي بعد الكلمات المشتركة؟ الفيلم الذي له قائمة طويلة من الكلمات المفتاحية سيشترك في كلمات مع كل الأفلام تقريبا. والقسمة على الطولين تحول التداخل إلى نسبة من كلمات كل فيلم.
مثال محلول: خمسة أفلام يدويا
نأخذ أول خمسة صفوف من movies.csv ونستخدم العمود genres وحده. أعجب فيلم Avatar أحد المشاهدين. أي فيلم نوصي به؟
| الفيلم | genres |
|---|---|
| Avatar | Action Adventure Fantasy Science Fiction |
| Pirates of the Caribbean: At World's End | Adventure Fantasy Action |
| Spectre | Action Adventure Crime |
| The Dark Knight Rises | Action Crime Drama Thriller |
| John Carter | Action Adventure Science Fiction |
الخطوة 1: المفردات والمتجهات
يقسم مقسم النص (tokenizer) عند المسافات ويحول الحروف إلى صغيرة، لذا يصبح Science Fiction كلمتين. وتستخدم السلاسل النصية الخمس 8 كلمات مختلفة:
['action' 'adventure' 'crime' 'drama' 'fantasy' 'fiction' 'science' 'thriller']بترتيب الأعمدة هذا، يصبح كل فيلم متجها قيمه 0 و1:
| الفيلم | متجه الأعداد | الكلمات |
|---|---|---|
| Avatar | [1 1 0 0 1 1 1 0] | 5 |
| Pirates of the Caribbean | [1 1 0 0 1 0 0 0] | 3 |
| Spectre | [1 1 1 0 0 0 0 0] | 3 |
| The Dark Knight Rises | [1 0 1 1 0 0 0 1] | 4 |
| John Carter | [1 1 0 0 0 1 1 0] | 4 |
الخطوة 2: الأطوال
حين تكون القيم 0 و1 فقط، يكون مجموع المربعات هو عدد الكلمات.
| الفيلم | مجموع المربعات | الطول |
|---|---|---|
| Avatar | 5 | √5 = 2.2361 |
| Pirates of the Caribbean | 3 | √3 = 1.7321 |
| Spectre | 3 | √3 = 1.7321 |
| The Dark Knight Rises | 4 | √4 = 2.0000 |
| John Carter | 4 | √4 = 2.0000 |
الخطوة 3: نواتج الضرب النقطي مع Avatar
اضرب متجه Avatar في كل متجه آخر كلمة بكلمة ثم اجمع. وحين تكون الأعداد 0/1، يكون الضرب النقطي ببساطة عدد الكلمات المشتركة.
| الفيلم | الكلمات المشتركة | A · B |
|---|---|---|
| Pirates of the Caribbean | action, adventure, fantasy | 3 |
| Spectre | action, adventure | 2 |
| The Dark Knight Rises | action | 1 |
| John Carter | action, adventure, fiction, science | 4 |
الخطوة 4: قيم جيب التمام
لفيلم Pirates of the Caribbean:
cos(A, B) = 3 / (√5 × √3) = 3 / √15 = 3 / 3.8730 = 0.7746كل كلماته الثلاث موجودة في Avatar، لكن في Avatar كلمتين إضافيتين ليستا في Pirates، لذا تقل قيمة جيب التمام عن 1. والأفلام الثلاثة الأخرى:
| الفيلم B | الحساب | cos(A, B) |
|---|---|---|
| Spectre | 2 / (2.2361 × 1.7321) = 2 / 3.8730 | 0.5164 |
| The Dark Knight Rises | 1 / (2.2361 × 2) = 1 / 4.4721 | 0.2236 |
| John Carter | 4 / (2.2361 × 2) = 4 / 4.4721 | 0.8944 |
الخطوة 5: الترتيب والتوصية
| الترتيب | الفيلم | cos(A, B) |
|---|---|---|
| 1 | John Carter | 0.8944 |
| 2 | Pirates of the Caribbean | 0.7746 |
| 3 | Spectre | 0.5164 |
| 4 | The Dark Knight Rises | 0.2236 |
أفضل توصيتين لمشاهد أعجبه Avatar هما John Carter وPirates of the Caribbean. يشترك John Carter في 4 من كلمات الأنواع الـ5 في Avatar، وليس فيه غيرها: يفوز المزيج الأقرب من الكلمات.
التحقق باستخدام scikit-learn
from sklearn.metrics.pairwise import cosine_similarity

cv = CountVectorizer(stop_words='english')
m = cv.fit_transform(df['genres'].head(5))
sim = cosine_similarity(m)
sim[0]
array([1. , 0.77459667, 0.51639778, 0.2236068 , 0.89442719])الصف 0 هو Avatar، وهو يطابق النتائج اليدوية. والمصفوفة الكاملة 5 في 5:
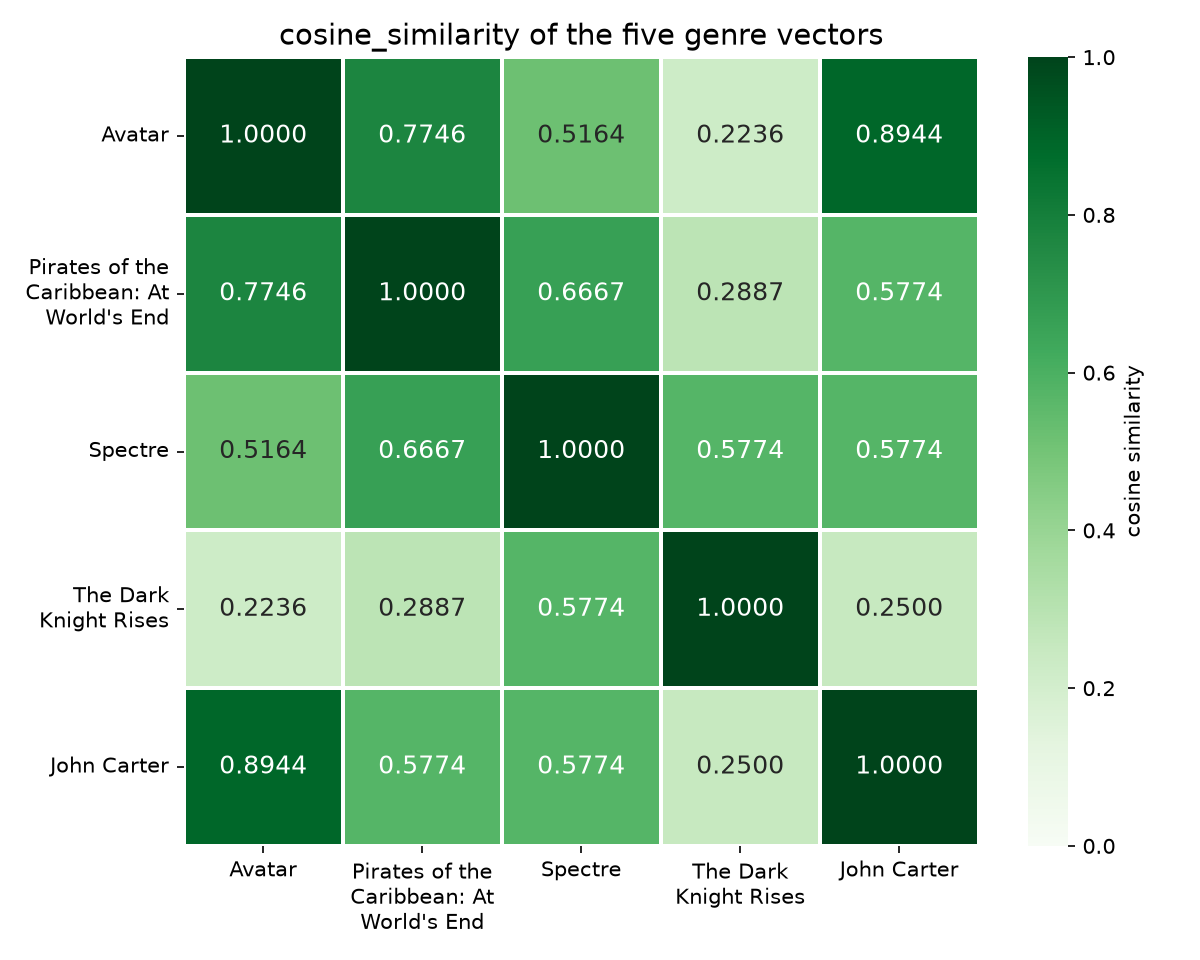
المصفوفة متماثلة (symmetric): قيمة جيب التمام بين Avatar وSpectre هي نفسها بين Spectre وAvatar.
لإعادة المثال مقارنة بعد مقارنة، افتح أداة جيب التمام خطوة بخطوة بملء الشاشة. اختر الفيلم المفضل، واضغط خطوة، واضغط أي عدد لترى كيف تتغير قيم جيب التمام.
الجزء 2: الدفتر على 4,803 أفلام
افتح الدفتر
افتح Movie Recommendations في Colab
تقرأ خلية الكود الأولى Data/movies.csv، وهو مجلد غير موجود بجوار الدفتر في Colab. اقرأ الملف من المستودع بدلا من ذلك (حجمه نحو 23 MB، لذا تستغرق الخلية بضع ثوان):
import pandas as pd

url = ('https://raw.githubusercontent.com/'
       'jeffprosise/Machine-Learning/'
       'master/Data/movies.csv')
df = pd.read_csv(url)
df.shape
المخرجات هي (4803, 24): 4,803 أفلام و24 عمودا. ومن بينها title وgenres وkeywords وcast وdirector، إلى جانب أعمدة مثل الميزانية والإيرادات ومدة العرض والأصوات لا يستخدمها هذا النموذج.
احتفظ بخمسة أعمدة واملأ الفجوات
df = df[['title', 'genres', 'keywords', 'cast', 'director']]
df = df.fillna('') # Fill missing values with empty strings
بعض الخلايا فارغة: keywords مفقود في 412 صفا، وcast في 43، وdirector في 30، وgenres في 28، وفي 426 صفا تنقص قيمة واحدة منها على الأقل. تلصق الخلية التالية الأعمدة معا باستخدام +، وإضافة سلسلة نصية إلى قيمة مفقودة تعطي قيمة مفقودة. ومن دون fillna('') لن يبقى لتلك الأفلام الـ426 أي نص على الإطلاق، ويتوقف CountVectorizer بالخطأ:
ValueError: np.nan is an invalid document, expected byte or unicode string.نص واحد لكل فيلم: العمود features
df['features'] = df['title'] + ' ' + df['genres'] + ' ' + df['keywords'] + ' ' + df['cast'] + ' ' + df['director']تصبح الأعمدة الخمسة سلسلة نصية واحدة لكل فيلم، بينها مسافات. وتصبح الأسماء كلمات عادية: فالاسم الأول للمخرج واسم عائلته كلمتان من النص. ويعطي العنوان The Dark Knight Rises الكلمات dark وknight وrises، أما the فهي من كلمات التوقف فتحذف.
تحويل كل الأفلام إلى متجهات
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(stop_words='english', min_df=20)
word_matrix = vectorizer.fit_transform(df['features'])
word_matrix.shape
المخرجات هي (4803, 918): صف لكل فيلم، و918 كلمة من المفردات.
يحتفظ min_df=20 بالكلمة فقط إذا ظهرت في 20 فيلما على الأقل. وتحذف الكلمات الأندر. وعلى عمود features نفسه، مع stop_words='english':
| min_df | الكلمات المحتفظ بها |
|---|---|
| 1 | 17,286 |
| 5 | 3,852 |
| 20 (الدفتر) | 918 |
| 50 | 271 |
نتيجة ستراها في الجزء 3: تظهر die في 17 فيلما وhard في 15، لذا لا يضيف عنوان Die Hard أي كلمة إلى متجهه. وكذلك skyfall وrises، إذ لا تظهر كل منهما إلا في فيلم واحد.
ووسيط (median) عدد الكلمات التي يحتفظ بها كل فيلم هو 12 كلمة، لذا فإن 56,451 خلية فقط من خلايا المصفوفة البالغة 4,803 × 918، أي نحو 1.3%، ليست صفرا. وتعيد fit_transform مصفوفة متفرقة (sparse) لا تخزن إلا تلك الخلايا.
مصفوفة التشابه
from sklearn.metrics.pairwise import cosine_similarity

sim = cosine_similarity(word_matrix)
sim.shape
المخرجات هي (4803, 4803):
sim[i, j]هو تشابه جيب التمام بين الفيلمiوالفيلمj.- المصفوفة متماثلة:
sim[i, j]يساويsim[j, i]. - القطر يساوي 1.0 في 4,794 فيلما. أما الأفلام الـ9 الأخرى فلا تبقى فيها أي كلمة بعد
min_df=20، فمتجهها كله أصفار، وتعيدcosine_similarityالقيمة 0 لكل زوج يتضمن أحدها، بما في ذلك القطر.
مثال محلول: Skyfall وSpectre
ننظر إلى صفين حقيقيين من word_matrix. كل الأعداد في المتجهين تساوي 1. ومجمعة حسب العمود الذي جاءت منه كل كلمة:
| الكلمات من | Skyfall | Spectre | المشتركة |
|---|---|---|---|
| الأنواع | 3 | 3 | 2: action, adventure |
| الكلمات المفتاحية | 5 | 6 | 3: spy, secret, agent |
| أسماء طاقم التمثيل والإخراج | 7 | 6 | 6 |
| المجموع | 15 | 15 | 11 |
حين تكون الأعداد 0/1، يكون A · B هو عدد الكلمات المشتركة، ويكون كل طول هو الجذر التربيعي لعدد الكلمات:
cos(A, B) = 11 / (√15 × √15) = 11 / 15 = 0.7333يحمل sim في الدفتر القيمة 0.7333 بالضبط لهذا الزوج. وست من الكلمات الإحدى عشرة المشتركة أسماء: للفيلمين الممثلون الرئيسيون أنفسهم والمخرج نفسه.
الجزء 3: توليد التوصيات
الدالة سطرا بسطر
يعرف الدفتر دالة تأخذ عنوانا وتعيد قائمة بأفلام مشابهة:
def get_recommendations(title, df, sim, count=10):
    # Get the row index of the specified title in the DataFrame
    index = df.index[df['title'].str.lower() == title.lower()]

    # Return an empty list if there is no entry for the specified title
    if (len(index) == 0):
        return []

    # Get the corresponding row in the similarity matrix
    similarities = list(enumerate(sim[index[0]]))

    # Sort the similarity scores in that row in descending order
    recommendations = sorted(similarities, key=lambda x: x[1], reverse=True)

    # Get the top n recommendations, ignoring the first entry in the list since
    # it corresponds to the title itself (and thus has a similarity of 1.0)
    top_recs = recommendations[1:count + 1]

    # Generate a list of titles from the indexes in top_recs
    titles = []

    for i in range(len(top_recs)):
        title = df.iloc[top_recs[i][0]]['title']
        titles.append(title)

return titles- تحول مطابقة العنوان الطرفين إلى حروف صغيرة، لذا يعطي
'skyfall'القائمة نفسها التي يعطيها'Skyfall'. - يعيد العنوان غير المعروف قائمة فارغة بدلا من إطلاق خطأ.
- تقرن
enumerateكل قيمة (score) برقم فيلمها. في Skyfall يبدأ الصف بـ(0, 0.1732), (1, 0.1333), (2, 0.7333), ...(مقربة هنا). - تضع
sorted(..., reverse=True)أعلى القيم أولا. وعند تساوي القيم تحافظsortedفي Python على الترتيب الأصلي، أي ترتيب الملف. - يبدأ الاقتطاع (slice) من 1 لأن العنصر 0 هو عادة الفيلم نفسه، بتشابه 1.0.
Skyfall
تعيد get_recommendations('Skyfall', df, sim) ما يلي:
['Spectre',
 'Quantum of Solace',
 'Johnny English Reborn',
 'Clash of the Titans',
 'Die Another Day',
 'Diamonds Are Forever',
 'Wrath of the Titans',
 'I Spy',
 'Sanctum',
 'Blackthorn']
القيم وراء تلك القائمة:
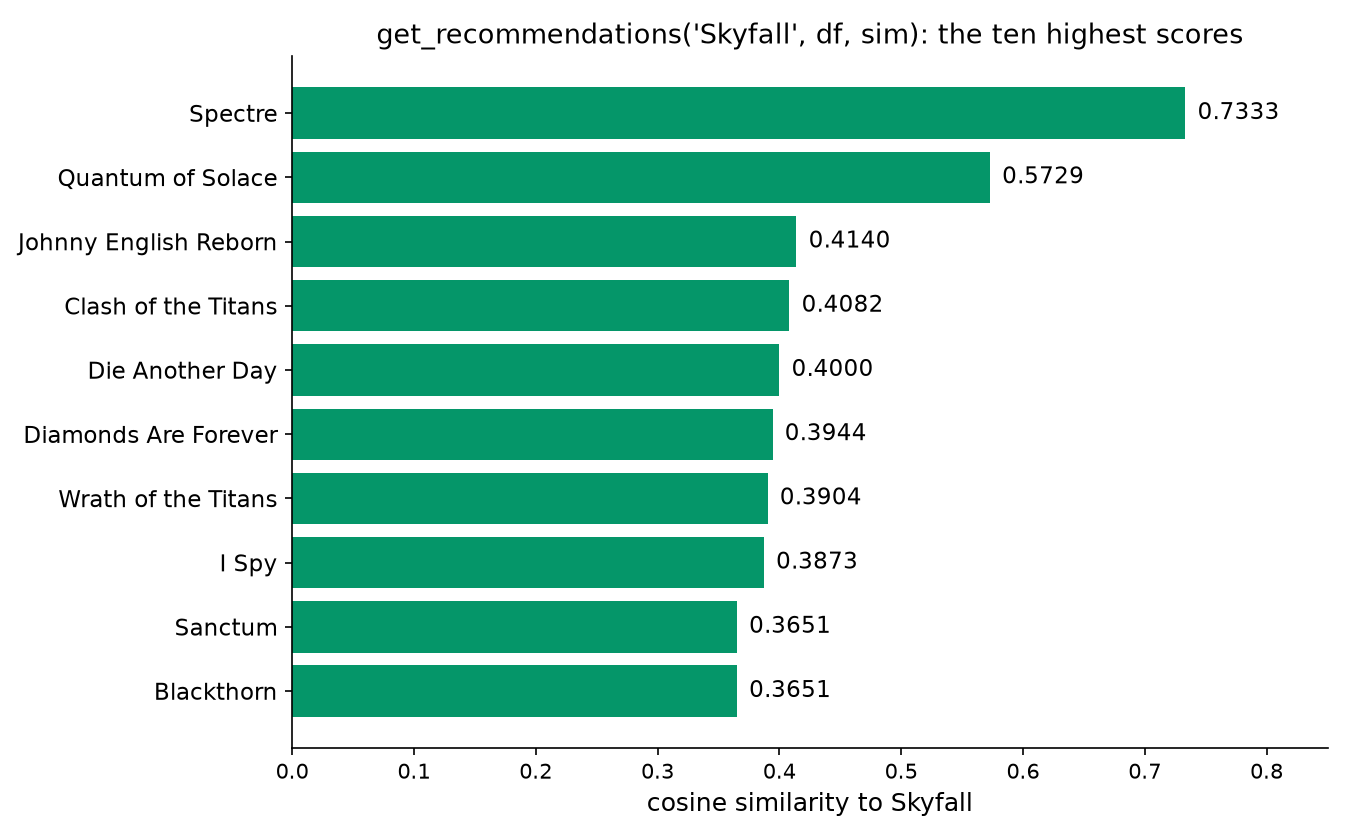
| الترتيب | الفيلم | القيمة |
|---|---|---|
| 1 | Spectre | 0.7333 |
| 2 | Quantum of Solace | 0.5729 |
| 3 | Johnny English Reborn | 0.4140 |
| 4 | Clash of the Titans | 0.4082 |
| 5 | Die Another Day | 0.4000 |
| 6 | Diamonds Are Forever | 0.3944 |
| 7 | Wrath of the Titans | 0.3904 |
| 8 | I Spy | 0.3873 |
| 9 | Sanctum | 0.3651 |
| 10 | Blackthorn | 0.3651 |
يشترك Spectre في طاقم التمثيل والمخرج. ويشترك Quantum of Solace وDie Another Day في الكلمتين المفتاحيتين secret وagent وفي الأنواع. ويتعادل Sanctum وBlackthorn عند 0.3651، فتبقيهما sorted بترتيب الملف.
مثال محلول: لماذا يحصل Mulan على Shrek؟
تعيد get_recommendations('Mulan', df, sim) ما يلي:
['Shrek',
 'Frozen',
 '1911',
 'Kung Fu Panda',
 'Shrek the Third',
 'The Polar Express',
 'Tangled',
 'Shrek Forever After',
 'Shrek 2',
 'Jungle Shuffle']
في متجه Mulan 10 كلمات، وفي متجه Shrek 15 كلمة، وعدد كل منها 1. ويشتركان في كلمات الأنواع الثلاث adventure وanimation وfamily، وفي كلمتين من اسم ممثل أداء صوتي يظهر في الفيلمين.
cos(A, B) = (3 + 2) / (√10 × √15) = 5 / 12.2474 = 0.4082هذه أعلى قيمة في صف Mulan. فممثل الأداء الصوتي المشترك يحسب تماما كما يحسب النوع المشترك: النموذج لا يرى إلا الكلمات.
Die Hard: الأجزاء اللاحقة تكتشف عبر طاقم التمثيل
تعيد get_recommendations('Die Hard', df, sim) ما يلي:
['Die Hard 2',
 'The Prince',
 'Sphinx',
 'Die Hard: With a Vengeance',
 '13 Hours: The Secret Soldiers of Benghazi',
 'Act of Valor',
 'Live Free or Die Hard',
 'A Good Day to Die Hard',
 'Broken Arrow',
 'Surrogates']
في القائمة أربعة أجزاء لاحقة (sequels)، في المراتب 1 و4 و7 و8، لكن ليس بسبب العنوان: فقد سقطت die وhard تحت min_df=20. وتكتشف الأجزاء اللاحقة عبر أسماء طاقم التمثيل والنوعين action وthriller. ويأتي Die Hard 2 أولا بقيمة 0.7303، لأنه يشترك أيضا في أربع كلمات مفتاحية: based وnovel وhelicopter وjournalist.
لاستكشاف أي من هذه القوائم، افتح مستكشف التشابه بملء الشاشة. اختر فيلما، واضغط تشغيل لترتيب صفه، واضغط أي عمود لترى الكلمات المشتركة والقسمة وراء قيمته.
مواضع الخطأ
- المتجهات الفارغة. تفقد 9 أفلام كل كلماتها بعد
min_df=20، لذا كل قيمة في صفها 0. - العناوين المكررة. هناك فيلمان مختلفان اسمهما
Batman(الصفان 1359 و4267)، وكل من العنوانينThe HostوOut of the Blueيحمله فيلمان أيضا. والدالة تستخدم دائما أول تطابق. - التعادل مع الفيلم نفسه. في 14 صفا لا يكون الفيلم هو العنصر 0 في صفه المرتب: المتجهات الفارغة الـ9، و5 أفلام كلمتها الوحيدة أو كلمتاها (مثل
dramaوحدها، أوdocumentaryوحدها) هي بالضبط كلمات فيلم أسبق في الملف، فيحصل ذلك الفيلم أيضا على 1.0. وفي هذه الصفوف يتخطى[1:count + 1]الفيلم الخطأ. - المحتوى وحده. لا يرى النموذج أبدا التقييمات ولا ما شاهده المشاهدون الآخرون، لذا لا يستطيع التمييز بين فيلم جيد وفيلم سيئ كلماتهما متشابهة.
قبل أن تثق بقائمة، اطبع القيم بجانب العناوين.
مثال محلول: Sharkskin
فيلم Sharkskin أحد المتجهات الفارغة الـ9: أنواعه وكلماته المفتاحية فارغة، وكلماته الأخرى تظهر في أقل من 20 فيلما. كل قيمة في صفه 0، لذا تبقي sorted الصف كله بترتيب الملف.
تعيد get_recommendations('Sharkskin', df, sim, count=3) ما يلي:
["Pirates of the Caribbean: At World's End", 'Spectre', 'The Dark Knight Rises']هذه ببساطة الصفوف 1 و2 و3 من الملف. والعنصر 0 في الصف المرتب هو Avatar، أي الصف 0 في الملف، وليس Sharkskin، لذا تخطى الاقتطاع كذلك الفيلم الخطأ.
الجزء 4: عروض فرق المشاريع ومناقشاتها
مرحلة المشروع هذا الأسبوع عرض لمشروع فريقك تتبعه مناقشة. نظم العرض وفق مراحل الخطة حتى الآن:
- الفكرة، أو الورقة البحثية، وسبب أهميتها.
- البيانات: مصدرها، واستكشافها، وتنظيفها.
- الخصائص (features) والمتغير الهدف (target variable) التي اخترتها.
- النموذج الذي نفذته وطريقة تقييمك له.
- ما ستحسنه بعد ذلك.
في أثناء المناقشة:
- يجب أن يستطيع كل عضو شرح كل خطوة، لا الجزء الخاص به فقط.
- اعرض الدفتر وهو يعمل والأرقام التي طبعها، لا لقطات الشاشة وحدها.
- اذكر شيئا واحدا لم ينجح وما تعلمته منه.
- دون الأسئلة التي تطرح عليك: فهي قائمة مهامك للأسبوع القادم.
إذا احتوى مشروعك على نص، مثل العناوين أو المراجعات أو الأوصاف، فيمكن تحويله إلى متجهات ومقارنته تماما كما في هذا الدرس.
الأخطاء الشائعة
- قراءة
Data/movies.csvفي Colab، حيث لا يوجد ذلك المجلد. - نسيان
fillna('')، فتعطل قيمة مفقودةCountVectorizer. - إعادة العنصر 0 من الصف المرتب: فيوصي الفيلم المفضل بنفسه.
- جمع الكلمات المشتركة ونسيان القسمة على الطولين.
- الثقة بقائمة دون قيمها: فالمتجهات الفارغة والتعادلات والعناوين المكررة كلها تعطي قوائم مضللة.
- توقع أن تحسب كلمة نادرة من العنوان بعد أن حذفها
min_df.
الخلاصة
- يقترح نظام التوصية المعتمد على المحتوى العناصر التي يكون محتواها الأقرب إلى عنصر أعجبك.
- يحول
CountVectorizerالنص إلى متجهات أعداد، ويحددstop_wordsوmin_dfالكلمات التي تحسب. - تشابه جيب التمام هو الضرب النقطي مقسوما على الطولين، وقيمته بين 0 و1 للأعداد، ولا يتأثر بطول النص.
- تعطي
cosine_similarityالمصفوفة كاملة، وصف واحد مرتب منها هو قائمة توصيات. - انظر دائما إلى القيم: فالمتجهات الفارغة والتعادلات والعناوين المكررة تعطي قوائم مضللة.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: فيلم سادس (نحو 10 دقائق)
الصف 11 من الملف، Quantum of Solace، أنواعه Adventure Action Thriller Crime.
- اكتب متجه أعداده على الكلمات الـ8 نفسها في المثال المحلول، واحسب طوله.
- احسب قيمة جيب التمام بينه وبين كل من الأفلام الخمسة في المثال المحلول.
- أي فيلمين توصي بهما لمشاهد أعجبه؟
تلميح: أنواعه الأربعة كلها موجودة في المفردات، لذا تبقى الأعمدة كما هي.
التمرين 2: الأعداد والطول (نحو 5 دقائق)
ثلاثة نصوص قصيرة: X = space war space alien، وY = space alien robot، وZ هو X مكتوبا مرتين (space war space alien space war space alien).
- باستخدام المفردات
alien, robot, space, war، اكتب X وY وZ متجهات أعداد. - احسب cos(X, Y) وcos(Z, Y) وcos(X, Z).
- ماذا يفعل تكرار النص بقيمة جيب التمام الخاصة به؟
التمرين 3: القيم في Colab (نحو 10 دقائق)
- شغل الدفتر حتى
sim = cosine_similarity(word_matrix). - انسخ
get_recommendationsوغيرها لتعيد أزواجا(title, score)، مع تقريب كل قيمة إلى 4 منازل عشرية. - اطبع أعلى 5 نتائج للعنوان
'The Dark Knight Rises'. - تحقق من القيمة الأولى يدويا من
word_matrix: احسب الضرب النقطي للصفين ومجموعي مربعاتهما.
التمرين 4: غير min_df (نحو 5 دقائق)
أعد بناء المتجهات باستخدام min_df=5 بدلا من 20، واطبع الشكل الجديد لمصفوفة الكلمات، وأعد تشغيل التوصيات للعنوان 'Skyfall' مع القيم. ماذا يحدث لقيمة Spectre، ولماذا؟
الإجابات
الإجابة 1
متجه Quantum of Solace، بترتيب action, adventure, crime, drama, fantasy, fiction, science, thriller، هو [1 1 1 0 0 0 0 1]. فيه 4 كلمات، لذا طوله √4 = 2.
| الفيلم B | A · B | الحساب | cos(A, B) |
|---|---|---|---|
| Spectre | 3 | 3 / (2 × 1.7321) | 0.8660 |
| The Dark Knight Rises | 3 | 3 / (2 × 2) | 0.7500 |
| Pirates of the Caribbean | 2 | 2 / (2 × 1.7321) | 0.5774 |
| John Carter | 2 | 2 / (2 × 2) | 0.5000 |
| Avatar | 2 | 2 / (2 × 2.2361) | 0.4472 |
أوص بفيلمي Spectre وThe Dark Knight Rises. يشترك Spectre في action وadventure وcrime، ويشترك The Dark Knight Rises في action وcrime وthriller، لكن فيه 4 كلمات بدلا من 3، لذا تكون قيمة جيب التمام له أقل. وتعطي cosine_similarity على المتجهات الستة الصف نفسه: [0.4472, 0.5774, 0.866, 0.75, 0.5, 1.0].
الإجابة 2
- X =
[1, 0, 2, 1]، وY =[1, 1, 1, 0]، وZ =[2, 0, 4, 2]. - cos(X, Y): X · Y = 1 + 0 + 2 + 0 = 3، و‖X‖ = √6 = 2.4495، و‖Y‖ = √3 = 1.7321، إذن 3 / 4.2426 = 0.7071.
- cos(Z, Y): Z · Y = 2 + 0 + 4 + 0 = 6، و‖Z‖ = √24 = 4.8990، إذن 6 / 8.4853 = 0.7071.
- cos(X, Z): X · Z = 2 + 0 + 8 + 2 = 12، و‖X‖ × ‖Z‖ = 2.4495 × 4.8990 = 12، إذن 1.
تكرار النص يضاعف كل الأعداد، فيضاعف الضرب النقطي والطول معا. ولا يتغير الاتجاه، لذا لا تتغير قيمة جيب التمام: Z يشبه Y بالقدر نفسه الذي يشبهه به X.
الإجابة 3
def get_recommendations_with_scores(title, df, sim, count=10):
    index = df.index[df['title'].str.lower() == title.lower()]
    if (len(index) == 0):
        return []
    similarities = list(enumerate(sim[index[0]]))
    recommendations = sorted(similarities, key=lambda x: x[1], reverse=True)
    top_recs = recommendations[1:count + 1]
    return [(df.iloc[i]['title'], round(float(s), 4)) for i, s in top_recs]

for pair in get_recommendations_with_scores('The Dark Knight Rises', df, sim, count=5):
    print(pair)
('The Dark Knight', 0.7924)
('Batman Begins', 0.7348)
('Harsh Times', 0.4667)
('The Killer Inside Me', 0.4648)
("Amidst the Devil's Wings", 0.4619)التحقق اليدوي:
a = df.index[df['title'] == 'The Dark Knight Rises'][0]
b = df.index[df['title'] == 'The Dark Knight'][0]
A = word_matrix[a].toarray()[0]
B = word_matrix[b].toarray()[0]
print(A @ B, A @ A, B @ B)
19 25 23cos(A, B) = 19 / (√25 × √23) = 19 / (5 × 4.7958) = 19 / 23.9792 = 0.7924هذه المرة ليست كل الأعداد 1: تظهر crime مرتين في الفيلمين (مرة في الأنواع ومرة في الكلمات المفتاحية)، لذا يكون مجموعا المربعات، 25 و23، أكبر من عددي الكلمات، 22 و20. ويشترك الفيلمان في كلمتي العنوان dark وknight، وفي أربعة أنواع، وفي عدة كلمات مفتاحية، وفي خمس كلمات من الأسماء.
الإجابة 4
vectorizer5 = CountVectorizer(stop_words='english', min_df=5)
word_matrix5 = vectorizer5.fit_transform(df['features'])
print(word_matrix5.shape)
sim5 = cosine_similarity(word_matrix5)
print(get_recommendations_with_scores('Skyfall', df, sim5, count=10))
(4803, 3852)
[('Spectre', 0.55), ('Quantum of Solace', 0.4564), ('Casino Royale', 0.35), ('Diamonds Are Forever', 0.313), ('I Spy', 0.2739), ('Johnny English Reborn', 0.2739), ('Coriolanus', 0.2712), ('Goldfinger', 0.2635), ('Sanctum', 0.2582), ('Lara Croft: Tomb Raider', 0.25)]- تكبر المفردات من 918 إلى 3,852 كلمة.
- يبقى Spectre أولا، لكن قيمته تنخفض من 0.7333 إلى 0.55. فمع
min_df=5يحتفظ كل من Skyfall وSpectre بـ20 كلمة بدلا من 15، ويظلان يشتركان في الكلمات الـ11 نفسها:
cos(A, B) = 11 / (√20 × √20) = 11 / 20 = 0.55المتجهات الأطول مع التداخل نفسه تعطي قيمة أقل لجيب التمام. وتتغير القائمة أيضا: تدخلها Casino Royale وCoriolanus وGoldfinger وLara Croft: Tomb Raider، وتخرج منها Clash of the Titans وDie Another Day وWrath of the Titans وBlackthorn.