

التصنيف بخوارزمية Naive Bayes
يقدم هذا القسم خوارزمية Naive Bayes، وهي المصنف (classifier) الذي تعمل به كثير من مرشحات الرسائل المزعجة (spam filters). يحول Naive Bayes ما يعده في بيانات التدريب إلى احتمالات باستخدام نظرية بايز (Bayes' theorem)، ثم يختار الصنف (class) صاحب أعلى احتمال. ستطبق الطريقة أولا يدويا على أعداد حقيقية من 999 رسالة بريد إلكتروني (e-mail)، ثم تبني مرشحا للرسائل المزعجة ومصنفا للنبيذ في scikit-learn باستخدام دفتري (notebooks) الأسبوع 7.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- صياغة نظرية بايز وتسمية أجزائها الأربعة: الاحتمال المسبق (prior)، والأرجحية (likelihood)، والدليل (evidence)، والاحتمال اللاحق (posterior).
- حساب احتمال أن تكون الرسالة مزعجة بشرط وجود كلمة واحدة فيها، من أعداد حقيقية.
- شرح الافتراض الساذج (naive assumption) واستخدامه لحساب درجة (score) الرسالة كلمة بكلمة، يدويا.
- شرح لماذا يتعطل النموذج حين يكون عدد كلمة ما 0، وكيف يعالج تنعيم لابلاس (Laplace smoothing)، أي
alpha=1، هذه المشكلة. - بناء مرشح للرسائل المزعجة باستخدام
MultinomialNBوCountVectorizer، وتقييمه واستخدامه. - شرح كيف يتعامل
GaussianNBمع الخصائص (features) العددية، وتدريبه على بيانات النبيذ.
موقع الدرس من المقرر
للأسبوع 7 في الخطة ثلاثة أجزاء:
- دفتران. يبني
E-Mail Classificationمرشحا للرسائل المزعجة من 1000 رسالة ذات تسمية (labelled). ويصنفNaive_Bayes_Classificationأنواع النبيذ من نتائج تحليلها الكيميائي. - سيناريو من الواقع. كشف الرسائل المزعجة: الحكم من كلمات الرسالة هل هي مزعجة (spam) أم سليمة، وتسمى الرسالة السليمة ham.
- مرحلة المشروع (project milestone). تنفيذ نموذج تعلم الآلة (Machine Learning Model Implementation): في هذا الأسبوع يضيف فريقك نموذج Naive Bayes على بياناته الخاصة.
في الأسابيع من 4 إلى 6 دربت نماذج الانحدار اللوجستي (logistic regression) وKNN وأشجار القرار (decision trees) والغابات العشوائية (random forests) بنمط fit وpredict وscore نفسه، وقرأت مصفوفات الالتباس (confusion matrices). ويستخدم Naive Bayes النمط نفسه. والجديد هو الفكرة داخل النموذج: فهو يعد، ويضرب الاحتمالات.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | نظرية بايز، وكلمة واحدة يدويا | 20 دقيقة |
| 2 | Naive Bayes يدويا، والتنعيم | 30 دقيقة |
| 3 | الدفتر 1: مرشح الرسائل المزعجة | 20 دقيقة |
| 4 | الدفتر 2: Naive Bayes الغاوسي على النبيذ | 20 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1: نظرية بايز
الاحتمال الشرطي
الاحتمال الشرطي (conditional probability) هو احتمال وقوع حدث ما، بشرط أن يكون حدث آخر قد وقع بالفعل. ونكتبه بخط عمودي:
P(A | B) = the probability of A, given that B is trueفي الرسائل: P(S | m) هو احتمال أن تكون الرسالة مزعجة (S) بشرط أن تحتوي على الكلمة money (m). والاتجاه المعاكس، P(m | S)، هو احتمال أن تحتوي الرسالة على money بشرط أن تكون مزعجة. وهذان عددان مختلفان.
نظرية بايز
تربط نظرية بايز بين الاتجاهين:
P(A | B) = P(B | A) P(A) / P(B)لصنف c ودليل ما x عن الرسالة:
| الجزء | الرمز | المعنى |
|---|---|---|
| الاحتمال المسبق | P(c) | مدى شيوع الصنف قبل أن ننظر في الرسالة |
| الأرجحية | P(x | c) | مدى شيوع الدليل داخل ذلك الصنف |
| الدليل | P(x) | مدى شيوع الدليل عموما |
| الاحتمال اللاحق | P(c | x) | احتمال الصنف بعد رؤية الدليل |
يسهل عد الأرجحية من البيانات ذات التسمية: انظر إلى الرسائل المزعجة وحدها وعد. والاحتمال اللاحق هو ما نريده. وتحول نظرية بايز الأول إلى الثاني.
مثال محلول: رسالة مزعجة، بشرط وجود الكلمة money
تحتوي مجموعة بيانات الدفتر على 999 رسالة بعد حذف رسالة مكررة: 500 مزعجة و499 سليمة. ونعد كم رسالة منها تحتوي على الكلمة money مرة واحدة على الأقل.
| الصنف | الرسائل | تحتوي على money |
|---|---|---|
مزعجة S | 500 | 79 |
سليمة H | 499 | 25 |
| الكل | 999 | 104 |
السؤال: وصلت رسالة جديدة تحتوي على money. ما قيمة P(S | m)؟
الخطوة 1: الاحتمال المسبق والأرجحية
كلاهما يقرأ مباشرة من الجدول:
P(S)     = 500 / 999 = 0.5005
P(m | S) = 79 / 500  = 0.158
الخطوة 2: الدليل
يعد P(m) الكلمة في كل الرسائل، المزعجة والسليمة معا:
P(m) = (79 + 25) / 999 = 104 / 999 = 0.1041الخطوة 3: الاحتمال اللاحق
P(S | m) = P(m | S) P(S) / P(m) = 0.158 x 0.5005 / 0.1041 = 0.7596ترفع رؤية money احتمال أن تكون الرسالة مزعجة من نحو النصف إلى نحو ثلاثة أرباع. تحقق: من بين الرسائل الـ104 التي تحتوي على money هناك 79 رسالة مزعجة، و79 / 104 = 0.7596، وهي الإجابة نفسها. فنظرية بايز تعطي بالضبط ما يعطيه العد المباشر. وقيمتها أنها تظل صالحة حين لا نستطيع العد مباشرة، وهذا ما يحدث بمجرد أن ننظر في كلمات كثيرة معا.
الجزء 2: Naive Bayes يدويا
من كلمة واحدة إلى كلمات كثيرة: الافتراض الساذج
في الرسالة كلمات كثيرة x1, x2, ..., xn. وتطبيق نظرية بايز على الرسالة كلها يحتاج إلى P(x1, x2, ..., xn | c)، أي احتمال هذا المزيج المحدد من الكلمات داخل صنف ما. ولا يكاد أي مزيج يتكرر مرتين في 999 رسالة، لذا لا يمكن عده.
يفترض Naive Bayes أن الكلمات مستقلة شرطيا عند معرفة الصنف (conditionally independent given the class): فبعد أن نعرف أن الرسالة مزعجة، لا تخبرنا رؤية كلمة بأي شيء إضافي عن الكلمة التالية. وعندها تصبح الأرجحية المشتركة حاصل ضرب أرجحيات الكلمات المفردة:
P(x1, x2, ..., xn | c) = P(x1 | c) x P(x2 | c) x ... x P(xn | c)ولهذا يوصف بأنه ساذج (naive). فالكلمات الحقيقية ليست مستقلة (order وonline تأتيان معا كثيرا في الرسائل المزعجة)، لكن الطريقة تؤدي أداء جيدا على نحو مدهش حتى حين لا يتحقق الافتراض. والتدريب سريع أيضا: لا تضبط أي أوزان بعملية تحسين (optimization)، فالنموذج يعد فقط.
قاعدة التصنيف
قيمة P(x1, ..., xn) واحدة لكل الأصناف، لذا لا تغير الصنف الفائز. والقاعدة هي:
- لكل صنف
c، احسب الدرجةP(c) x P(x1 | c) x ... x P(xn | c). - تنبأ بالصنف صاحب أكبر درجة.
- للحصول على احتمالات، طبق التطبيع (normalization): اقسم كل درجة على مجموع الدرجات كلها. وهذا ما تطبعه
predict_proba.
الاحتمال المسبق P(c) هو نسبة رسائل التدريب التي تنتمي إلى الصنف c.
عد الكلمات: MultinomialNB
يستخدم دفتر الرسائل المزعجة MultinomialNB، الذي يعمل على أعداد الكلمات. واحتمال الكلمة w في الصنف c هو نصيب w من كلمات هذا الصنف:
P(w | c) = (n_wc + alpha) / (N_c + alpha x V)n_wc: عدد مرات ظهورwفي كل رسائل التدريب من الصنفcN_c: مجموع أعداد كل كلمات المفردات (vocabulary) في الصنفcV: عدد الكلمات في المفرداتalpha: قيمة التنعيم. يستخدمMultinomialNB()القيمةalpha=1.0افتراضيا، ونشرحها في نهاية هذا الجزء.
الكلمة التي تظهر مرتين في رسالة تدخل حاصل الضرب مرتين.
مثال محلول: مرشح رسائل مزعجة من أربع كلمات
لتبقى الأعداد صغيرة، تخيل مرشحا مفرداته أربع كلمات فقط: money وonline وmeeting وmeds. وهذه أعدادها الحقيقية في الرسائل الـ999:
| الكلمة | العدد في السليمة | العدد في المزعجة |
|---|---|---|
money | 38 | 155 |
online | 7 | 94 |
meeting | 153 | 1 |
meds | 0 | 30 |
المجموع N_c | 198 | 280 |
الاحتمالان المسبقان هما P(H) = 499 / 999 = 0.4995 وP(S) = 500 / 999 = 0.5005، وV = 4 وalpha = 1.
الرسالة المطلوب تصنيفها هي رسالة الاختبار المزعجة من الدفتر:
Why pay more for expensive meds when you can order them online and save $$$?الخطوة 1: أي الكلمات يراها المرشح؟
لا تحسب إلا كلمات المفردات. تحتوي الرسالة على meds مرة واحدة وonline مرة واحدة؛ وتهمل كل كلمة أخرى (why وpay وorder وsave...) لأنها ليست في المفردات. ويفعل CountVectorizer الشيء نفسه تماما بمفرداته الخاصة، وهي أكبر كثيرا.
الخطوة 2: احتمالات الكلمات
مع alpha = 1، يكون كل مقام N_c + 4: أي 202 للسليمة و284 للمزعجة.
| الكلمة | P(w | H) | P(w | S) |
|---|---|---|
online | (7 + 1) / 202 = 0.0396 | (94 + 1) / 284 = 0.3345 |
meds | (0 + 1) / 202 = 0.00495 | (30 + 1) / 284 = 0.1092 |
الكلمتان كلتاهما أرجح كثيرا في الرسائل المزعجة منهما في الرسائل السليمة.
الخطوة 3: الدرجتان
score(H) = 0.4995 x 0.0396 x 0.00495 = 0.0000979
score(S) = 0.5005 x 0.3345 x 0.1092  = 0.0183
درجة المزعجة نحو 187 ضعف درجة السليمة.
الخطوة 4: التطبيع
P(S | e-mail) = 0.0183 / (0.0183 + 0.0000979) = 0.9947
P(H | e-mail) = 1 - 0.9947 = 0.0053
التنبؤ هو مزعجة. وللتحقق، يطبع MultinomialNB() المدرب على مصفوفة الأعداد نفسها ذات الكلمات الأربع (CountVectorizer(vocabulary=['money', 'online', 'meeting', 'meds'])) القيمة [0.00533, 0.99467] من predict_proba لهذه الرسالة.
افتح أداة مرشح الرسائل المزعجة بملء الشاشة لترى هذا المثال يتكون كلمة بكلمة. واختر كل الكلمات (8052 كلمة) لتمرر الرسالة نفسها على مرشح مدرب على كل كلمة تظهر في رسالتين على الأقل من الرسائل الـ999، بعد حذف كلمات التوقف الإنجليزية.
مشكلة العدد صفر وتنعيم لابلاس
وصلت رسالة جديدة:
Money for the meeting? The meeting is about meds.تحتوي على money مرة واحدة وmeeting مرتين وmeds مرة واحدة. والكلمة meeting قوية الدلالة على الرسائل السليمة (153 مرة في السليمة، ومرة واحدة في المزعجة)، لذا نتوقع أن تكون الرسالة سليمة.
دون تنعيم (alpha = 0)، يكون P(w | c) = n_wc / N_c. والكلمة meds لا تظهر أبدا في الرسائل السليمة الـ499، لذا:
P(meds | H) = 0 / 198 = 0
score(H) = 0.4995 x 0.1919 x 0.7727 x 0.7727 x 0 = 0
صفر واحد يمحو حاصل الضرب كله. فدرجة السليمة 0 تماما، لذا P(S | e-mail) = 1: النموذج متيقن تماما من أن الرسالة مزعجة، والكلمتان meeting لا أثر لهما.
مع تنعيم لابلاس (alpha = 1)، يضاف واحد إلى كل عدد، فلا يكون احتمال أي كلمة 0 أبدا:
| الكلمة | P(w | H) | P(w | S) |
|---|---|---|
money | 39 / 202 = 0.1931 | 156 / 284 = 0.5493 |
meeting | 154 / 202 = 0.7624 | 2 / 284 = 0.00704 |
meds | 1 / 202 = 0.00495 | 31 / 284 = 0.1092 |
score(H) = 0.4995 x 0.1931 x 0.7624 x 0.7624 x 0.00495 = 0.0002775
score(S) = 0.5005 x 0.5493 x 0.00704 x 0.00704 x 0.1092 = 0.000001488
P(H | e-mail) = 0.0002775 / (0.0002775 + 0.000001488) = 0.9947
الآن التنبؤ هو سليمة، باحتمال 0.9947، وهو ما يطابق predict_proba على نموذج الكلمات الأربع. ويطبق MultinomialNB() التنعيم بالقيمة alpha=1.0 ما لم تحدد قيمة أخرى. ومع مفردات حقيقية من آلاف الكلمات، تكون الكلمة التي لم تظهر قط في أحد الصنفين هي الحالة المعتادة لا الاستثناء، لذا فالتنعيم ضروري. في الأداة، اجعل التنعيم 0 واختر رسالة العدد صفر لترى الاحتمال اللاحق يقفز إلى 1 عند الكلمة meds.
الجزء 3: الدفتر 1، مرشح الرسائل المزعجة
افتح الدفتر
افتح E-Mail Classification في Colab
تقرأ خلية الكود الأولى الملف Data/ham-spam.csv من مجلد غير موجود بجوار الدفتر في Colab. اقرأ الملف من المستودع بدلا من ذلك:
import pandas as pd

url = ("https://raw.githubusercontent.com/"
       "jeffprosise/Machine-Learning/master/Data/ham-spam.csv")
df = pd.read_csv(url)
df.head()
تحميل البيانات وحذف المكرر
يعرض df.info() 1000 صف وعمودين: IsSpam (0 للسليمة، و1 للمزعجة) وText، وقد حولت حروفه إلى حروف صغيرة وحذفت منه علامات الترقيم مسبقا. ولا توجد قيم مفقودة.
df.groupby('IsSpam').describe()
df = df.drop_duplicates()
df.groupby('IsSpam').describe()
يعرض أول describe() عدد 500 رسالة سليمة، لكن 499 منها فقط فريدة: فرسالة سليمة واحدة تظهر مرتين. وبعد drop_duplicates() تصبح البيانات 999 صفا: 499 سليمة و500 مزعجة، وتبقى متوازنة.
تحويل النص إلى أعداد: CountVectorizer
لا يستطيع النموذج استخدام النص مباشرة، لذا تتحول كل رسالة إلى صف من أعداد الكلمات:
from sklearn.feature_extraction.text import CountVectorizer

vectorizer = CountVectorizer(ngram_range=(1, 2), stop_words='english')
x = vectorizer.fit_transform(df['Text'])
y = df['IsSpam']- يبني
fit_transformالمفردات من كل الرسائل ويعيد مصفوفة متفرقة (sparse matrix) من الأعداد: صف لكل رسالة، وعمود لكل مدخل في المفردات. - يحتفظ
ngram_range=(1, 2)بالكلمات المفردة وبأزواج الكلمات المتجاورة، مثلorder online. - يحذف
stop_words='english'كلمات التوقف (stop words)، وهي الكلمات الشائعة جدا مثلtheوforوyou. - قيمة
x.shapeهي(999, 100687): في المفردات 100687 مدخلا.
مثال محلول: ما يحتفظ به CountVectorizer
يحول الدفتر جملة غير مرتبة ثم يعيدها إلى كلمات ليبين التنظيف:
text = vectorizer.transform(['Why pay MORE for * expensive meds when you can ...123... order them online and save $$$?'])
text = vectorizer.inverse_transform(text)
print(text)
قبل تشغيله، توقع الكلمات التي تبقى. المخرجات:
[array(['expensive', 'meds', 'online', 'order', 'order online', 'pay',
       'save'], dtype='<U401')]
حولت MORE إلى حروف صغيرة ثم حذفت لأنها من كلمات التوقف، وكذلك why وfor وwhen وyou وcan وthem وand. واختفت الرموز و123. وبقي الزوج order online لأنه ظهر في رسائل التدريب.
التقسيم والتدريب
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=0)

from sklearn.naive_bayes import MultinomialNB
model = MultinomialNB()
model.fit(x_train, y_train)
يترك test_size=0.2 للاختبار 200 رسالة (102 سليمة و98 مزعجة)، ويجري التدريب على 799 رسالة. ولا يفعل fit أكثر من العد الذي أجريناه في الجزء 2: الاحتمالات المسبقة، واحتمال كل عمود من الأعمدة الـ100687 في كل صنف بعد التنعيم.
مصفوفة الالتباس
يستورد الدفتر plot_confusion_matrix، وقد حذفت من scikit-learn في الإصدار 1.2، لذا تفشل تلك الخلية اليوم بالخطأ ImportError. استخدم البديل:
from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_estimator(model, x_test, y_test,
    display_labels=['Not Spam', 'Spam'], cmap='Blues', xticks_rotation='vertical')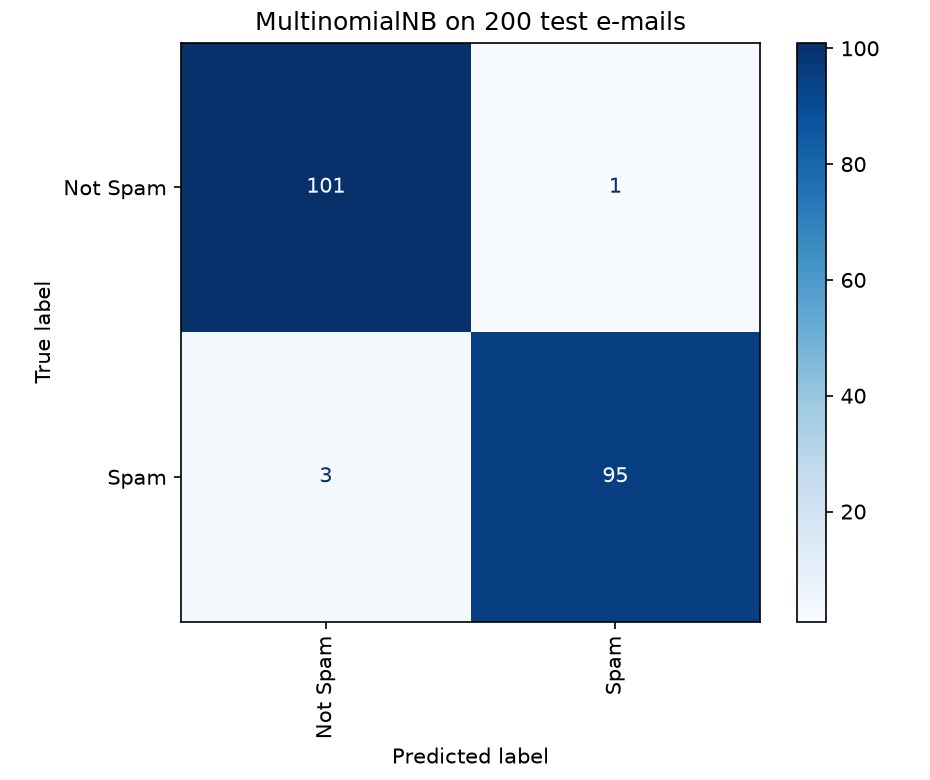
الصفوف هي الصنف الحقيقي والأعمدة هي التنبؤ. عرف النموذج 101 من 102 رسالة سليمة على أنها ليست مزعجة، و95 من 98 رسالة مزعجة على أنها مزعجة.
مثال محلول: تقييم مرشح الرسائل المزعجة
من المصفوفة:
accuracy          = (101 + 95) / 200 = 0.98
precision (spam)  = 95 / (95 + 1)    = 0.9896
recall (spam)     = 95 / (95 + 3)    = 0.9694
يطبع model.score(x_test, y_test) القيمة 0.98. ويخبرنا الضبط (precision) أن المرشح حين يحكم بأن الرسالة مزعجة يكون محقا دائما تقريبا: فرسالة سليمة واحدة فقط ذهبت إلى مجلد الرسائل المزعجة. ويخبرنا الاستدعاء (recall) أنه يكشف 97 في المئة من الرسائل المزعجة.
ثم يقيس الدفتر المساحة تحت منحنى ROC من الاحتمالات المتنبأ بها:
from sklearn.metrics import roc_auc_score

probabilities = model.predict_proba(x_test)
roc_auc_score(y_test, probabilities[:, 1])
الناتج 0.9992997198879552، وهو قريب جدا من القيمة المثالية 1.
تصنيف رسائل جديدة
message = vectorizer.transform(['Can you attend a code review on Tuesday? Need to make sure the logic is rock solid.'])
model.predict(message)[0]
model.predict_proba(message)[0][0]
تعيد predict القيمة 0 (ليست مزعجة)، واحتمال أنها ليست مزعجة 0.9999170457201042. وللرسالة المزعجة:
message = vectorizer.transform(['Why pay more for expensive meds when you can order them online and save $$$?'])
model.predict(message)[0]
model.predict_proba(message)[0][1]
تعيد predict القيمة 1 (مزعجة)، باحتمال 0.9997857610873945 أن تكون مزعجة. وتعيد predict_proba قيمتين لكل رسالة، احتمال الصنف 0 واحتمال الصنف 1، بهذا الترتيب.
الجزء 4: الدفتر 2، Naive Bayes الغاوسي على النبيذ
افتح الدفتر
افتح Naive_Bayes_Classification في Colab
يقرأ الدفتر الملف ./Datasets/wine.data.csv، وهو ليس بجواره في Colab. اقرأه من المستودع:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

url = ("https://raw.githubusercontent.com/tirthajyoti/"
       "Machine-Learning-with-Python/master/Datasets/wine.data.csv")
df = pd.read_csv(url)
بيانات النبيذ
تحتوي البيانات على 178 عينة نبيذ من عنب زرع في المنطقة نفسها من إيطاليا، لكن من ثلاث سلالات (cultivars) مختلفة، وهي العمود Class بالقيم 1 و2 و3 (59 و71 و48 عينة). أما الأعمدة الـ13 الأخرى فهي كميات المكونات التي كشفها التحليل الكيميائي، مثل Alcohol وFlavanoids وProline. والخصائص الـ13 كلها قيم عددية، لا أعداد كلمات.
يرسم الدفتر مخططا صندوقيا (boxplot) لكل خاصية، مقسما حسب الصنف:
for c in df.columns[1:]:
    df.boxplot(c, by='Class', figsize=(7, 4), fontsize=14)
    plt.title("{}\n".format(c), fontsize=16)
    plt.xlabel("Wine Class", fontsize=16)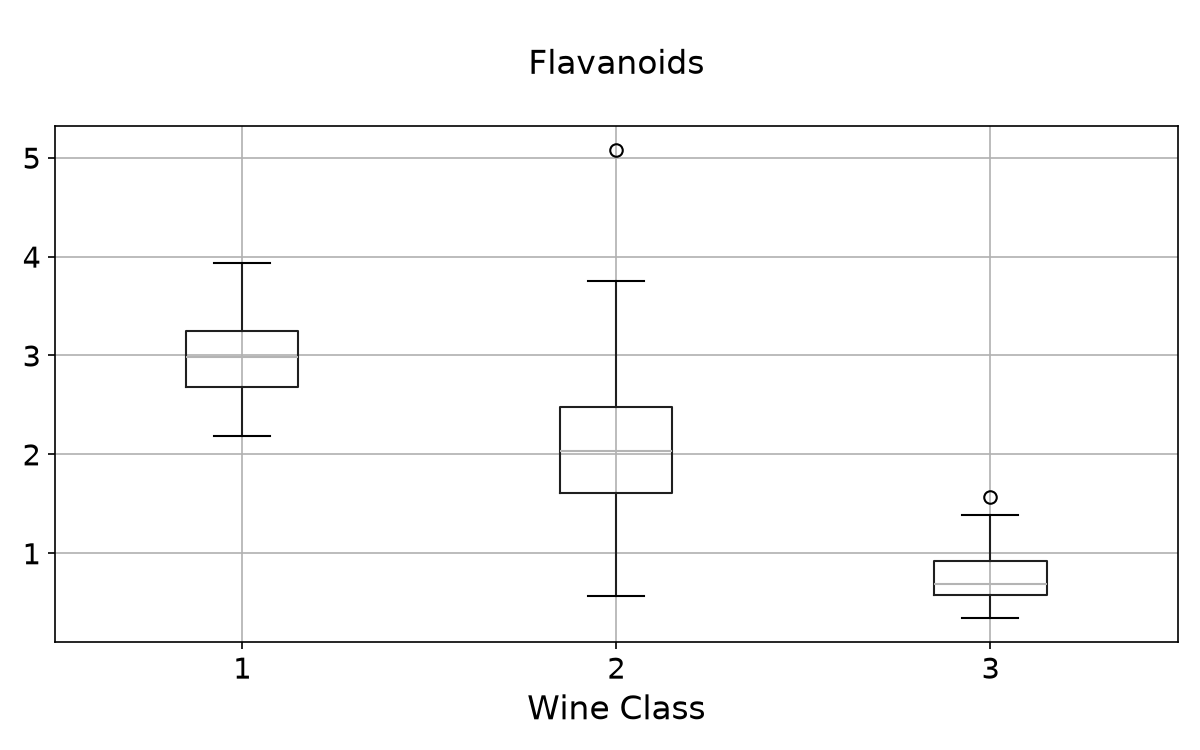
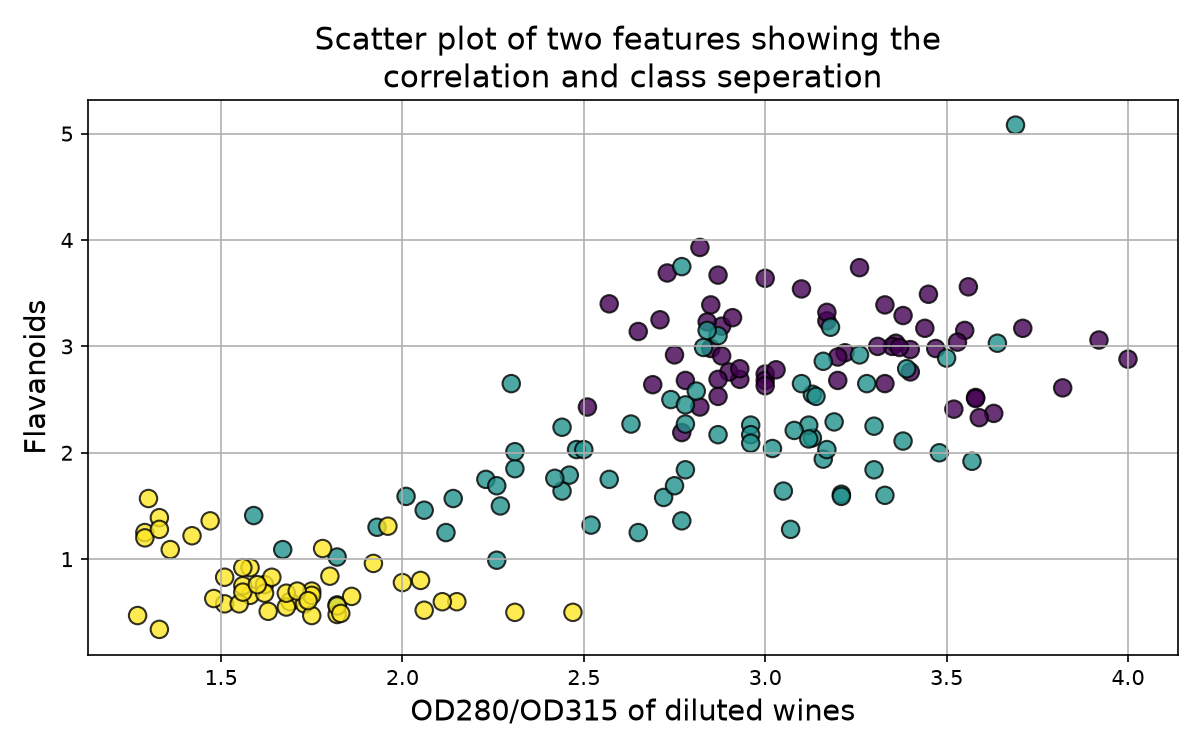
تفصل بعض الخصائص بين الأصناف بوضوح. فقيمة Flavanoids مرتفعة في الصنف 1، ووسطى في الصنف 2، ومنخفضة في الصنف 3. ويبين مخطط الانتشار (scatter plot) لخاصيتين الصورة في بعدين: يقع الصنف 3 وحده عند القيم المنخفضة للخاصيتين، بينما يتداخل الصنفان 1 و2 تداخلا كبيرا.
هل الخصائص مستقلة؟
يفترض Naive Bayes أن الخصائص مستقلة عند معرفة الصنف. ويتحقق الدفتر من ذلك بمصفوفة الارتباط (correlation matrix). وخليته تستخدم cm.get_cmap، التي حذفت من إصدارات Matplotlib الحديثة، وتضبط نصوص علامات المحورين دون ضبط مواضع العلامات، فتقع النصوص في أماكن خاطئة. النسخة المصححة:
def correlation_matrix(df):
    fig = plt.figure(figsize=(16, 12))
    ax1 = fig.add_subplot(111)
    cmap = plt.get_cmap('jet', 30)
    cax = ax1.imshow(df.corr(), interpolation="nearest", cmap=cmap)
    ax1.grid(True)
    plt.title('Wine data set features correlation\n', fontsize=15)
    labels = df.columns
    ax1.set_xticks(range(len(labels)))
    ax1.set_yticks(range(len(labels)))
    ax1.set_xticklabels(labels, fontsize=9, rotation=90)
    ax1.set_yticklabels(labels, fontsize=9)
    fig.colorbar(cax, ticks=[0.1 * i for i in range(-11, 11)])
    plt.show()

correlation_matrix(df)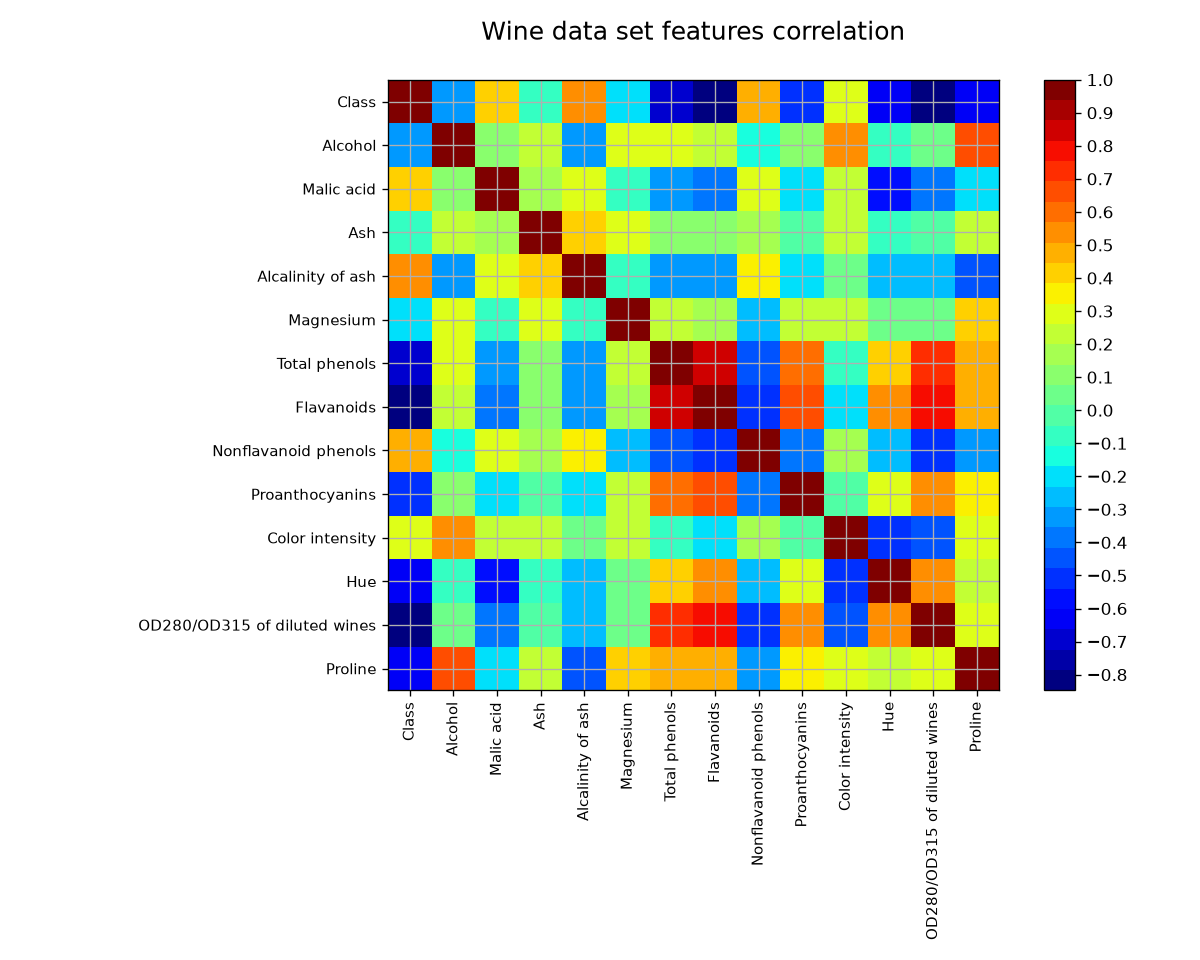
الارتباط بين Flavanoids وTotal phenols هو 0.86، وبينها وبين OD280/OD315 of diluted wines هو 0.79. فمن الواضح أن الخصائص ليست مستقلة. ومع ذلك يطبق الدفتر المصنف ليرى أداءه.
الأرجحية الغاوسية
تناسب أعداد الكلمات MultinomialNB. أما مع الخصائص العددية فيفترض GaussianNB أن كل خاصية داخل كل صنف تتبع منحنى جرسيا (توزيعا غاوسيا، Gaussian). لقيمة خاصية x في الصنف c:
f(x | c) = 1 / square root(2 pi sigma_c^2) x e^( -(x - mu_c)^2 / (2 sigma_c^2) )mu_c: متوسط (mean) الخاصية على صفوف التدريب من الصنفcsigma_c: الانحراف المعياري (standard deviation) للخاصية في الصنفc(بالقسمة على n)f(x | c): ارتفاع المنحنى الجرسي عندx، ويستخدم بوصفه الأرجحية
يحسب fit متوسطا واحدا وانحرافا معياريا واحدا لكل خاصية ولكل صنف، إضافة إلى الاحتمالات المسبقة. وبقية القاعدة كما في الجزء 2: اضرب الاحتمال المسبق في الأرجحيات، واختر الأكبر، ثم طبق التطبيع.
مثال محلول: عينة نبيذ واحدة، وخاصية واحدة
نستخدم خاصية واحدة، Flavanoids، على عينات النبيذ الـ178 كلها. وهذا متوسطها وانحرافها المعياري في كل صنف:
| الصنف | العينات | المتوسط mu | الانحراف المعياري sigma |
|---|---|---|---|
| 1 | 59 | 2.982 | 0.394 |
| 2 | 71 | 2.081 | 0.701 |
| 3 | 48 | 0.781 | 0.290 |
لعينة نبيذ جديدة القيمة Flavanoids = 2.0. بأي صنف يتنبأ Naive Bayes الغاوسي؟
الخطوة 1: الأس لكل صنف
الأس هو -(x - mu)^2 / (2 sigma^2):
class 1: -(2.0 - 2.982)^2 / (2 x 0.394^2) = -0.9643 / 0.3105 = -3.106
class 2: -(2.0 - 2.081)^2 / (2 x 0.701^2) = -0.00656 / 0.9828 = -0.0067
class 3: -(2.0 - 0.781)^2 / (2 x 0.290^2) = -1.4860 / 0.1682 = -8.834
القيمة 2.0 قريبة من متوسط الصنف 2، لذا فأسها قريب جدا من 0.
الخطوة 2: الكثافات
اضرب e مرفوعا إلى الأس في المعامل 1 / square root(2 pi sigma^2) لتحصل على الكثافة (density):
f(2.0 | 1) = 1.0125 x e^(-3.106)  = 1.0125 x 0.04478  = 0.0453
f(2.0 | 2) = 0.5691 x e^(-0.0067) = 0.5691 x 0.99335  = 0.5653
f(2.0 | 3) = 1.3757 x e^(-8.834)  = 1.3757 x 0.000146 = 0.000200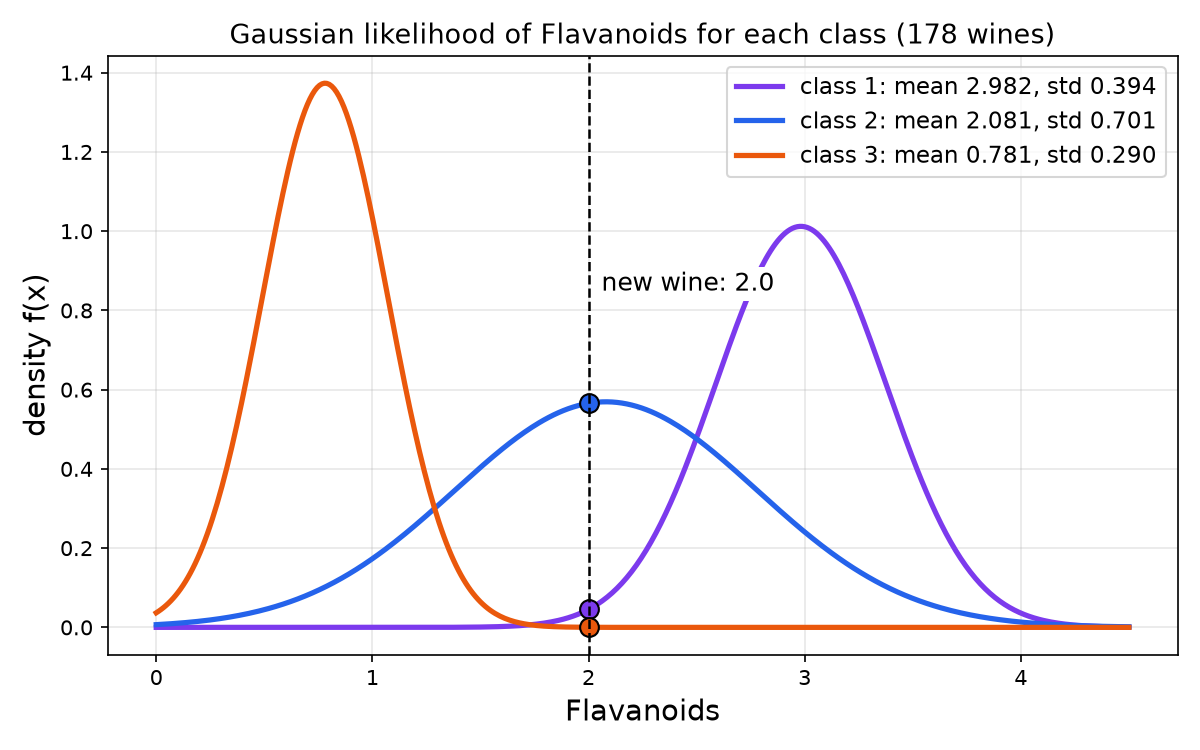
الخطوة 3: الاحتمالات المسبقة والدرجات والاحتمال اللاحق
الاحتمالات المسبقة هي 59/178 = 0.3315 و71/178 = 0.3989 و48/178 = 0.2697.
| الصنف | f(x | c) | P(c) | الدرجة | الاحتمال اللاحق |
|---|---|---|---|---|
| 1 | 0.0453 | 0.3315 | 0.015029 | 0.0625 |
| 2 | 0.5653 | 0.3989 | 0.22549 | 0.9373 |
| 3 | 0.000200 | 0.2697 | 0.000054 | 0.0002 |
مجموع الدرجات 0.24057، وكل احتمال لاحق هو درجته مقسومة على هذا المجموع. والتنبؤ هو الصنف 2، باحتمال نحو 0.94. ويطبع GaussianNB المدرب على Flavanoids وحدها [0.0624, 0.9374, 0.0002]؛ ويختلف الرقم الأخير لأننا قربنا المتوسطات والانحرافات المعيارية إلى ثلاث منازل عشرية.
افتح أداة Naive Bayes الغاوسي بملء الشاشة. اسحب على الرسم لتحريك عينة النبيذ، وبدل الخاصية، وقارن الاحتمالات المسبقة المأخوذة من البيانات بالاحتمالات المسبقة المتساوية.
التدريب على الخصائص الـ13 كلها
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB

X = df.drop('Class', axis=1)
y = df['Class']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)

nbc = GaussianNB()
nbc.fit(X_train, y_train)
y_pred = nbc.predict(X_test)
mislabel = np.sum((y_test != y_pred))
print("Total number of mislabelled data points from {} test samples is {}".format(len(y_test), mislabel))
ليس في تقسيم الدفتر random_state، لذا يسحب كل تشغيل تقسيما مختلفا ويطبع عددا مختلفا (مخرجاته المحفوظة تعرض 2). ومع random_state=0، كما في الكود أعلاه، يصبح التقسيم قابلا للتكرار: 124 عينة للتدريب، و54 عينة للاختبار، والمخرجات هي:
Total number of mislabelled data points from 54 test samples is 3الدقة (accuracy) هي 51 / 54 = 0.9444. ومصفوفة الالتباس، confusion_matrix(y_test, y_pred):
| التنبؤ 1 | التنبؤ 2 | التنبؤ 3 | |
|---|---|---|---|
| الحقيقي 1 | 19 | 0 | 0 |
| الحقيقي 2 | 2 | 19 | 1 |
| الحقيقي 3 | 0 | 0 | 13 |
الأخطاء الثلاثة كلها في عينات من الصنف 2: صنفت اثنتان منها في الصنف 1، وواحدة في الصنف 3. ويؤدي المصنف أداء جيدا مع أن افتراض الاستقلال خاطئ بوضوح لهذه الخصائص.
تقرير معكوس
يطبع الدفتر classification_report(y_pred, y_test). والدالة تتوقع التسميات الحقيقية أولا: classification_report(y_test, y_pred). ومع تبديل الوسيطين، يتبادل الضبط والاستدعاء مكانيهما، ويعد support التنبؤات بدلا من الأصناف الحقيقية. للصنف 2:
| الصيغة | الضبط | الاستدعاء | support |
|---|---|---|---|
classification_report(y_pred, y_test) | 0.86 | 1.00 | 19 |
classification_report(y_test, y_pred) | 1.00 | 0.86 | 22 |
راجع الصف الصحيح مقابل مصفوفة الالتباس. يقرأ الضبط على طول العمود: 19 عينة تنبأ النموذج بأنها من الصنف 2، والـ19 كلها من الصنف 2 فعلا، لذا 19 / 19 = 1.00. ويقرأ الاستدعاء على طول الصف: 22 عينة من الصنف 2 حقا، وجد النموذج 19 منها، لذا 19 / 22 = 0.86. وتطبع الصيغة الصحيحة ما يلي:
              precision    recall  f1-score   support

           1       0.90      1.00      0.95        19
           2       1.00      0.86      0.93        22
           3       0.93      1.00      0.96        13

    accuracy                           0.94        54
   macro avg       0.94      0.95      0.95        54
weighted avg       0.95      0.94      0.94        54
مرر التسميات الحقيقية أولا دائما، إلى confusion_matrix وإلى classification_report على السواء.
الأخطاء الشائعة
- قراءة
Data/ham-spam.csvأو./Datasets/wine.data.csvفي Colab من مجلد غير موجود هناك. - استخدام
plot_confusion_matrix، وهي لم تعد موجودة. استخدمConfusionMatrixDisplay.from_estimator. - ضبط
alpha=0: كلمة واحدة لم تظهر قط في صنف ما تجعل احتمال ذلك الصنف 0 تماما. - تشغيل
fit_transformعلى الرسائل الجديدة. يحتاج النص الجديد إلىvectorizer.transform، ليستخدم المفردات التي تعلمها من التدريب. - تمرير سلسلة نصية واحدة إلى
transform. فهي تحتاج إلى قائمة:vectorizer.transform(['...']). - تبديل وسيطي
classification_report: التسميات الحقيقية أولا. - استخدام
MultinomialNBعلى قياسات عددية مثل خصائص النبيذ. أعداد الكلمات إلىMultinomialNB، والخصائص المتصلة إلىGaussianNB.
مرحلة المشروع: تنفيذ النموذج
تواصل مرحلة هذا الأسبوع تنفيذ النموذج على بيانات مشروع فريقك. أضف Naive Bayes:
- اختر النوع:
MultinomialNBإذا كانت خصائصك أعداد كلمات (حول النص إلى أعداد باستخدامCountVectorizer)، وGaussianNBإذا كانت قياسات عددية. - قسم البيانات بقيمة ثابتة للمعامل
random_stateليكون الناتج قابلا للتكرار. - درب النموذج وتنبأ بمجموعة الاختبار.
- اعرض مصفوفة الالتباس و
classification_report، مع التسميات الحقيقية أولا. - قارن بنماذجك من الأسبوعين 5 و6 على التقسيم نفسه، واكتب أيها تحتفظ به ولماذا.
الخلاصة
- تحول نظرية بايز الأرجحية
P(x | c)، التي يمكننا عدها، إلى الاحتمال اللاحقP(c | x)، الذي نريده. - يفترض Naive Bayes أن الخصائص مستقلة عند معرفة الصنف، لذا فأرجحية الرسالة حاصل ضرب أرجحيات كلماتها المفردة.
- تنبأ بالصنف صاحب أكبر درجة
prior x likelihoods، وطبق التطبيع على الدرجات لتحصل على احتمالات. - يمنع تنعيم لابلاس (
alpha=1) كلمة واحدة لم تظهر في صنف ما من فرض احتمال قدره 0. - يعمل
MultinomialNBعلى أعداد الكلمات، ويطابقGaussianNBمنحنى جرسيا لكل صنف على الخصائص العددية. - يتدرب Naive Bayes بالعد، لذا فهو سريع، ويؤدي أداء جيدا حتى حين يكون افتراض الاستقلال خاطئا.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: نظرية بايز لكلمتين أخريين (نحو 5 دقائق)
في الرسائل الـ999، تظهر click في 50 من الرسائل المزعجة الـ500، وفي 6 من الرسائل السليمة الـ499. وتظهر meeting في 1 من الرسائل المزعجة، وفي 89 من الرسائل السليمة.
- احسب
P(S | click)بنظرية بايز، خطوة بخطوة. - احسب
P(S | meeting). - تحقق من الإجابتين بالعد المباشر.
التمرين 2: مرشح الكلمات الأربع (نحو 10 دقائق)
استخدم مرشح الكلمات الأربع من المثال المحلول (alpha = 1). وصنف الرسالة:
Make money online, no meeting needed- أي الكلمات يراها المرشح؟
- احسب درجتي السليمة والمزعجة.
- احسب
P(S | e-mail)واذكر التنبؤ.
التمرين 3: Naive Bayes الغاوسي يدويا (نحو 5 دقائق)
استخدم جدول Flavanoids من المثال المحلول. لعينة نبيذ جديدة القيمة Flavanoids = 2.5. والمعاملات 1 / square root(2 pi sigma^2) هي نفسها كما في المثال: 1.0125 و0.5691 و1.3757.
- احسب
f(2.5 | c)للصنفين 1 و2. فالصنف 3 بعيد جدا حتى إن كثافته تساوي 0 عمليا. - احسب الدرجات بالاحتمالات المسبقة المأخوذة من البيانات، وتنبأ بالصنف.
- أي صنف كان سيفوز مع احتمالات مسبقة متساوية (الثلث لكل صنف)؟
التمرين 4: في Colab (نحو 10 دقائق)
- شغل الدفتر 1 مع الإصلاحين (عنوان البيانات و
ConfusionMatrixDisplay). - ينتهي الدفتر بسؤال: هل يمكنك تصنيف دفعة كاملة من الرسائل بأمر واحد؟ صنف هذه الرسائل الثلاث بتشغيل
predictمرة واحدة وpredict_probaمرة واحدة:Can you attend a code review on Tuesday? Need to make sure the logic is rock solid.Why pay more for expensive meds when you can order them online and save $$$?Make money online, no meeting needed
- قارن الإجابة عن الرسالة الثالثة بإجابتك في التمرين 2. لماذا تختلفان؟ تلميح: اطبع
vectorizer.inverse_transformلها. - في الدفتر 2، غير
random_stateإلى 1 ثم إلى 42. كم عينة نبيذ من عينات الاختبار تصنف خطأ في كل مرة؟
الإجابات
الإجابة 1
للكلمة click:
P(S)         = 500 / 999 = 0.5005
P(click | S) = 50 / 500  = 0.1
P(click)     = (50 + 6) / 999 = 56 / 999 = 0.056056
P(S | click) = 0.1 x 0.5005 / 0.056056 = 0.8929
للكلمة meeting:
P(meeting | S) = 1 / 500 = 0.002
P(meeting)     = (1 + 89) / 999 = 90 / 999 = 0.09009
P(S | meeting) = 0.002 x 0.5005 / 0.09009 = 0.0111
العد المباشر: 50 / 56 = 0.8929 و1 / 90 = 0.0111، وهما القيمتان نفسهما. فالكلمة click دليل قوي على أن الرسالة مزعجة، والكلمة meeting دليل قوي على أنها سليمة.
الإجابة 2
- يرى المرشح
moneyمرة واحدة وonlineمرة واحدة وmeetingمرة واحدة. أماmakeوnoوneededفليست في مفرداته. - احتمالات الكلمات مأخوذة من المثال المحلول:
| الكلمة | P(w | H) | P(w | S) |
|---|---|---|
money | 0.1931 | 0.5493 |
online | 0.0396 | 0.3345 |
meeting | 0.7624 | 0.00704 |
score(H) = 0.4995 x 0.1931 x 0.0396 x 0.7624 = 0.002912
score(S) = 0.5005 x 0.5493 x 0.3345 x 0.00704 = 0.0006474
P(S | e-mail) = 0.0006474 / (0.002912 + 0.0006474) = 0.1819، لذا فالتنبؤ سليمة. تدفعmoneyوonlineنحو المزعجة، لكنmeetingأرجح في الرسائل السليمة منها في المزعجة بنحو 108 أضعاف، فترجح على الكلمتين معا. وتعطيpredict_probaعلى نموذج الكلمات الأربع[0.81805, 0.18195].
الإجابة 3
class 1: -(2.5 - 2.982)^2 / (2 x 0.394^2) = -0.7483,  f = 1.0125 x 0.4732 = 0.4791
class 2: -(2.5 - 2.081)^2 / (2 x 0.701^2) = -0.1786,  f = 0.5691 x 0.8364 = 0.4760
الكثافتان متساويتان تقريبا: فالقيمة 2.5 تقع حيث يتقاطع منحنيا الصنفين 1 و2.
| الصنف | f(x | c) | P(c) | الدرجة |
|---|---|---|---|
| 1 | 0.4791 | 0.3315 | 0.1588 |
| 2 | 0.4760 | 0.3989 | 0.1899 |
P(2 | x) = 0.1899 / (0.1588 + 0.1899) = 0.5446، لذا فالتنبؤ الصنف 2. تكاد الأرجحيتان تتعادلان، ويحسم الاحتمال المسبق الأكبر للصنف 2 (71 عينة مقابل 59) النتيجة. ويطبع GaussianNB القيمة 0.5448 للصنف 2 بإحصاءات غير مقربة.
ومع احتمالات مسبقة متساوية تتناسب الدرجات مع الكثافات، ويفوز الصنف 1 بفارق ضئيل: 0.4791 / (0.4791 + 0.4760) = 0.5016. وحين يتوازن الدليل، يحسم الاحتمال المسبق.
الإجابة 4
الخطوتان 1 و2:
msgs = ['Can you attend a code review on Tuesday? Need to make sure the logic is rock solid.',
        'Why pay more for expensive meds when you can order them online and save $$$?',
        'Make money online, no meeting needed']
X = vectorizer.transform(msgs)
print(model.predict(X))
print(model.predict_proba(X).round(4))
[0 1 1]
[[9.999e-01 1.000e-04]
[2.000e-04 9.998e-01]
[2.998e-01 7.002e-01]]يعيد التشغيل الواحد تنبؤا واحدا لكل رسالة، بترتيب القائمة: الصف i من predict_proba يخص الرسالة i.
الخطوة 3: يصنف نموذج الدفتر الرسالة الثالثة مزعجة (0.7002)، بينما صنفها مرشح الكلمات الأربع سليمة (0.1819). فالمفردات الكاملة ترى من الرسالة أكثر:
[array(['make', 'make money', 'meeting', 'money', 'needed', 'online'],
      dtype='<U401')]
صارت الكلمتان make وneeded والزوج make money دليلا أيضا، وهي معا ترجح على meeting. فإجابة Naive Bayes تعتمد على الكلمات التي تحتويها المفردات.
الخطوة 4: مع random_state=1، تصنف 1 عينة اختبار خطأ (الدقة 0.9815). ومع random_state=42، لا تصنف أي عينة خطأ، أي 0 (الدقة 1.0). ومع random_state=0 كان العدد 3. وعلى 54 عينة اختبار، تمثل العينة الواحدة 1/54 = 0.0185 من الدقة، لذا فهذه الفروق تأتي من التقسيم، لا من نموذج أفضل.