

التجميع بخوارزمية k-Means
تعلم كل نموذج رأيناه حتى الآن في هذا المقرر من صفوف ذات تسميات: سعر، أو صنف، أو رسالة مزعجة أو سليمة. ويبدأ هذا القسم التعلم غير الموجه (unsupervised learning)، حيث لا تحمل الصفوف أي تسمية على الإطلاق. تجمع خوارزمية k-means الصفوف المتشابهة في k من العناقيد (clusters) بنفسها. ستطبق الخوارزمية يدويا على خمسة عملاء حقيقيين، ثم تستخدم دفتري (notebooks) الأسبوع 8 لتقسيم 200 عميل من عملاء مجمع تجاري إلى شرائح (segments) من أجل حملة تسويقية، ولتجميع 777 كلية دون أن تخبر النموذج أيها خاصة.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- شرح الفرق بين التعلم الموجه (supervised learning) والتجميع (clustering).
- تطبيق k-means يدويا: إسناد كل نقطة إلى أقرب مركز (centroid) إليها، ونقل كل مركز إلى متوسط نقاطه، والتكرار حتى لا يتغير شيء.
- حساب مجموع المربعات داخل العناقيد (within-cluster sum of squares, WCSS)، الذي تسميه scikit-learn
inertia_. - تدريب
KMeans، وقراءةcluster_centers_وlabels_وpredict، واختيار k بطريقة الكوع (elbow method). - تقسيم العملاء إلى شرائح، وتحديد الشريحة التي يجب أن تستهدفها الحملة.
- شرح لماذا قد تعطي بداية مختلفة نتيجة مختلفة، وما يفعله
n_initحيال ذلك.
موقع الدرس من المقرر
للأسبوع 8 في الخطة ثلاثة أجزاء:
- دفتران. يجمع
Clusteringنقاطا مولدة ثم بيانات عملاء حقيقية. ويجمعK_Means_Clustering_Practice777 كلية أمريكية في عنقودين، ويقارنهما بالتسميات الحقيقية: خاصة وحكومية. - سيناريو من الواقع. تقسيم العملاء إلى شرائح بناء على بياناتهم، لتحديد العملاء الذين تستهدفهم حملة لمنتج جديد أو عرض ترويجي (promotion) يزيد نشاطهم الشرائي.
- مرحلة المشروع (project milestone). عروض فرق المشاريع ومناقشاتها (Project Teams Presentations and Discussions): في هذا الأسبوع يعرض فريقك مشروعه ويناقشه.
في الأسبوع 5 قست المسافات الإقليدية (Euclidean distances) من أجل KNN، وفي الأسابيع من 3 إلى 7 استدعيت fit وpredict على نماذج كثيرة. وتستخدم k-means الأمرين معا: المسافة نفسها، ونمط fit وpredict نفسه. والجديد أنه لا يوجد y نتعلم منه.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | التجميع وخوارزمية k-means، ثم خمسة عملاء يدويا | 40 دقيقة |
| 2 | الدفتر 1: الكتل (blobs) وطريقة الكوع | 15 دقيقة |
| 3 | الدفتر 1: تقسيم العملاء إلى شرائح | 20 دقيقة |
| 4 | الدفتر 2: الكليات، ومرحلة المشروع | 15 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1: فكرة التجميع
التعلم الموجه والتجميع
| التعلم الموجه (الأسابيع من 3 إلى 7) | التجميع (هذا الأسبوع) | |
|---|---|---|
| بيانات التدريب | الخصائص (features) X وتسمية (label) y | الخصائص X فقط |
| ما يتعلمه النموذج | كيف يتنبأ بقيمة y | مجموعات من الصفوف المتشابهة |
| مثال | تتنبأ KNN بنوع زهرة iris | تجد k-means شرائح العملاء |
| التحقق من النتيجة | مقارنة التنبؤات بقيمة y الحقيقية | لا توجد إجابة صحيحة في العادة |
التجميع طريقة تعلم غير موجه لتجميع البيانات في عناقيد بهدف اكتشاف أوجه التشابه. وخوارزمية k-means طريقة شائعة لإجراء التجميع، وتوفرها scikit-learn باسم KMeans.
ما خوارزمية k-means
تقسم خوارزمية k-means مجموعة من العينات إلى k من العناقيد لا تتداخل. ويوصف كل عنقود بمتوسط (mean) عيناته، ويسمى هذا المتوسط مركزه. والمركز في العادة ليس إحدى نقاط البيانات، لكنه يقع في الفضاء نفسه: فللعملاء الموصوفين بالدخل والإنفاق، يكون المركز أيضا زوجا (الدخل، الإنفاق).
الخوارزمية
- اختر k وضع k من مراكز البداية، مثلا على k من النقاط تختارها عشوائيا من البيانات.
- خطوة الإسناد (assign step): تنضم كل نقطة إلى عنقود أقرب مركز إليها، ويقاس القرب بمربع المسافة الإقليدية.
- خطوة التحديث (update step): ينتقل كل مركز إلى متوسط النقاط المسندة إليه.
- كرر الخطوتين 2 و3 حتى لا تغير أي نقطة عنقودها (أو حتى الوصول إلى حد أقصى لعدد التكرارات).
الخوارزمية مضمونة التوقف. لكن النتيجة قد تكون حلا أمثل محليا (local optimum)، وليست بالضرورة أفضل تجميع ممكن، لذا يستحسن تشغيلها عدة مرات من بدايات عشوائية مختلفة والاحتفاظ بأفضل تشغيل.
الصيغ
لنقطة (x, y) ومركز (a, b)، مربع المسافة هو:
لا حاجة إلى الجذر التربيعي: فهو لا يغير أبدا أي المراكز هو الأقرب.
في خطوة التحديث، ينقل العنقود الذي فيه من النقاط مركزه إلى:
ما جودة التجميع؟ WCSS
اجمع مربع المسافة من كل نقطة إلى مركز عنقودها:
حيث N عدد النقاط، و المسافة من النقطة إلى مركزها. وJ هو مجموع المربعات داخل العناقيد (WCSS)، وتسميه scikit-learn القصور الذاتي (inertia) وتخزنه في kmeans.inertia_. وقيمة J الصغيرة تعني عناقيد متماسكة، نقاطها قريبة من مراكزها. وقد صممت خوارزمية k-means لتجعل J صغيرا.
مثال محلول: خمسة عملاء يدويا
نأخذ خمسة عملاء حقيقيين من بيانات العملاء في الدفتر 1، بخاصيتين: الدخل السنوي بآلاف الدولارات، ودرجة الإنفاق (spending score) من 1 إلى 100.
| العميل | الدخل (ألف دولار) | درجة الإنفاق |
|---|---|---|
| #11 | 19 | 14 |
| #49 | 40 | 42 |
| #62 | 46 | 55 |
| #136 | 73 | 88 |
| #190 | 103 | 85 |
نستخدم k = 2، ونبدأ المركزين عند اثنين من العملاء: μ1 = #11 = (19, 14) وμ2 = #62 = (46, 55). كل فرق أدناه هو العميل ناقص المركز، والفرق السالب مربعه عدد موجب.
التكرار 1: الإسناد
| العميل | (الدخل، الإنفاق) | d² إلى μ1 (19, 14) | d² إلى μ2 (46, 55) | ينضم إلى |
|---|---|---|---|---|
| #11 | (19, 14) | 0 + 0 = 0 | 729 + 1681 = 2410 | μ1 |
| #49 | (40, 42) | 441 + 784 = 1225 | 36 + 169 = 205 | μ2 |
| #62 | (46, 55) | 729 + 1681 = 2410 | 0 + 0 = 0 | μ2 |
| #136 | (73, 88) | 2916 + 5476 = 8392 | 729 + 1089 = 1818 | μ2 |
| #190 | (103, 85) | 7056 + 5041 = 12097 | 3249 + 900 = 4149 | μ2 |
فمثلا للعميل #49: (40 - 19)² + (42 - 14)² = 441 + 784 = 1225 و(40 - 46)² + (42 - 55)² = 36 + 169 = 205، لذا ينضم #49 إلى μ2.
يضم العنقود 1 العميل #11 وحده، ويضم العنقود 2 العملاء الأربعة الآخرين.
التكرار 1: التحديث
- للمركز μ1 نقطة واحدة، فيبقى عند (19, 14).
- ينتقل μ2 إلى متوسط #49 و#62 و#136 و#190: الدخل
(40 + 46 + 73 + 103) / 4 = 262 / 4 = 65.5، والإنفاق(42 + 55 + 88 + 85) / 4 = 270 / 4 = 67.5، إذن μ2 = (65.5, 67.5).
التكرار 2: الإسناد
| العميل | (الدخل، الإنفاق) | d² إلى μ1 (19, 14) | d² إلى μ2 (65.5, 67.5) | ينضم إلى |
|---|---|---|---|---|
| #11 | (19, 14) | 0 + 0 = 0 | 2162.25 + 2862.25 = 5024.5 | μ1 |
| #49 | (40, 42) | 441 + 784 = 1225 | 650.25 + 650.25 = 1300.5 | μ1 |
| #62 | (46, 55) | 729 + 1681 = 2410 | 380.25 + 156.25 = 536.5 | μ2 |
| #136 | (73, 88) | 2916 + 5476 = 8392 | 56.25 + 420.25 = 476.5 | μ2 |
| #190 | (103, 85) | 7056 + 5041 = 12097 | 1406.25 + 306.25 = 1712.5 | μ2 |
العميل #49 يغير عنقوده. ابتعد المركز μ2 نحو العملاء الأغنياء كثيري الإنفاق، فأصبح #49 أقرب قليلا إلى μ1 (1225 مقابل 1300.5).
التكرار 2: التحديث
- μ1 = متوسط #11 و#49:
(19 + 40) / 2 = 29.5و(14 + 42) / 2 = 28، إذن μ1 = (29.5, 28). - μ2 = متوسط #62 و#136 و#190:
(46 + 73 + 103) / 3 = 222 / 3 = 74و(55 + 88 + 85) / 3 = 228 / 3 = 76، إذن μ2 = (74, 76).
التكرار 3: الإسناد
| العميل | (الدخل، الإنفاق) | d² إلى μ1 (29.5, 28) | d² إلى μ2 (74, 76) | ينضم إلى |
|---|---|---|---|---|
| #11 | (19, 14) | 110.25 + 196 = 306.25 | 3025 + 3844 = 6869 | μ1 |
| #49 | (40, 42) | 110.25 + 196 = 306.25 | 1156 + 1156 = 2312 | μ1 |
| #62 | (46, 55) | 272.25 + 729 = 1001.25 | 784 + 441 = 1225 | μ1 |
| #136 | (73, 88) | 1892.25 + 3600 = 5492.25 | 1 + 144 = 145 | μ2 |
| #190 | (103, 85) | 5402.25 + 3249 = 8651.25 | 841 + 81 = 922 | μ2 |
العميل #62 يغير عنقوده أيضا (1001.25 مقابل 1225).
التكرار 3: التحديث
- μ1 = متوسط #11 و#49 و#62:
(19 + 40 + 46) / 3 = 105 / 3 = 35و(14 + 42 + 55) / 3 = 111 / 3 = 37، إذن μ1 = (35, 37). - μ2 = متوسط #136 و#190:
(73 + 103) / 2 = 88و(88 + 85) / 2 = 86.5، إذن μ2 = (88, 86.5).
التكرار 4: الإسناد، ثم التوقف
| العميل | (الدخل، الإنفاق) | d² إلى μ1 (35, 37) | d² إلى μ2 (88, 86.5) | ينضم إلى |
|---|---|---|---|---|
| #11 | (19, 14) | 256 + 529 = 785 | 4761 + 5256.25 = 10017.25 | μ1 |
| #49 | (40, 42) | 25 + 25 = 50 | 2304 + 1980.25 = 4284.25 | μ1 |
| #62 | (46, 55) | 121 + 324 = 445 | 1764 + 992.25 = 2756.25 | μ1 |
| #136 | (73, 88) | 1444 + 2601 = 4045 | 225 + 2.25 = 227.25 | μ2 |
| #190 | (103, 85) | 4624 + 2304 = 6928 | 225 + 2.25 = 227.25 | μ2 |
لا يغير أي عميل عنقوده، فلن تتحرك المراكز مرة أخرى: لقد اكتمل التقارب (converged). العنقودان النهائيان هما (#11, #49, #62) حول (35, 37)، وهم عملاء دخلهم أقل وإنفاقهم أقل، و**(#136, #190)** حول (88, 86.5)، وهم عملاء دخلهم مرتفع وإنفاقهم مرتفع.
قيمة WCSS لم تزد أبدا
بعد كل خطوة يمكننا جمع مربعات مسافات العملاء الخمسة إلى مراكزهم (الأعداد الغامقة في عمود العنقود الذي ينتمي إليه كل عميل):
| التكرار | J بعد خطوة الإسناد | J بعد خطوة التحديث |
|---|---|---|
| 1 | 0 + 205 + 0 + 1818 + 4149 = 6172 | 4026 |
| 2 | 0 + 1225 + 536.5 + 476.5 + 1712.5 = 3950.5 | 2904.5 |
| 3 | 306.25 + 306.25 + 1001.25 + 145 + 922 = 2680.75 | 1734.5 |
| 4 | 785 + 50 + 445 + 227.25 + 227.25 = 1734.5 | اكتمل التقارب |
كل خطوة من الخطوتين تخفض J أو تبقيه كما هو: فخطوة الإسناد تعطي كل نقطة أقرب مركز إليها، وفي خطوة التحديث يكون المتوسط هو الموضع الذي له أصغر مجموع لمربعات المسافات إلى نقاط عنقوده. والقيمة النهائية J = 1734.5 هي بالضبط ما تعطيه scikit-learn. وقد تحققنا منها باستخدام KMeans(n_clusters=2, init=start, n_init=1)، حيث يحمل start مركزي البداية:
import numpy as np
from sklearn.cluster import KMeans

X = np.array([[19, 14], [40, 42], [46, 55], [73, 88], [103, 85]])
start = np.array([[19, 14], [46, 55]])
kmeans = KMeans(n_clusters=2, init=start, n_init=1).fit(X)
print(kmeans.cluster_centers_)   # [[35.  37. ] [88.  86.5]]
print(kmeans.labels_)            # [0 0 0 1 1]
print(kmeans.inertia_)           # 1734.5
ترقم scikit-learn العناقيد بدءا من 0، لذا فعنقودها 0 هو μ1 عندنا.
افتح محاكي k-means بملء الشاشة لتعيد تشغيل هذا المثال خطوة بخطوة. اسحب أحد المراكز لتجرب بداية أخرى، أو ارفع قيمة k، أو انتقل إلى العملاء الـ200 كلهم أو إلى نقاطك الخاصة.
الجزء 2: الدفتر 1، الكتل وطريقة الكوع
افتح الدفتر
النتائج في هذه الصفحة من scikit-learn 1.9.1. وقد يشغل Colab إصدارا آخر، وعندها قد تختلف أرقام العناقيد، بل حتى العناقيد الناتجة من بداية واحدة، عما يظهر هنا.
توليد أربع كتل
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs

import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

sns.set()

points, cluster_indexes = make_blobs(n_samples=300, centers=4, cluster_std=0.8, random_state=0)

x = points[:, 0]
y = points[:, 1]

plt.scatter(x, y, s=50, alpha=0.7)
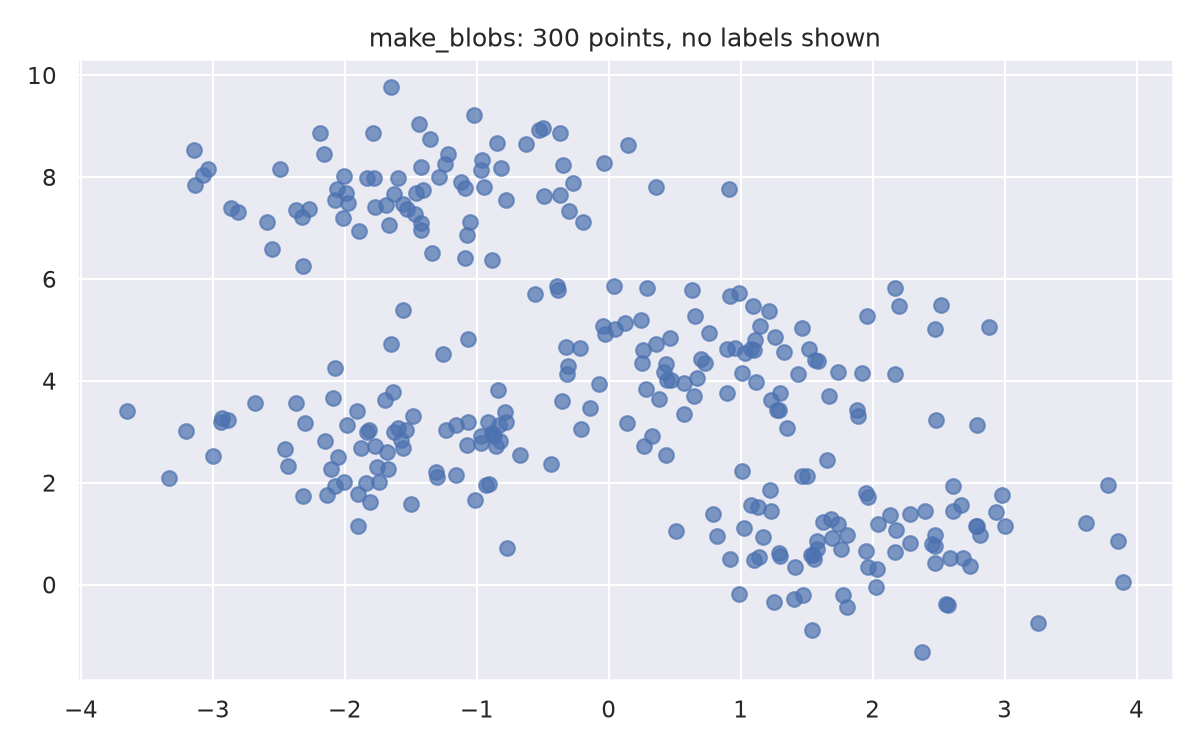
تولد make_blobs عدد 300 نقطة مجمعة تقريبا في أربعة عناقيد، في كل منها 75 نقطة. ويعرضها الرسم دون أي لون: فخوارزمية k-means لا ترى cluster_indexes أبدا.
تجربة ثلاث قيم للعدد k
kmeans = KMeans(n_clusters=4, random_state=0)
kmeans.fit(points)
predicted_cluster_indexes = kmeans.predict(points)

plt.scatter(x, y, c=predicted_cluster_indexes, s=50, alpha=0.7, cmap='viridis')

centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=100)
يشغل الدفتر هذه الخلية مع n_clusters بالقيم 3 و4 و5. والنقاط الحمراء هي المراكز.
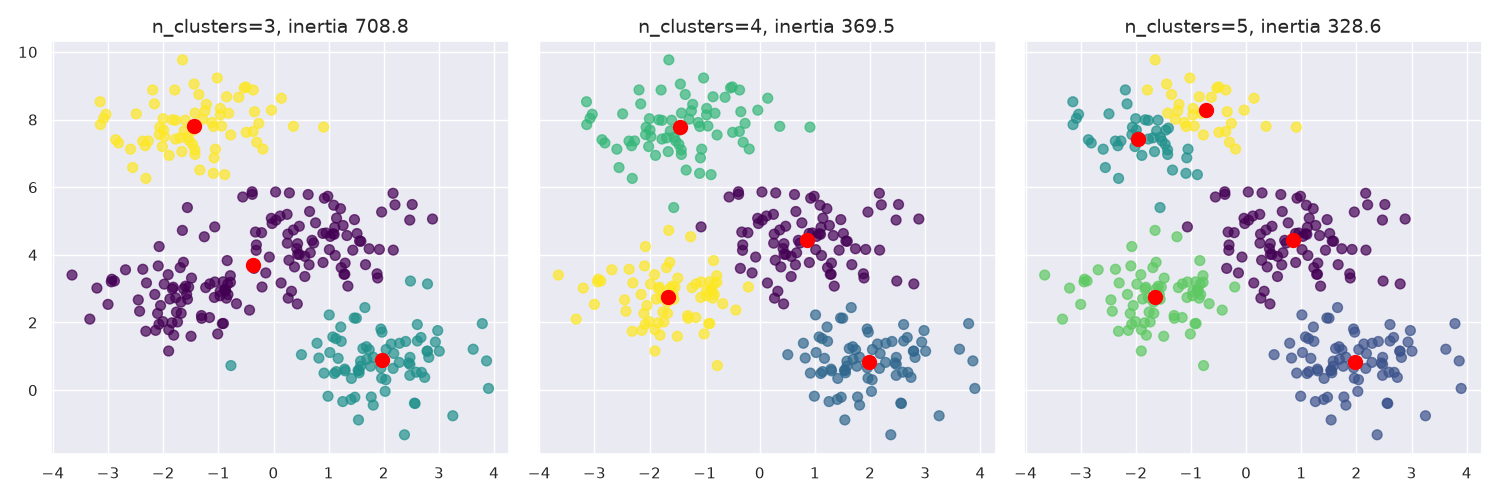
- k = 3 يدمج كتلتين في عنقود كبير واحد من 151 نقطة. القصور الذاتي 708.77.
- k = 4 يجد الكتل الأربع: 81 و74 و73 و72 نقطة. القصور الذاتي 369.53.
- k = 5 يقطع كتلة حقيقية واحدة إلى عنقودين من 42 و31 نقطة. القصور الذاتي 328.65.
تعيد k-means دائما k من العناقيد بالضبط كما تطلب، حتى حين يكون عدد المجموعات في البيانات مختلفا.
إلى أي عنقود تنتمي نقطة جديدة؟
يضيف الدفتر النقطة (-0.5, 5)، ويتنبأ بعنقودها باستخدام نموذج k = 4، ثم يطبع مسافتها إلى كل مركز من المراكز الأربعة:
point = np.array([[-0.5, 5]])
px = point[:, 0]
py = point[:, 1]

cluster = kmeans.predict(point)[0]
print(cluster)

d = []
for i in range(len(centers)):
    d.append(np.sqrt((px - centers[i][0])**2 + (py - centers[i][1])**2))

print(d)
0
[array([1.46570934]), array([4.8470332]), array([2.93542029]), array([2.52147763])]أصغر مسافة، 1.466، هي إلى المركز 0 عند (0.85, 4.44)، لذا تنضم النقطة إلى العنقود 0. وتؤدي predict خطوة الإسناد في الخوارزمية بالضبط.
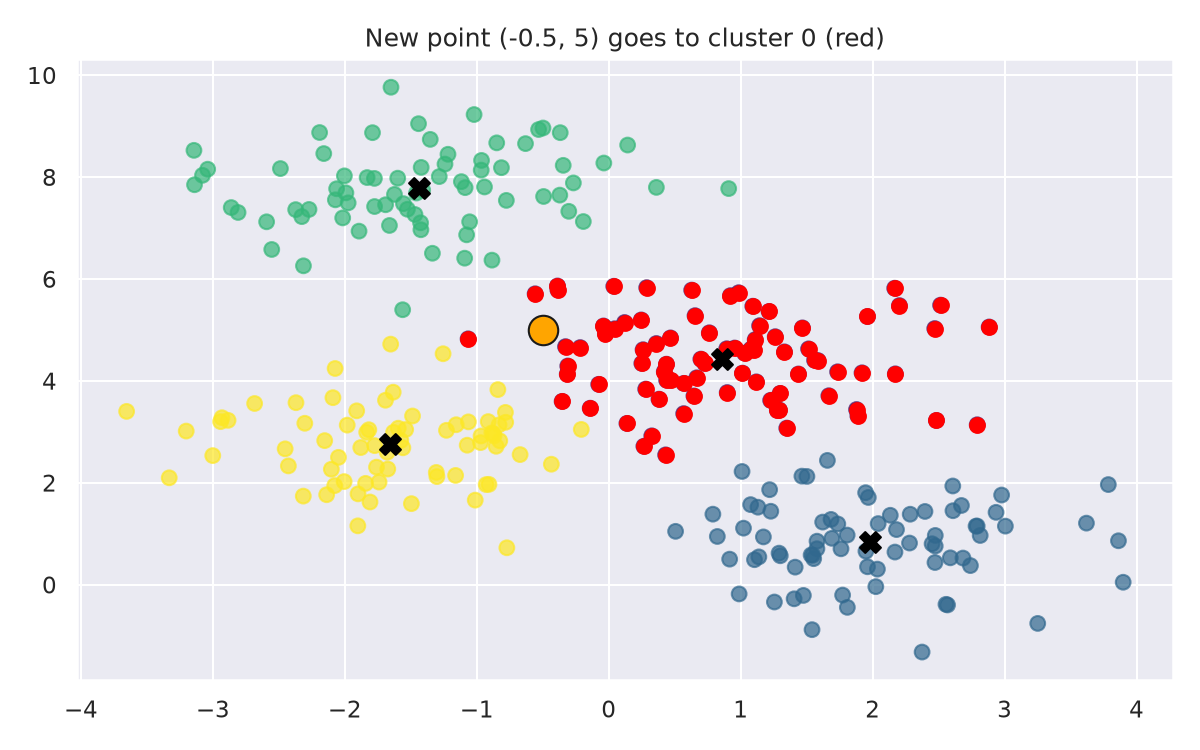
طبع الدفتر المحفوظ 1 للنقطة نفسها، مع المسافات الأربع نفسها بترتيب مختلف. فأرقام العناقيد مجرد أسماء: والمجموعة التي تسمى 0 تتوقف على التشغيل.
اختيار k: طريقة الكوع
inertias = []

for i in range(1, 10):
    kmeans = KMeans(n_clusters=i, random_state=0)
    kmeans.fit(points)
    inertias.append(kmeans.inertia_)

plt.plot(range(1, 10), inertias)
plt.xlabel('Number of Clusters')
plt.ylabel('Inertia')| k | القصور الذاتي | الانخفاض عن k - 1 |
|---|---|---|
| 1 | 2978.59 | |
| 2 | 1351.37 | 1627.22 |
| 3 | 708.77 | 642.60 |
| 4 | 369.53 | 339.24 |
| 5 | 328.65 | 40.88 |
| 6 | 298.52 | 30.13 |
| 7 | 267.07 | 31.45 |
| 8 | 232.65 | 34.42 |
| 9 | 211.99 | 20.66 |
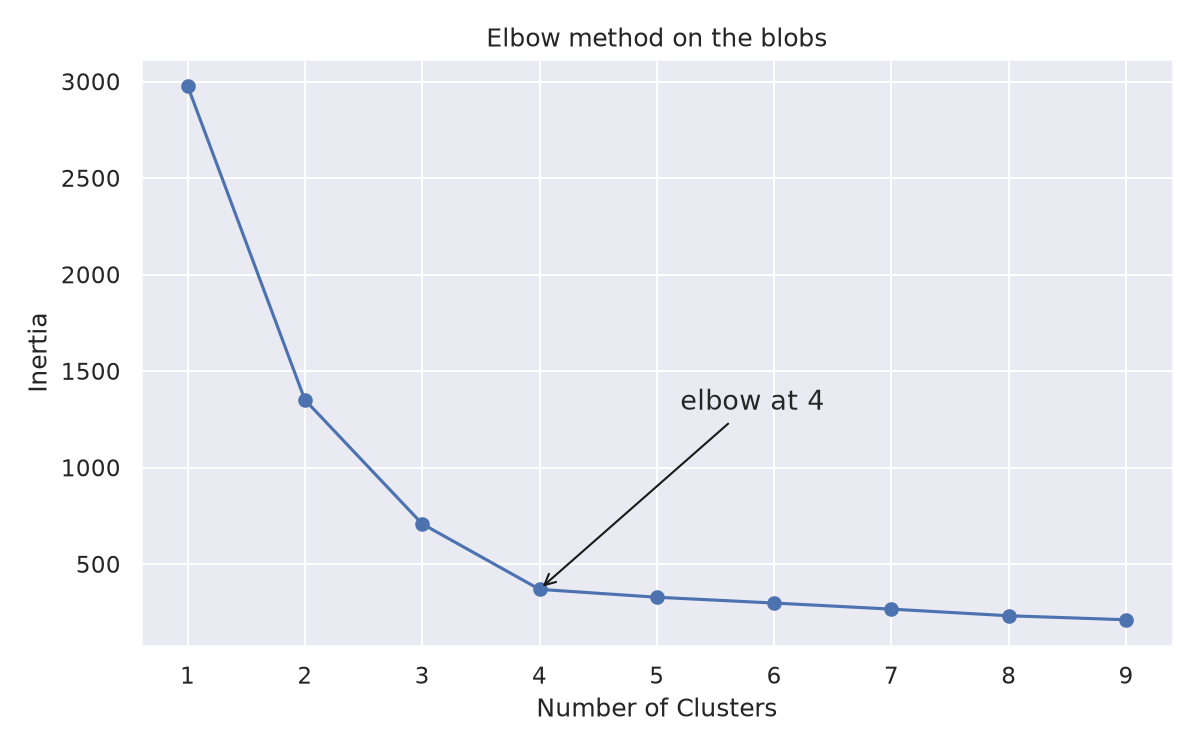
- ينخفض القصور الذاتي دائما مع زيادة k: فمع مراكز أكثر يمكن أن تكون كل نقطة أقرب إلى أحدها. ولو ساوى k عدد النقاط لكان القصور الذاتي 0.
- لذا لا تختر قيمة k صاحبة أصغر قصور ذاتي. اختر الكوع: قيمة k التي تصبح الانخفاضات بعدها صغيرة. هنا الانخفاض من 3 إلى 4 هو 339.24، والانخفاض من 4 إلى 5 هو 40.88 فقط، إذن k = 4، وهو عدد الكتل التي جرى توليدها.
افتح أداة طريقة الكوع بملء الشاشة لتعيد تشغيل الحلقة قيمة بعد قيمة للعدد k، وترى العناقيد خلف كل نقطة على المنحنى.
الجزء 3: تقسيم العملاء إلى شرائح
السيناريو
يريد مجمع تجاري إطلاق حملة لمنتج جديد، أو عرض ترويجي يجعل العملاء يشترون أكثر. ولا يمكنه إرسال العرض نفسه إلى الجميع، لذا يقسم عملاءه إلى شرائح من بياناتهم ويستهدف الشريحة المناسبة. ويستخدم الدفتر مجموعة بيانات لتقسيم العملاء من Kaggle فيها 200 عميل:
| العمود | المعنى |
|---|---|
CustomerID | رقم من 1 إلى 200 |
Gender | Male أو Female (88 و112 عميلا) |
Age | من 18 إلى 70 |
Annual Income (k$) | من 15 إلى 137 ألف دولار |
Spending Score (1-100) | من 1 إلى 99، درجة يعطيها المجمع التجاري للعميل حسب مقدار إنفاقه |
تحميل البيانات
يقرأ الدفتر الملف Data/customers.csv من مجلد غير موجود حين يفتح الدفتر في Colab. اقرأ الملف من المستودع بدلا من ذلك:
import pandas as pd

url = ("https://raw.githubusercontent.com/"
       "jeffprosise/Machine-Learning/master/Data/customers.csv")
customers = pd.read_csv(url)
customers.head()
CustomerID Gender Age Annual Income (k$) Spending Score (1-100)
0 1 Male 19 15 39
1 2 Male 21 15 81
2 3 Female 20 16 6
3 4 Female 23 16 77
4 5 Female 31 17 40قيمة customers.shape هي (200, 5)، ويعرض customers.info() عدد 200 قيمة غير فارغة (non-null) في كل عمود، فلا توجد قيم مفقودة.
خاصيتان: الدخل والإنفاق
points = customers.iloc[:, 3:5].values
x = points[:, 0]
y = points[:, 1]

plt.scatter(x, y, s=50, alpha=0.7)
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score')
يأخذ iloc[:, 3:5] العمودين 3 و4، أي الدخل ودرجة الإنفاق.
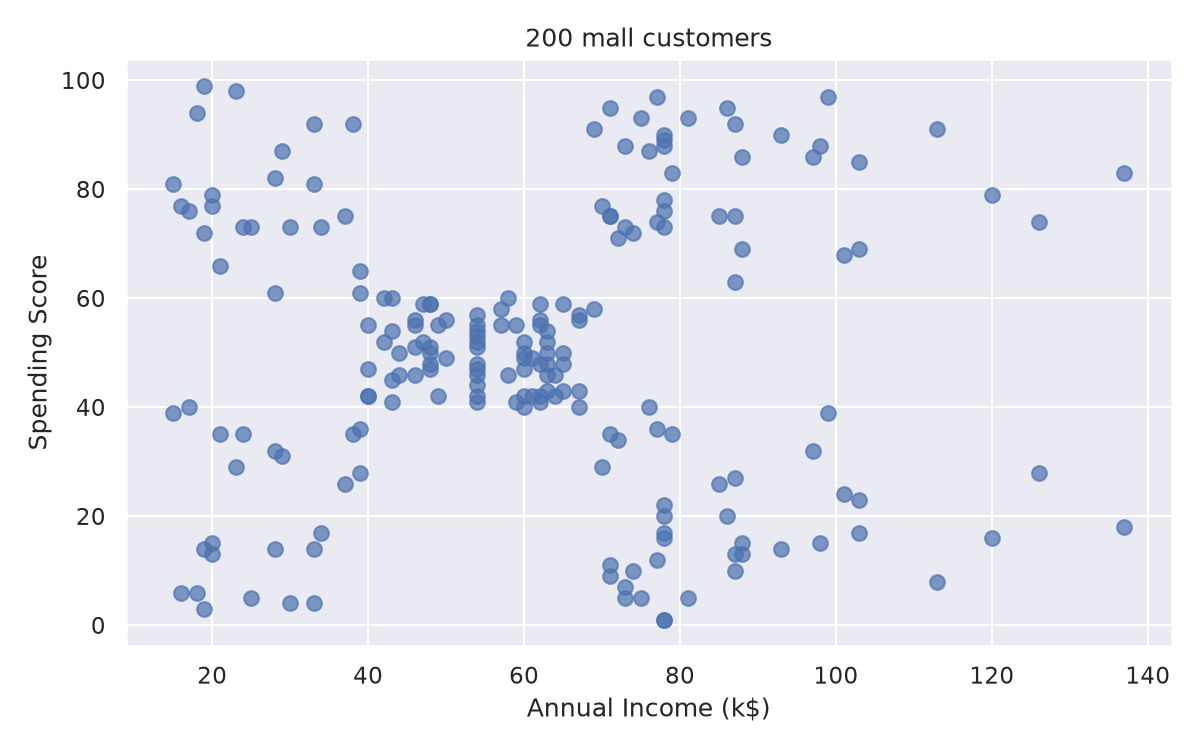
حتى بالعين المجردة ترى مجموعة كثيفة في الوسط وأربع مجموعات في الأركان.
الكوع على بيانات العملاء
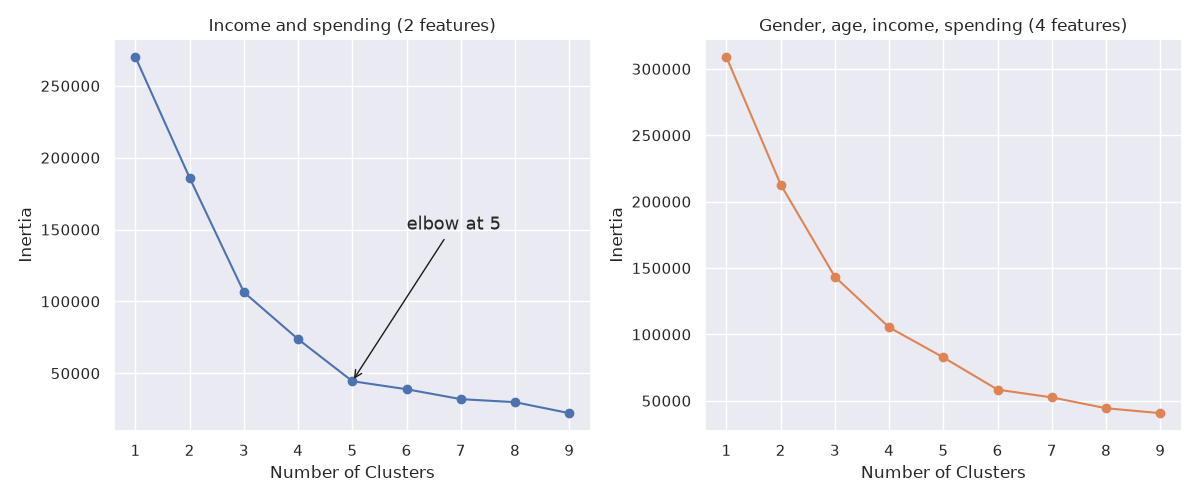
يشغل الدفتر حلقة الكوع نفسها على points:
| k | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| القصور الذاتي | 269981.28 | 185917.14 | 106348.37 | 73679.79 | 44448.46 | 38858.96 | 31969.43 | 29858.48 | 22209.85 |
الانخفاض من 4 إلى 5 هو 29231.33، والانخفاض من 5 إلى 6 هو 5589.50 فقط. فالكوع عند k = 5.
خمس شرائح
kmeans = KMeans(n_clusters=5, random_state=0)
kmeans.fit(points)
predicted_cluster_indexes = kmeans.predict(points)

plt.scatter(x, y, c=predicted_cluster_indexes, s=50, alpha=0.7, cmap='viridis')
plt.xlabel('Annual Income (k$)')
plt.ylabel('Spending Score')

centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='red', s=100)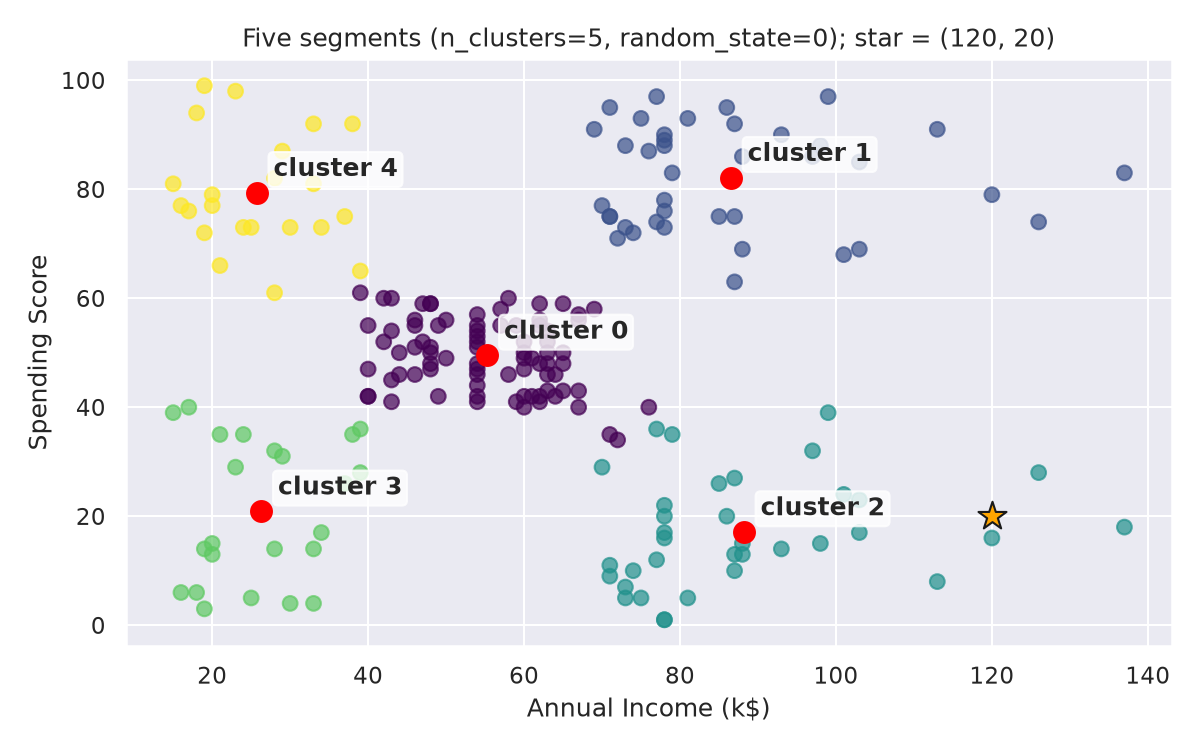
كل مركز هو العميل المتوسط في شريحته:
| العنقود | متوسط الدخل (ألف دولار) | متوسط الإنفاق | العملاء | اسم للشريحة |
|---|---|---|---|---|
| 0 | 55.30 | 49.52 | 81 | دخل متوسط، وإنفاق متوسط |
| 1 | 86.54 | 82.13 | 39 | دخل مرتفع، وإنفاق مرتفع |
| 2 | 88.20 | 17.11 | 35 | دخل مرتفع، وإنفاق منخفض |
| 3 | 26.30 | 20.91 | 23 | دخل منخفض، وإنفاق منخفض |
| 4 | 25.73 | 79.36 | 22 | دخل منخفض، وإنفاق مرتفع |
الأسماء من وضعنا. فخوارزمية k-means تعيد أعدادا فقط، والإنسان هو من يقرأ المراكز ويقرر معنى كل شريحة.
أي العملاء نستهدف؟
يجب أن يصل العرض الترويجي الذي يزيد النشاط الشرائي إلى العملاء القادرين على إنفاق المزيد لكنهم لا يفعلون: دخل مرتفع، وإنفاق منخفض. ويجد الدفتر عنقودهم بالتنبؤ بعنقود عميل مفترض دخله 120 ودرجة إنفاقه 20، ثم يسرد كل عملاء ذلك العنقود:
df = customers.copy()
df['Cluster'] = kmeans.predict(points)

cluster = kmeans.predict(np.array([[120, 20]]))[0]
clustered_df = df[df['Cluster'] == cluster]
clustered_df['CustomerID'].values
array([125, 129, 131, 135, 137, 139, 141, 145, 147, 149, 151, 153, 155,
157, 159, 161, 163, 165, 167, 169, 171, 173, 175, 177, 179, 181,
183, 185, 187, 189, 191, 193, 195, 197, 199])يقع العميل المفترض في العنقود 2، وتضم قائمة الحملة عملاء هذا العنقود، وعددهم 35 عميلا. أما في برنامج ولاء (loyalty program) يكافئ العملاء الذين يشترون كثيرا بالفعل، فستختار الشرائح كثيرة الإنفاق بدلا من ذلك: العنقود 1، وربما العنقود 4.
التقسيم على كل الخصائص
ثم يجمع الدفتر العملاء حسب الجنس والعمر والدخل والإنفاق. تحتاج KMeans إلى أعداد، لذا يحول الدفتر أولا النصين Female وMale إلى القيمتين 0 و1، ويسمى ذلك ترميز التسميات (label encoding):
from sklearn.preprocessing import LabelEncoder

df = customers.copy()
encoder = LabelEncoder()
df['Gender'] = encoder.fit_transform(df['Gender'])
points = df.iloc[:, 1:5].values
قيمة encoder.classes_ هي ['Female' 'Male']، لذا تصبح Female القيمة 0 وMale القيمة 1. ويأخذ iloc[:, 1:5] الأعمدة الأربعة من Gender إلى درجة الإنفاق، ويستبعد CustomerID، فهو مجرد رقم صف.
تعطي حلقة الكوع:
| k | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| القصور الذاتي | 308862.06 | 212889.44 | 143391.59 | 105299.99 | 82657.05 | 58387.21 | 52544.81 | 44389.81 | 40670.99 |
الكوع أقل وضوحا هذه المرة. ويبقي الدفتر خمسة عناقيد ويعرض تقريرا عن كل منها:
kmeans = KMeans(n_clusters=5, random_state=0)
kmeans.fit(points)
df['Cluster'] = kmeans.predict(points)

results = pd.DataFrame(columns = ['Cluster', 'Average Age', 'Average Income', 'Average Spending Index', 'Number of Females', 'Number of Males'])

for i in range(len(kmeans.cluster_centers_)):
    age = df[df['Cluster'] == i]['Age'].mean()
    income = df[df['Cluster'] == i]['Annual Income (k$)'].mean()
    spend = df[df['Cluster'] == i]['Spending Score (1-100)'].mean()

    gdf = df[df['Cluster'] == i]
    females = gdf[gdf['Gender'] == 0].shape[0]
    males = gdf[gdf['Gender'] == 1].shape[0]

    results.loc[i] = ([i, age, income, spend, females, males])

results.head()| العنقود | متوسط العمر | متوسط الدخل | متوسط الإنفاق | الإناث | الذكور |
|---|---|---|---|---|---|
| 0 | 54.06 | 40.46 | 36.72 | 28 | 22 |
| 1 | 32.69 | 86.54 | 82.13 | 21 | 18 |
| 2 | 25.25 | 25.83 | 76.92 | 14 | 10 |
| 3 | 41.65 | 88.74 | 16.76 | 15 | 19 |
| 4 | 33.40 | 58.06 | 48.77 | 34 | 19 |
شريحة الدخل المرتفع والإنفاق المنخفض هنا هي العنقود 3: فيها 34 عميلا، ومتوسط أعمارهم 41.65، ومنهم 15 امرأة و19 رجلا. ويسأل الدفتر هل يهم أن نستهدف الرجال أم النساء: هذه الشريحة تضم الجنسين بأعداد متقاربة، لذا فالدخل والإنفاق هما ما يحدد الهدف في هذا العرض الترويجي، لا الجنس.
بداية مختلفة، نتيجة مختلفة
يعرض الدفتر المحفوظ جدولا مختلفا للخلية نفسها: متوسطات الأعمار 45.22 و32.69 و43.09 و40.67 و25.52. والسبب هو البداية.
- تضع
KMeansمراكز البداية بطريقة عشوائية (init='k-means++') يتحكم فيهاrandom_state. n_initهو عدد مرات تشغيل الخوارزمية كاملة من بدايات مختلفة، ويحتفظ النموذج بالتشغيل صاحب أصغر قصور ذاتي.- منذ scikit-learn 1.4 أصبحت القيمة الافتراضية
n_init='auto'، وهي تعني معk-means++تشغيلا واحدا.
شغل الخلية نفسها مع n_init=10:
kmeans = KMeans(n_clusters=5, random_state=0, n_init=10)
kmeans.fit(points)
print(kmeans.inertia_)| الإعداد | القصور الذاتي | أحجام العناقيد |
|---|---|---|
n_init بقيمته الافتراضية (تشغيل واحد) | 82657.05 | 50, 39, 24, 34, 53 |
n_init=10 | 75399.62 | 23, 39, 79, 23, 36 |
نتيجة التشغيل الواحد حل أمثل محلي: فالتشغيل الآخر يصل إلى قيمة WCSS أصغر، هي 75399.62، بخمسة عناقيد أيضا وعلى البيانات نفسها. ويجد التشغيل مع n_init=10 تجميع الدفتر المحفوظ (متوسطات الأعمار 45.22 و32.69 و43.09 و25.52 و40.67). وضبط n_init على 10 أو أكثر يكلف وقتا قليلا ويحميك من بداية سيئة الحظ، ويستخدم الدفتر 2 القيمة n_init=20.
في أداة المحاكي، اختر العملاء: 200 واضغط بداية جديدة عدة مرات: بعض البدايات تنتهي عند WCSS قيمتها 44448.46 لخمسة عناقيد، وبعضها يعلق عند قيمة أعلى.
الجزء 4: الدفتر 2، الكليات
افتح الدفتر
افتح K_Means_Clustering_Practice في Colab
البيانات
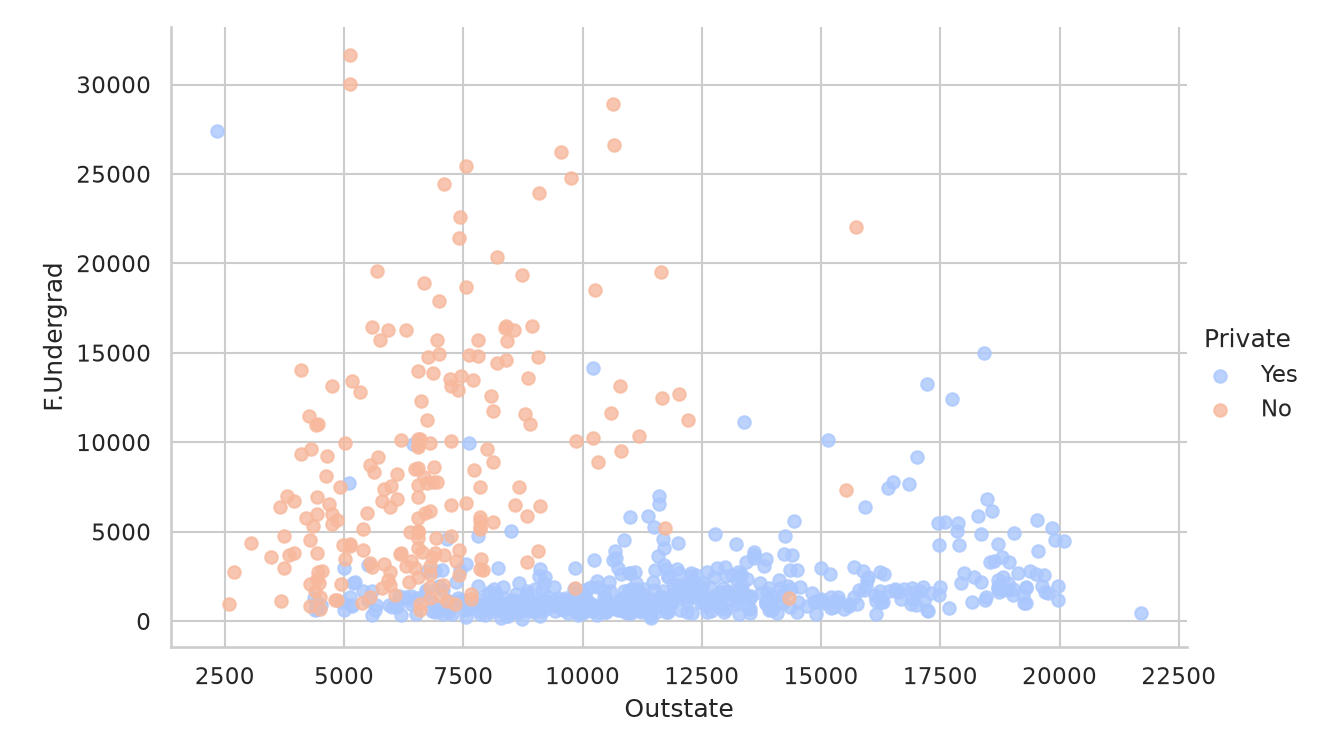
تصف College_Data عدد 777 كلية أمريكية من خلال 18 متغيرا: Private (Yes أو No)، و17 عددا مثل Apps (الطلبات المستلمة)، وF.Undergrad (طلاب المرحلة الجامعية بدوام كامل)، وOutstate (رسوم الطلاب من خارج الولاية)، وExpend (الإنفاق التعليمي لكل طالب). ومنها 565 كلية خاصة و212 كلية حكومية.
المهمة: تجميع الكليات في عنقودين باستخدام الأعداد الـ17 وحدها، ثم التحقق هل يطابق العنقودان التقسيم إلى خاصة وحكومية. في عمل التجميع الحقيقي لن تكون لديك التسميات، أما هنا فهي تتيح لنا تقييم النتيجة.
ثلاث خلايا تحتاج إلى إصلاح
| الخلية | المشكلة | الإصلاح |
|---|---|---|
pd.read_csv('College_Data', index_col=0) | الملف ليس بجوار الدفتر في Colab | اقرأه من المجلد Datasets في المستودع (أدناه) |
df['Grad.Rate']['Cazenovia College'] = 100 | تعيين متسلسل (chained assignment)؛ ومع pandas 3 يطبع تحذير ChainedAssignmentError وتبقى القيمة 118 | df.loc['Cazenovia College', 'Grad.Rate'] = 100 |
sns.lmplot('Room.Board','Grad.Rate', ..., size=6) وsns.FacetGrid(..., size=6) | تحتاج seaborn الحالية إلى x= وy= بالاسم، وتسمي size باسم height | sns.lmplot(x='Room.Board', y='Grad.Rate', data=df, hue='Private', palette='coolwarm', height=6, aspect=1, fit_reg=True) |
url = ("https://raw.githubusercontent.com/"
       "tirthajyoti/Machine-Learning-with-Python/"
       "master/Datasets/College_Data")
df = pd.read_csv(url, index_col=0)
df.loc['Cazenovia College', 'Grad.Rate'] = 100
تذكر Cazenovia College معدل تخرج قدره 118، وهذا مستحيل، لذا يضبطه الدفتر على 100.
تدريب نموذج بعنقودين
from sklearn.cluster import KMeans

kmeans = KMeans(n_clusters=2, verbose=0, tol=1e-3, max_iter=300, n_init=20, random_state=0)
kmeans.fit(df.drop('Private', axis=1))
أضفنا random_state=0 ليكون التشغيل قابلا للتكرار. ويشغل n_init=20 الخوارزمية من 20 بداية ويحتفظ بالأفضل، ويتحكم tol وmax_iter في موعد توقف التشغيل. وقد جربنا random_state من 0 إلى 9، فانتهى كل تشغيل إلى العنقودين نفسيهما بالقصور الذاتي نفسه: 669 كلية في عنقود و108 كليات في الآخر. ومع random_state=0 تكون الكليات الـ669 هي العنقود 0.
أربعة من إحداثيات المركز الـ17، من kmeans.cluster_centers_:
| الخاصية | العنقود 0 (669 كلية) | العنقود 1 (108 كليات) |
|---|---|---|
Apps | 1813.2 | 10363.1 |
F.Undergrad | 2188.5 | 13061.9 |
Outstate | 10395.7 | 10719.2 |
Expend | 8932.0 | 14170.5 |
يضم العنقود 1 الكليات الكبيرة: طلبات كثيرة، وطلاب كثيرون، وإنفاق مرتفع لكل طالب. ويضم العنقود 0 الكليات الصغيرة.
مقارنة العناقيد بالتسميات
يحول الدفتر Private إلى عمود قيمه 0 أو 1 (القيمة 1 للكلية الخاصة)، ويقارنه بـkmeans.labels_:
from sklearn.metrics import confusion_matrix, classification_report

def converter(cluster):
    if cluster == 'Yes':
        return 1
    else:
        return 0

df['Cluster'] = df['Private'].apply(converter)
print(confusion_matrix(df['Cluster'], kmeans.labels_))
[[138 74]
[531 34]]الصفوف هي التسمية الحقيقية (0 حكومية، 1 خاصة)، والأعمدة هي العنقود. تحمل الخلايا "الصحيحة" 138 + 34، لذا فالدقة (accuracy) هي 172 / 777 = 0.2214. يبدو هذا سيئا جدا، لكنها مشكلة في الأسماء: فقد سمت k-means الكليات الصغيرة العنقود 0، بينما تعطي التسمية الكليات الخاصة القيمة 1. ومعظم الكليات الخاصة (531 من 565) في العنقود 0.
بدل رقمي العنقودين باستخدام 1 - kmeans.labels_:
print(confusion_matrix(df['Cluster'], 1 - kmeans.labels_))
print(classification_report(df['Cluster'], 1 - kmeans.labels_))
[[ 74 138]
[ 34 531]]
precision recall f1-score support
0 0.69 0.35 0.46 212
1 0.79 0.94 0.86 565
accuracy 0.78 777
macro avg 0.74 0.64 0.66 777
weighted avg 0.76 0.78 0.75 777هذه هي المصفوفة المحفوظة في الدفتر، إذ جاء ترقيم العنقودين في تشغيله بالترتيب المعاكس.
- الدقة:
(74 + 531) / 777 = 605 / 777 = 0.7786. - الكليات الخاصة: الضبط (precision)
531 / (531 + 138) = 0.7937، والاستدعاء (recall)531 / 565 = 0.9398. - الكليات الحكومية: الضبط
74 / (74 + 34) = 0.6852، والاستدعاء74 / 212 = 0.3491.
وجدت k-means الحجم، لا نوع الملكية: فالعنقود "الكبير" ذو الكليات الـ108 يضم 74 كلية حكومية و34 كلية خاصة، و138 كلية حكومية صغيرة بما يكفي لتقع مع الكليات الخاصة. والخصائص ذات الأعداد الأكبر (Expend وF.Undergrad وOutstate وApps) تهيمن على المسافة.
نسخة ليست نسخة
قبل خليته الأخيرة يكتب الدفتر df1 = df ثم يضيف العمود Cluster إلى df1. هذا السطر لا ينسخ شيئا: فـdf1 وdf هما إطار البيانات (DataFrame) نفسه، لذا أصبح df يحتوي على التسميات الحقيقية أيضا. وتدرب الخلية الأخيرة KMeans مرة أخرى على df.drop('Private', axis=1)، الذي يتضمن الآن Cluster، فيحصل النموذج على الإجابة خفية. استخدم df1 = df.copy() حين تحتاج إلى نسخة حقيقية.
الأخطاء الشائعة
- اعتبار أرقام العناقيد ذات معنى. فالعنقود 0 في تشغيل قد يكون العنقود 3 في تشغيل آخر؛ اقرأ المراكز.
- اختيار قيمة k صاحبة أصغر قصور ذاتي. فالقصور الذاتي ينخفض دائما مع زيادة k؛ ابحث عن الكوع.
- الثقة ببداية واحدة. استخدم
n_init=10أو أكثر، وثبتrandom_stateحين تحتاج إلى النتيجة نفسها مرة أخرى. - التجميع على عمود معرف (ID). فالعمود
CustomerIDرقم صف، وليس صفة من صفات العميل. - تمرير أعمدة نصية إلى
KMeans. رمزها أولا، مثلا باستخدامLabelEncoder. - تقييم العناقيد مقابل التسميات دون مطابقة أرقام العناقيد بالتسميات أولا.
- كتابة
df1 = dfوأنت تقصدdf1 = df.copy().
مرحلة المشروع: العروض والمناقشات
مرحلة هذا الأسبوع هي عروض فرق المشاريع ومناقشاتها. يعرض كل فريق مشروعه ويجيب عن الأسئلة. جهز ما يلي:
- المشكلة التي يحلها مشروعك، ومجموعة البيانات التي تستخدمها: الصفوف، والخصائص، والهدف.
- كيف نظفت البيانات واستكشفتها، مع رسم أو رسمين.
- النماذج التي بنيتها منذ الأسبوع 3، ونتائجها على مجموعة الاختبار نفسها.
- النموذج الذي تحتفظ به، وسبب اختياره.
- ما لا يزال ناقصا، وخطتك لإكماله.
إن لم تكن في بياناتك تسميات، أو أردت أن تجد مجموعات فيها، فجرب k-means عليها، واعرض منحنى الكوع ومراكز عناقيدك.
الخلاصة
- يجد التجميع مجموعات في بيانات لا تسميات لها.
- تكرر k-means خطوتين: إسناد كل نقطة إلى أقرب مركز إليها، ثم تحديث كل مركز إلى متوسط نقاطه، حتى لا يتغير شيء.
- يقيس WCSS (
inertia_) مدى تماسك العناقيد، ولا تستطيع أي من الخطوتين زيادته. - اختر k بطريقة الكوع، لا بأصغر قصور ذاتي.
- تعتمد النتيجة على البداية: استخدم
n_initلتجربة عدة بدايات. - أرقام العناقيد اعتباطية؛ والإنسان هو من يقرأ المراكز ويسمي الشرائح.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: بداية مختلفة (نحو 10 دقائق)
استخدم العملاء الخمسة أنفسهم في المثال المحلول، مع k = 2، لكن ابدأ المركزين عند μ1 = #11 = (19, 14) وμ2 = #136 = (73, 88).
- نفذ خطوة الإسناد وخطوة التحديث حتى لا يغير أي عميل عنقوده.
- اكتب العنقودين النهائيين، والمركزين النهائيين، وقيمة J النهائية.
- كم خطوة إسناد احتجت إليها، مقارنة بالمثال المحلول؟
التمرين 2: أي شريحة؟ (نحو 5 دقائق)
مراكز شرائح العملاء الخمس في الجزء 3 هي (مقربة إلى منزلة عشرية واحدة):
| العنقود | المركز (الدخل، الإنفاق) |
|---|---|
| 0 | (55.3, 49.5) |
| 1 | (86.5, 82.1) |
| 2 | (88.2, 17.1) |
| 3 | (26.3, 20.9) |
| 4 | (25.7, 79.4) |
عميل جديد دخله 100 ودرجة إنفاقه 50. احسب مربع المسافة إلى كل مركز. إلى أي شريحة ينضم العميل؟ وهل الفارق ضئيل؟
التمرين 3: تقييم عناقيد الكليات (نحو 5 دقائق)
بعد تبديل رقمي العنقودين، تعطي الكليات مصفوفة الالتباس (confusion matrix) هذه (الصفوف: التسمية الحقيقية، والأعمدة: العنقود):
| العنقود 0 | العنقود 1 | |
|---|---|---|
| حكومية (0) | 74 | 138 |
| خاصة (1) | 34 | 531 |
احسب الدقة، والضبط والاستدعاء لصنف الكليات الخاصة.
التمرين 4: في Colab (نحو 10 دقائق)
- شغل الدفتر 1 حتى الشرائح الخمس على الدخل والإنفاق. تنبأ بشريحة العميلين
[[100, 50], [20, 90]]باستدعاء واحد للدالةkmeans.predict. - أعد تشغيل نموذج الخصائص الأربع مع
n_init=10. اطبعkmeans.inertia_وحجم كل عنقود باستخدامnp.bincount(kmeans.labels_). - في الدفتر 2، درب نموذج العنقودين مع
random_state=2بدلا من 0. اطبع مصفوفة الالتباس والدقة باستخدامaccuracy_scoreمنsklearn.metrics.
الإجابات
الإجابة 1
التكرار 1، الإسناد:
| العميل | d² إلى μ1 (19, 14) | d² إلى μ2 (73, 88) | ينضم إلى |
|---|---|---|---|
| #11 | 0 | 2916 + 5476 = 8392 | μ1 |
| #49 | 441 + 784 = 1225 | 1089 + 2116 = 3205 | μ1 |
| #62 | 729 + 1681 = 2410 | 729 + 1089 = 1818 | μ2 |
| #136 | 8392 | 0 | μ2 |
| #190 | 7056 + 5041 = 12097 | 900 + 9 = 909 | μ2 |
قيمة J بعد هذه الخطوة: 0 + 1225 + 1818 + 0 + 909 = 3952.
التكرار 1، التحديث: μ1 = متوسط #11 و#49 = (29.5, 28)، وμ2 = متوسط #62 و#136 و#190 = (74, 76).
هذان هما بالضبط مركزا التكرار 3 في المثال المحلول، لذا فالباقي هو نفسه:
- التكرار 2، الإسناد: ينتقل #62 إلى μ1 (1001.25 مقابل 1225)، وJ = 2680.75.
- التكرار 2، التحديث: μ1 = (35, 37)، وμ2 = (88, 86.5)، وJ = 1734.5.
- التكرار 3، الإسناد: لا ينتقل أي عميل. اكتمل التقارب.
العنقودان النهائيان هما (#11, #49, #62) و(#136, #190)، مع J = 1734.5، وهي النتيجة نفسها في المثال المحلول. واحتاجت هذه البداية إلى 3 خطوات إسناد بدلا من 4، لأنها بدأت أقرب إلى الإجابة. ومع خمس نقاط فقط، ينتهي كل زوج من العملاء نبدأ منه إلى هذه النتيجة نفسها، أما على بيانات أكبر، كما أظهر الجزء 3، فقد تنتهي البدايات المختلفة إلى نتائج مختلفة.
الإجابة 2
| العنقود | الفروق | مربع المسافة |
|---|---|---|
| 0 | 44.7, 0.5 | 1998.09 + 0.25 = 1998.34 |
| 1 | 13.5, -32.1 | 182.25 + 1030.41 = 1212.66 |
| 2 | 11.8, 32.9 | 139.24 + 1082.41 = 1221.65 |
| 3 | 73.7, 29.1 | 5431.69 + 846.81 = 6278.50 |
| 4 | 74.3, -29.4 | 5520.49 + 864.36 = 6384.85 |
ينضم العميل إلى العنقود 1 (دخل مرتفع، وإنفاق مرتفع)، لكن بفارق ضئيل: قيمة العنقود 2 هي 1221.65، أي أكبر بأقل من 9. ومع المراكز غير المقربة تكون القيمتان 1213.43 و1220.71، وتعيد kmeans.predict([[100, 50]]) العنقود 1 أيضا. والعميل الواقع على الحد بين شريحتين تذكير بأن الشرائح تبسيط للواقع.
الإجابة 3
- الدقة:
(74 + 531) / 777 = 605 / 777 = 0.7786. - الضبط لصنف الكليات الخاصة:
531 / (531 + 138) = 531 / 669 = 0.7937. - الاستدعاء لصنف الكليات الخاصة:
531 / (531 + 34) = 531 / 565 = 0.9398.
يجد النموذج 94 في المئة من الكليات الخاصة، لكن 138 كلية حكومية تقع في العنقود نفسه.
الإجابة 4
- تعيد
kmeans.predict(np.array([[100, 50], [20, 90]]))القيمة[1 4]: ينضم العميل الأول إلى شريحة الدخل المرتفع والإنفاق المرتفع (كما في الإجابة 2)، وينضم الثاني إلى شريحة الدخل المنخفض والإنفاق المرتفع. - مع
n_init=10: قيمةkmeans.inertia_هي نحو75399.6154(أي 75399.62 بعد التقريب، وقد تختلف آخر أرقام القيمة المطبوعة من جهاز إلى آخر)، وقيمةnp.bincount(kmeans.labels_)هي[23 39 79 23 36]. - مع
random_state=2، يخرج العنقودان نفساهما بالترقيم الآخر:
[[ 74 138]
 [ 34 531]]
0.7786357786357786
تقفز الدقة من 0.2214 إلى 0.7786 فقط لأن اسمي العنقودين تغيرا. لم يتغير شيء في التجميع نفسه: فالقصور الذاتي هو نفسه في التشغيلين.