

جارٍ تحميل الدرس...
في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 8
تجميع عملاء لا تحمل بياناتهم أي تسمية: إسناد، ثم تحديث، ثم تكرار. ثم تقسيم 200 عميل إلى شرائح من أجل حملة.
inertia_KMeans، وقراءة cluster_centers_ وlabels_، واختيار k بطريقة الكوع (elbow method)n_initالأسبوع 8 من الخطة
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | التجميع وخوارزمية k-means، ثم خمسة عملاء يدويا | 40 دقيقة |
| 2 | الدفتر 1: الكتل (blobs) وطريقة الكوع | 15 دقيقة |
| 3 | الدفتر 1: تقسيم العملاء إلى شرائح | 20 دقيقة |
| 4 | الدفتر 2: الكليات، ومرحلة المشروع | 15 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1
إيجاد مجموعات من الصفوف المتشابهة، دون تسميات نتعلم منها
| التعلم الموجه (الأسابيع من 3 إلى 7) | التجميع (هذا الأسبوع) | |
|---|---|---|
| بيانات التدريب | الخصائص (features) X وتسمية (label) y | الخصائص X فقط |
| ما يتعلمه النموذج | كيف يتنبأ بقيمة y | مجموعات من الصفوف المتشابهة |
| مثال | تتنبأ KNN بنوع زهرة iris | تجد k-means شرائح العملاء |
| التحقق من النتيجة | المقارنة بقيمة y الحقيقية | لا توجد إجابة صحيحة في العادة |
نقطة (x, y)، ومركز (a, b)، وعنقود فيه n من النقاط
يدويا
خمسة عملاء حقيقيون من الدفتر 1: الدخل السنوي (ألف دولار) ودرجة الإنفاق (من 1 إلى 100)
| العميل | الدخل (ألف دولار) | درجة الإنفاق |
|---|---|---|
| #11 | 19 | 14 |
| #49 | 40 | 42 |
| #62 | 46 | 55 |
| #136 | 73 | 88 |
| #190 | 103 | 85 |
μ1 = (19, 14)، وμ2 = (46, 55)؛ والفرق = العميل ناقص المركز
| العميل | d² إلى μ1 | d² إلى μ2 | ينضم إلى |
|---|---|---|---|
| #11 | 0 + 0 = 0 | 729 + 1681 = 2410 | μ1 |
| #49 | 441 + 784 = 1225 | 36 + 169 = 205 | μ2 |
| #62 | 729 + 1681 = 2410 | 0 + 0 = 0 | μ2 |
| #136 | 2916 + 5476 = 8392 | 729 + 1089 = 1818 | μ2 |
| #190 | 7056 + 5041 = 12097 | 3249 + 900 = 4149 | μ2 |
العنقود 1: #11. العنقود 2: #49، #62، #136، #190
μ1 = (19, 14)، وμ2 = (65.5, 67.5)
| العميل | d² إلى μ1 | d² إلى μ2 | ينضم إلى |
|---|---|---|---|
| #11 | 0 + 0 = 0 | 2162.25 + 2862.25 = 5024.5 | μ1 |
| #49 | 441 + 784 = 1225 | 650.25 + 650.25 = 1300.5 | μ1 |
| #62 | 729 + 1681 = 2410 | 380.25 + 156.25 = 536.5 | μ2 |
| #136 | 2916 + 5476 = 8392 | 56.25 + 420.25 = 476.5 | μ2 |
| #190 | 7056 + 5041 = 12097 | 1406.25 + 306.25 = 1712.5 | μ2 |
العنقود 1: #11، #49. العنقود 2: #62، #136، #190
μ1 = (29.5, 28)، وμ2 = (74, 76)
| العميل | d² إلى μ1 | d² إلى μ2 | ينضم إلى |
|---|---|---|---|
| #11 | 110.25 + 196 = 306.25 | 3025 + 3844 = 6869 | μ1 |
| #49 | 110.25 + 196 = 306.25 | 1156 + 1156 = 2312 | μ1 |
| #62 | 272.25 + 729 = 1001.25 | 784 + 441 = 1225 | μ1 |
| #136 | 1892.25 + 3600 = 5492.25 | 1 + 144 = 145 | μ2 |
| #190 | 5402.25 + 3249 = 8651.25 | 841 + 81 = 922 | μ2 |
العنقود 1: #11، #49، #62. العنقود 2: #136، #190
μ1 = (35, 37)، وμ2 = (88, 86.5)
| العميل | d² إلى μ1 | d² إلى μ2 | ينضم إلى |
|---|---|---|---|
| #11 | 256 + 529 = 785 | 4761 + 5256.25 = 10017.25 | μ1 |
| #49 | 25 + 25 = 50 | 2304 + 1980.25 = 4284.25 | μ1 |
| #62 | 121 + 324 = 445 | 1764 + 992.25 = 2756.25 | μ1 |
| #136 | 1444 + 2601 = 4045 | 225 + 2.25 = 227.25 | μ2 |
| #190 | 4624 + 2304 = 6928 | 225 + 2.25 = 227.25 | μ2 |
N من النقاط، وd_i = المسافة من النقطة i إلى مركزها الذي تنتمي إليه
| التكرار | J بعد الإسناد | J بعد التحديث |
|---|---|---|
| 1 | 6172 | 4026 |
| 2 | 3950.5 | 2904.5 |
| 3 | 2680.75 | 1734.5 |
| 4 | 1734.5 | اكتمل التقارب |
الجزء 2
نقاط مولدة أولا، لنعرف الإجابة الصحيحة
https://colab.research.google.com/github/
jeffprosise/Machine-Learning/blob/master/
Clustering.ipynbhttps://colab.research.google.com/github/
tirthajyoti/Machine-Learning-with-Python/blob/master/
Clustering-Dimensionality-Reduction/
K_Means_Clustering_Practice.ipynbmake_blobs(n_samples=300, centers=4, cluster_std=0.8, random_state=0)، ثم KMeans(n_clusters=k, random_state=0)
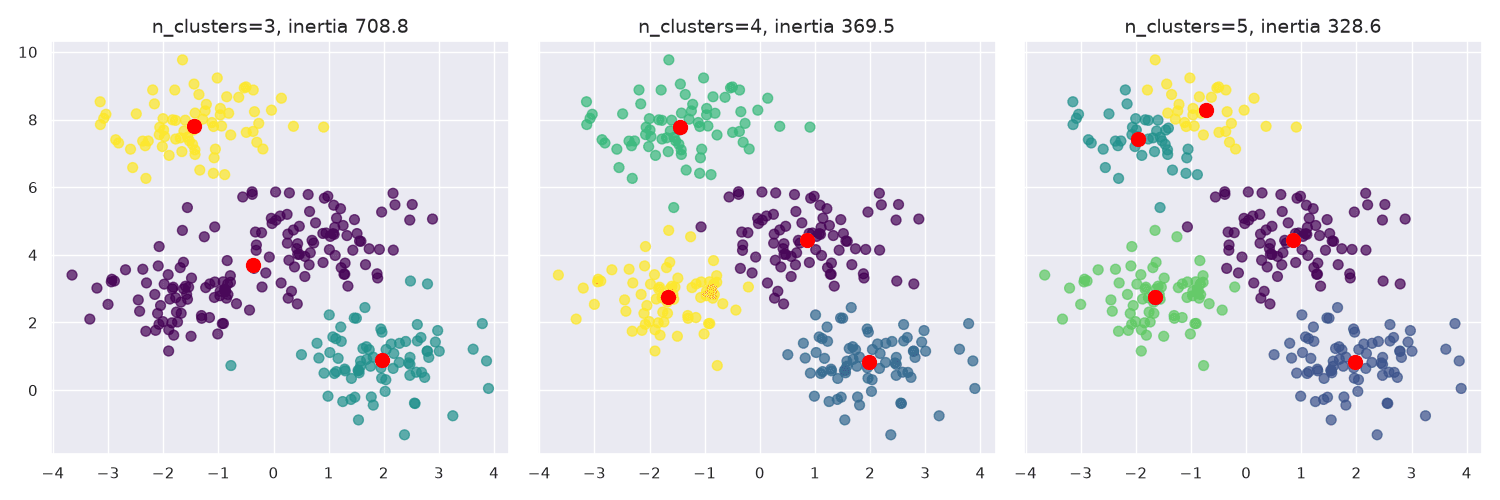
يتنبأ نموذج k = 4 بعنقود (-0.5, 5) باستخدام kmeans.predict(point)، ثم يطبع المسافة إلى كل مركز
[array([1.46570934]), array([4.8470332]),
 array([2.93542029]), array([2.52147763])]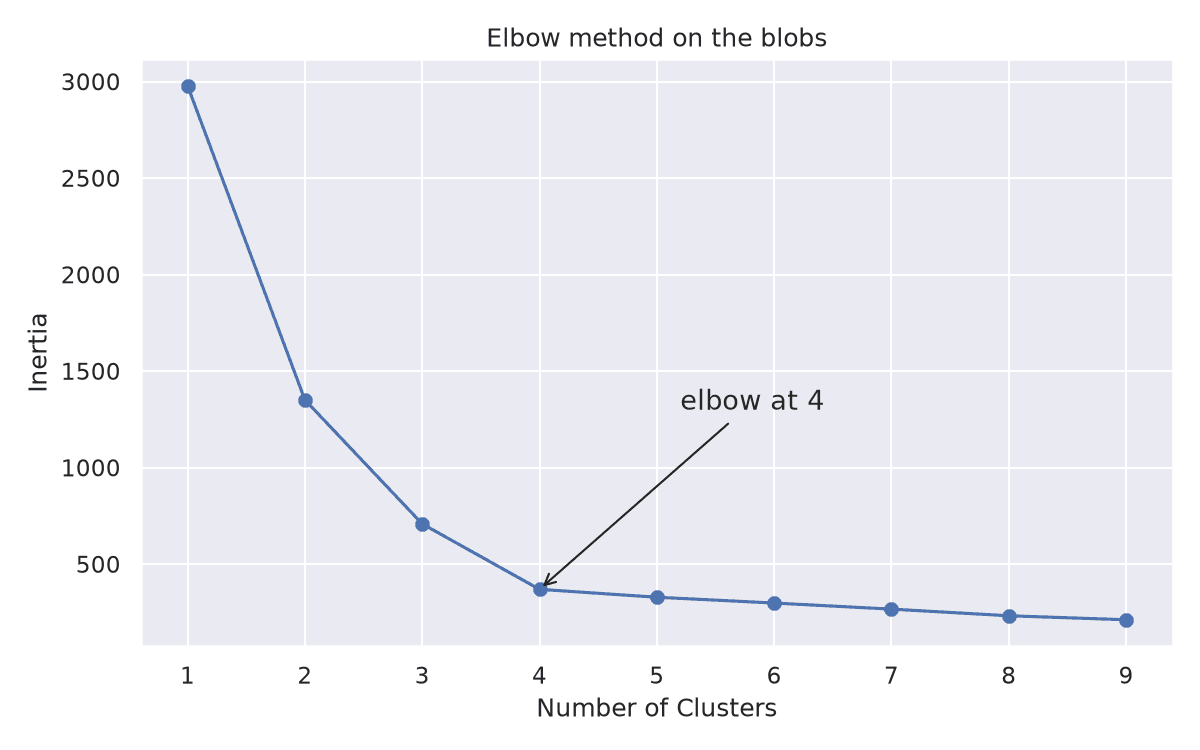
kmeans.inertia_الجزء 3
سيناريو الأسبوع 8: من يحصل على الحملة؟
تقسيم العملاء إلى شرائح بناء على بياناتهم، لتحديد العملاء الذين تستهدفهم حملة لمنتج جديد أو عرض ترويجي يزيد نشاطهم الشرائي.
| العمود | في العملاء الـ200 |
|---|---|
Gender | Male أو Female (88 و112) |
Age | من 18 إلى 70 |
Annual Income (k$) | من 15 إلى 137 |
Spending Score (1-100) | من 1 إلى 99: مقدار إنفاق العميل |
قيمة customers.shape هي (200, 5)؛ ويعرض info() أنه لا توجد قيم مفقودة
url = ("https://raw.githubusercontent.com/"
       "jeffprosise/Machine-Learning/master/"
       "Data/customers.csv")
customers = pd.read_csv(url)

points = customers.iloc[:, 3:5].values
x = points[:, 0]
y = points[:, 1]
plt.scatter(x, y, s=50, alpha=0.7)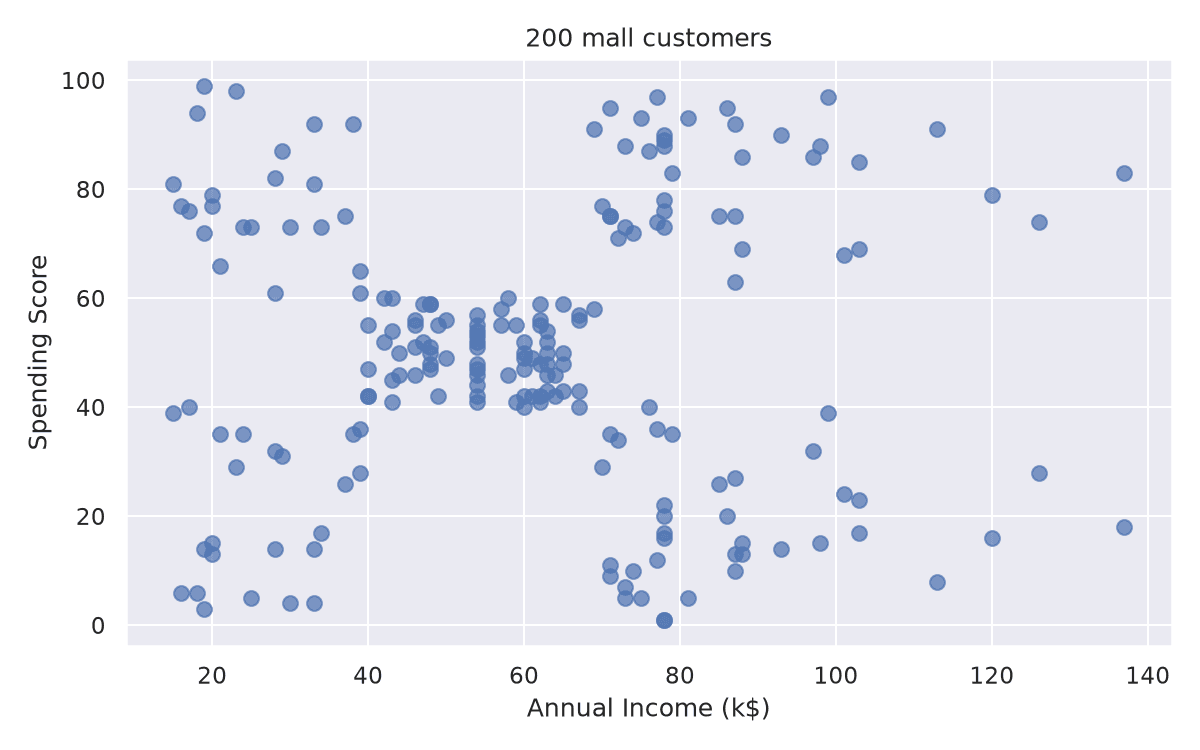
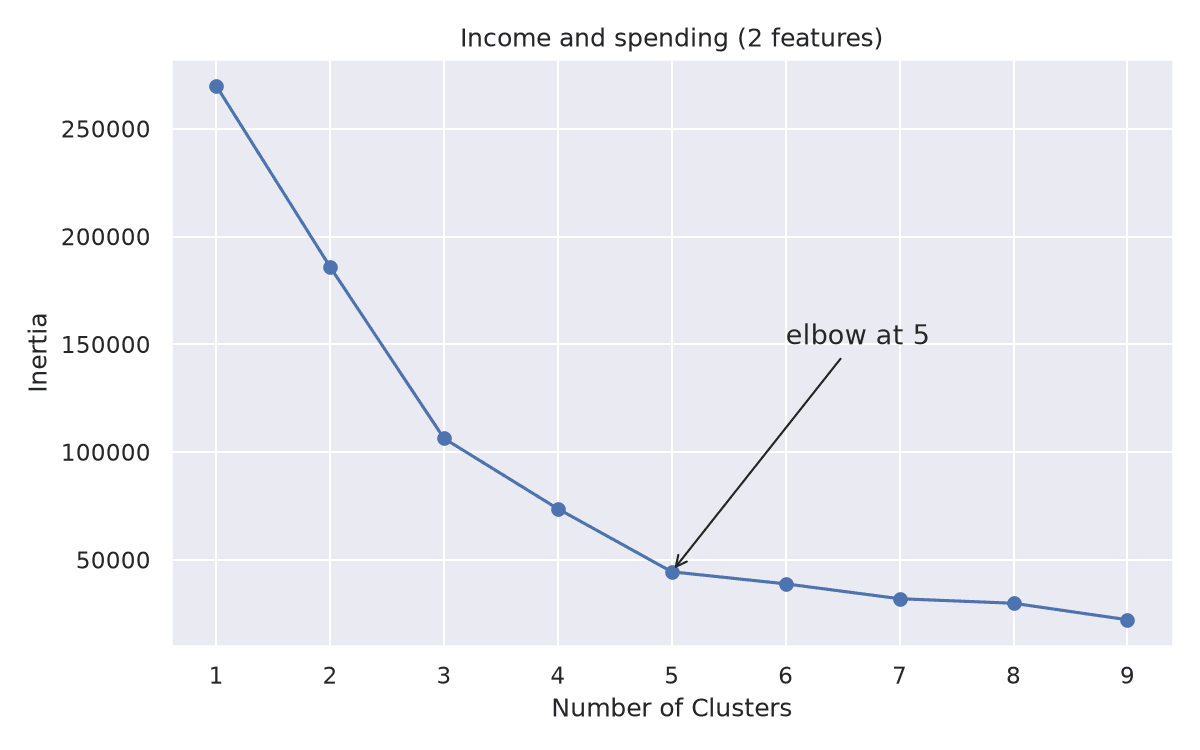
KMeans(n_clusters=5, random_state=0)؛ والنقاط الحمراء هي المراكز
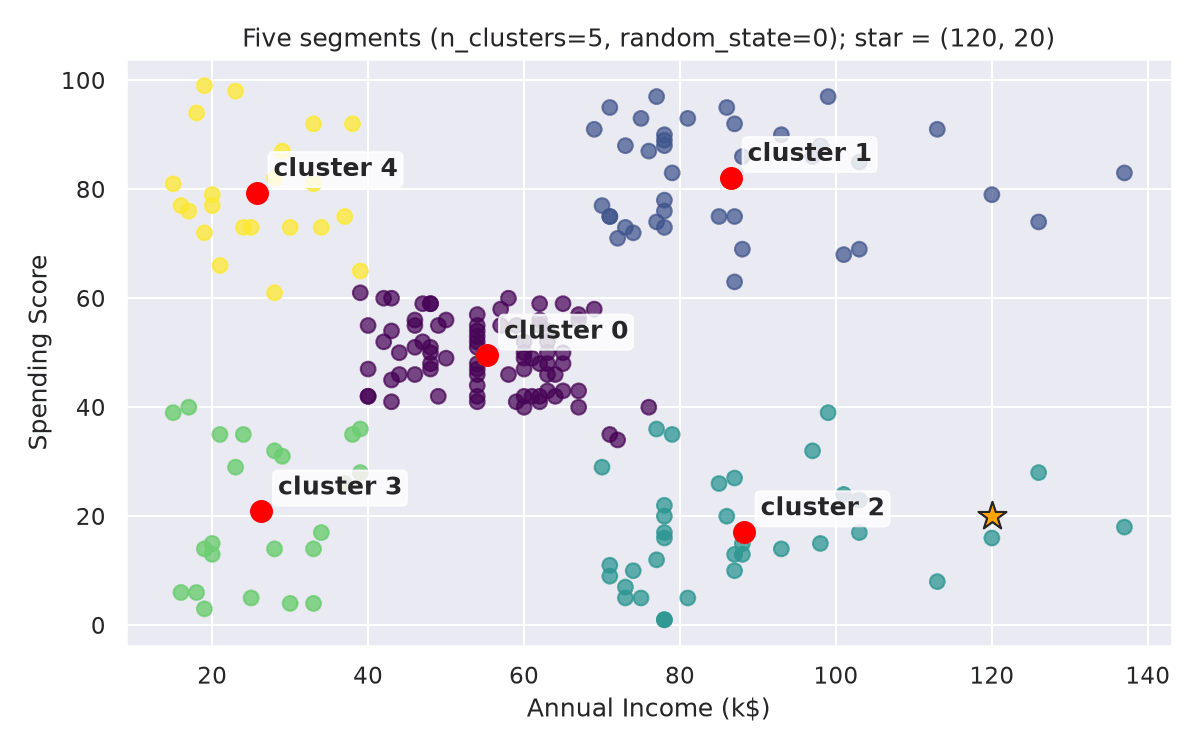
مراكز الشرائح الخمس
| العنقود | متوسط الدخل (ألف دولار) | متوسط الإنفاق | العملاء |
|---|---|---|---|
| 0 | 55.30 | 49.52 | 81 |
| 1 | 86.54 | 82.13 | 39 |
| 2 | 88.20 | 17.11 | 35 |
| 3 | 26.30 | 20.91 | 23 |
| 4 | 25.73 | 79.36 | 22 |
df = customers.copy()
df['Cluster'] = kmeans.predict(points)

cluster = kmeans.predict(np.array([[120, 20]]))[0]
clustered_df = df[df['Cluster'] == cluster]
clustered_df['CustomerID'].valuesالجنس والعمر والدخل والإنفاق؛ مع استبعاد CustomerID
from sklearn.preprocessing import LabelEncoder

df = customers.copy()
encoder = LabelEncoder()
df['Gender'] = encoder.fit_transform(df['Gender'])
points = df.iloc[:, 1:5].values

kmeans = KMeans(n_clusters=5, random_state=0)
kmeans.fit(points)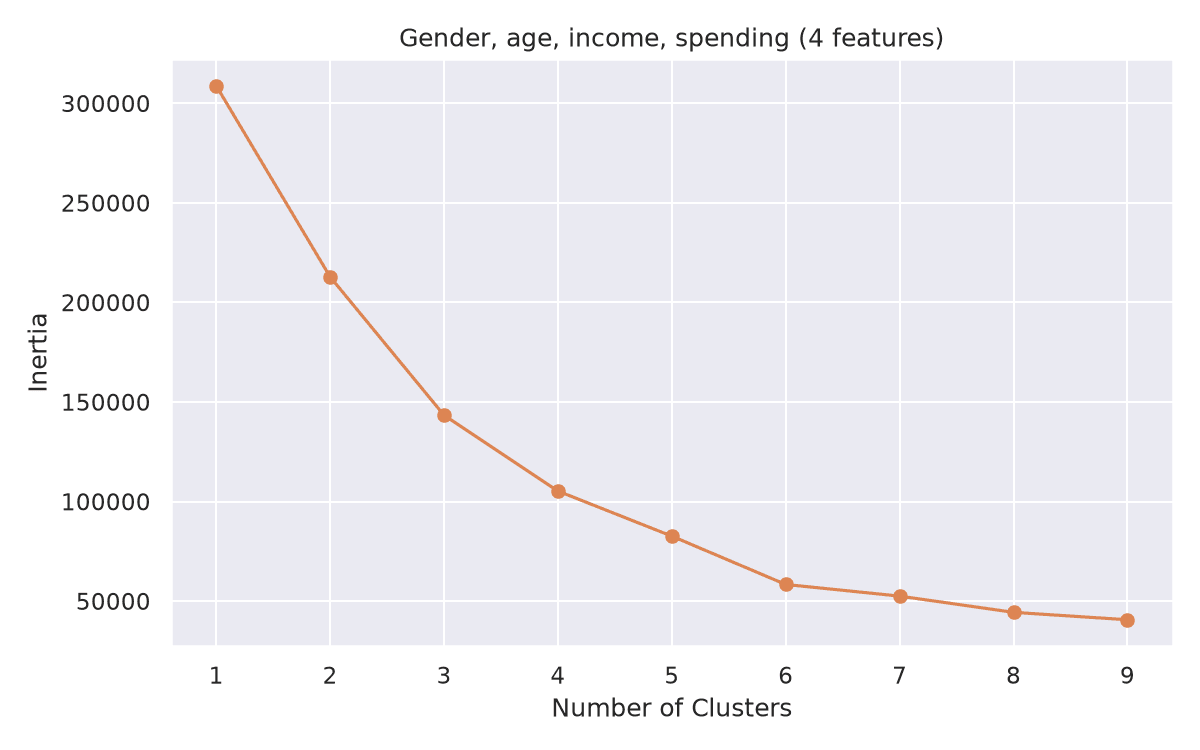
حلقة التقرير في الدفتر، صف لكل عنقود
| العنقود | متوسط العمر | متوسط الدخل | متوسط الإنفاق |
|---|---|---|---|
| 0 | 54.06 | 40.46 | 36.72 |
| 1 | 32.69 | 86.54 | 82.13 |
| 2 | 25.25 | 25.83 | 76.92 |
| 3 | 41.65 | 88.74 | 16.76 |
| 4 | 33.40 | 58.06 | 48.77 |
يعرض الدفتر المحفوظ أعمارا أخرى للخلية نفسها: 45.22، 32.69، 43.09، 40.67، 25.52
init='k-means++')، ويثبتها random_staten_init = عدد البدايات التي يشغلها النموذج؛ ويحتفظ منها بالتشغيل صاحب أصغر قصور ذاتيn_init='auto' بداية واحدة| الإعداد | القصور الذاتي | أحجام العناقيد |
|---|---|---|
| بداية واحدة (الافتراضي) | 82657.05 | 50, 39, 24, 34, 53 |
n_init=10 | 75399.62 | 23, 39, 79, 23, 36 |
الجزء 4
هل تستطيع k-means أن تجد الكليات الخاصة والحكومية دون التسميات؟
Private (Yes أو No) و17 عددا: Apps، وF.Undergrad، وOutstate، وExpend، ...Private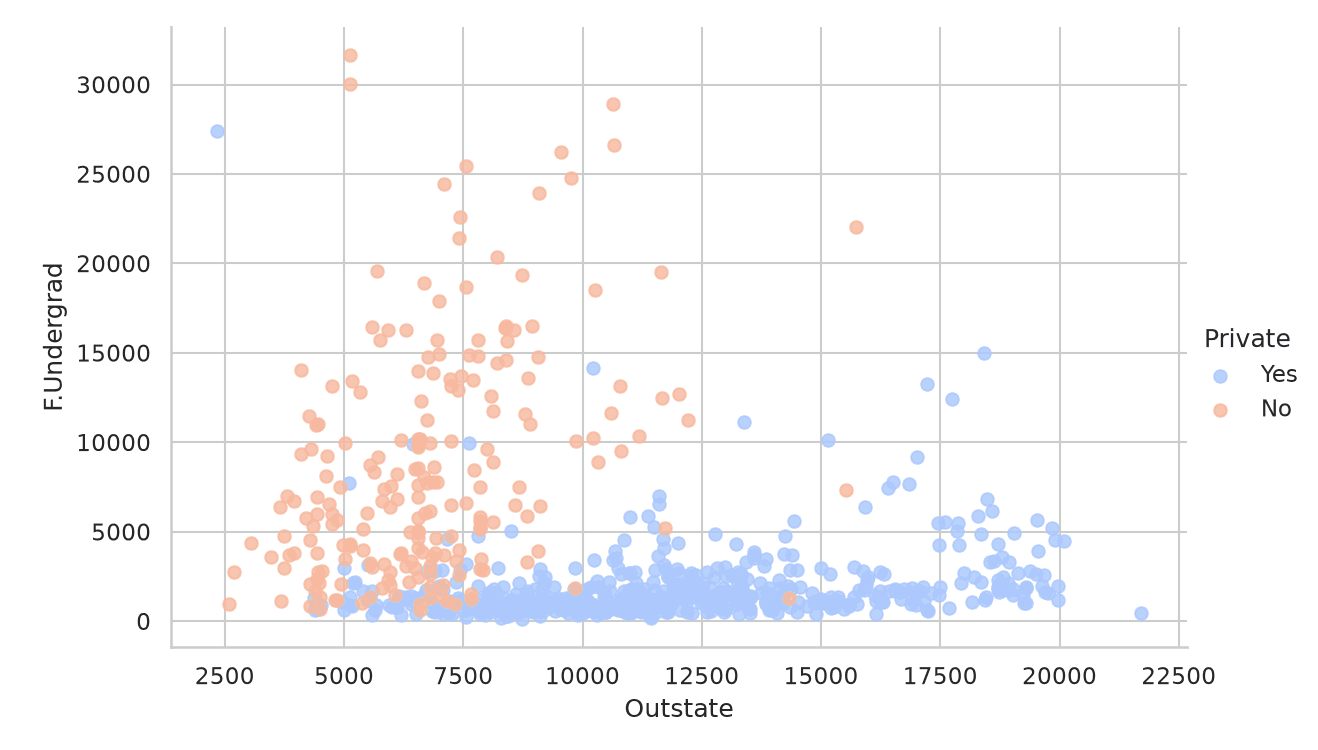
url = ("https://raw.githubusercontent.com/"
       "tirthajyoti/Machine-Learning-with-Python/"
       "master/Datasets/College_Data")
df = pd.read_csv(url, index_col=0)
df.loc['Cazenovia College', 'Grad.Rate'] = 100College_Data ليس بجوار الدفتر في Colab: اقرأه من Datasetsdf['Grad.Rate']['Cazenovia College'] = 100 تعيين متسلسل (chained assignment): مع pandas 3 يكتفي بتحذير ويبقى المعدل 118. استخدم .locx= وy= بالاسم، وإلى height= بدلا من size= في lmplot وFacetGridأضفنا random_state=0 ليكون التشغيل قابلا للتكرار
kmeans = KMeans(n_clusters=2, verbose=0, tol=1e-3, max_iter=300,
                n_init=20, random_state=0)
kmeans.fit(df.drop('Private', axis=1))| الخاصية | العنقود 0 (669) | العنقود 1 (108) |
|---|---|---|
Apps | 1813.2 | 10363.1 |
F.Undergrad | 2188.5 | 13061.9 |
Outstate | 10395.7 | 10719.2 |
Expend | 8932.0 | 14170.5 |
Cluster = 1 للكلية الخاصة، و0 للحكومية؛ وA = الدقة (accuracy)
print(confusion_matrix(df['Cluster'], kmeans.labels_))
# [[138  74]
# [531 34]]1 - kmeans.labels_: المصفوفة المحفوظة في الدفتر
| العنقود 0 | العنقود 1 | |
|---|---|---|
| حكومية (0) | 74 | 138 |
| خاصة (1) | 34 | 531 |
قبل التمارين
n_init=10 أو أكثرdf1 = df وأنت تقصد df1 = df.copy(): فبهذه الطريقة تسرب الخلية الأخيرة في الدفتر التسمياتمشروع فريقك
الجزء 5
نحو 30 دقيقة، والإجابات بعد كل مهمة
نحو 10 دقائق
Jالإجابات
التكرار 1: المسافات إلى μ1 = (19, 14) وμ2 = (73, 88)
| العميل | d² إلى μ1 | d² إلى μ2 | ينضم إلى |
|---|---|---|---|
| #11 | 0 | 2916 + 5476 = 8392 | μ1 |
| #49 | 441 + 784 = 1225 | 1089 + 2116 = 3205 | μ1 |
| #62 | 729 + 1681 = 2410 | 729 + 1089 = 1818 | μ2 |
| #136 | 8392 | 0 | μ2 |
| #190 | 7056 + 5041 = 12097 | 900 + 9 = 909 | μ2 |
نحو 5 دقائق
عميل جديد: الدخل 100، والإنفاق 50
| العنقود | المركز (الدخل، الإنفاق) |
|---|---|
| 0 | (55.3, 49.5) |
| 1 | (86.5, 82.1) |
| 2 | (88.2, 17.1) |
| 3 | (26.3, 20.9) |
| 4 | (25.7, 79.4) |
نحو 5 دقائق
بعد التبديل؛ A الدقة، وP_1 الضبط (precision) وR_1 الاستدعاء (recall) لصنف الكليات الخاصة
| العنقود 0 | العنقود 1 | |
|---|---|---|
| حكومية (0) | 74 | 138 |
| خاصة (1) | 34 | 531 |
نحو 10 دقائق
[[100, 50], [20, 90]] باستدعاء واحدn_init=10: اطبع inertia_ وnp.bincount(kmeans.labels_)random_state=2: اطبع مصفوفة الالتباس (confusion matrix) وaccuracy_score| المهمة | النتيجة |
|---|---|
| 1 | [1 4]: دخل مرتفع وإنفاق مرتفع، ثم دخل منخفض وإنفاق مرتفع |
| 2 | 75399.62، والأحجام [23 39 79 23 36] |
| 3 | [[74 138] [34 531]]، والدقة 0.7786: تغيرت الأسماء فقط |
inertia_) مدى التماسك، ولا تستطيع أي من الخطوتين رفعهn_initMahmoud Abas|التجميع بخوارزمية k-Means