

أشجار القرار والغابة العشوائية
يقدم هذا القسم مصنفين (classifiers) يتنبآن بطرح الأسئلة. تطرح شجرة القرار (decision tree) على العينة سلسلة قصيرة من الأسئلة التي يجاب عنها بنعم أو لا، مثل "هل درجة الائتمان 677 على الأكثر؟"، ثم تقرأ الإجابة في نهاية السلسلة. أما الغابة العشوائية (random forest) فتنمي أشجارا كثيرة مختلفة وتدعها تصوت. ستنمي أولا شجرة صغيرة يدويا على عشرة مقترضين حقيقيين، ثم تدرب شجرة وغابة في scikit-learn على قروض Lending Club، وهي بيانات الأسبوع 6.
الأهداف
في نهاية هذا القسم يجب أن تكون قادرا على:
- شرح كيف تصنف شجرة القرار عينة: سلسلة من أسئلة العتبة (threshold) تنتهي عند ورقة (leaf).
- حساب عدم نقاء جيني (Gini impurity) لعقدة (node) وجيني الموزون (weighted Gini) لتقسيم (split) يدويا، واستخدامه لاختيار التقسيم.
- شرح لماذا تطابق الشجرة التي تنمو حتى تصبح كل أوراقها نقية بيانات التدريب تماما، لكنها تتنبأ تنبؤا ضعيفا بالبيانات الجديدة.
- شرح الأفكار الثلاث للغابة العشوائية: عينات bootstrap، ومجموعة جزئية عشوائية من الخصائص (features) عند كل تقسيم، والتصويت بالأغلبية (majority vote).
- تدريب
DecisionTreeClassifierوRandomForestClassifierعلى بيانات Lending Club، وقراءة مصفوفة الالتباس (confusion matrix) لكل منهما. - إدراك متى لا تعكس الدقة (accuracy) العالية إلا هدفا (target) غير متوازن، وتطبيق الخطوات نفسها على مشروع فريقك.
موقع الدرس من المقرر
للأسبوع 6 في الخطة ثلاثة أجزاء:
- دفتر واحد. يدرب الدفتر (notebook)
DecisionTrees_RandomForest_Classificationشجرة قرار وغابة عشوائية على بيانات إقراض عامة. - سيناريو من الواقع. تربط Lending Club بين من يحتاجون إلى المال (المقترضين) ومن يملكون المال (المستثمرين). نحاول إنشاء نموذج يتنبأ بخطر إقراض المال لشخص ما بناء على مجموعة واسعة من البيانات الائتمانية: نتنبأ بما إذا كان المقترض قد سدد قرضه كاملا أم لا.
- مرحلة المشروع (project milestone). تنفيذ نموذج تعلم الآلة (Machine Learning Model Implementation): يواصل فريقك تنفيذ النماذج على بياناته الخاصة.
في الأسبوع 5 صنفت البيانات باستخدام KNN، وهي تقيس المسافات. أما الشجرة فلا تقيس أي مسافة: إنها تقارن خاصية واحدة بعتبة واحدة في كل مرة. ويبقى نمط fit وpredict وscore كما هو تماما.
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | فكرة الشجرة، وشجرة ننميها يدويا | 30 دقيقة |
| 2 | دفتر Lending Club: البيانات والاستكشاف | 15 دقيقة |
| 3 | شجرة قرار واحدة على القروض | 10 دقائق |
| 4 | الغابة العشوائية: يدويا، ثم على القروض | 25 دقيقة |
| 5 | الأخطاء، والمشروع، والتمارين مع الإجابات، والخلاصة | 40 دقيقة |
الجزء 1: فكرة شجرة القرار
ما شجرة القرار
تصنف شجرة القرار العينة بطرح سلسلة من الأسئلة عن خصائصها. يقارن كل سؤال خاصية واحدة بعتبة، مثل fico ≤ 677. وترسل الإجابة العينة إلى الفرع الأيسر (نعم) أو إلى الفرع الأيمن (لا)، حيث ينتظرها السؤال التالي. وحين لا يبقى أي سؤال، تكون العينة قد وصلت إلى ورقة، وصنف الورقة هو التنبؤ.
المصطلحات على بيانات القروض
| المصطلح | في بيانات Lending Club |
|---|---|
الخصائص X | البيانات الائتمانية للمقترض، مثل fico (درجة الائتمان) وint.rate (سعر الفائدة) |
التسمية (label) y | not.fully.paid: 1 لم يسدد كاملا، و0 سدد كاملا |
| عقدة الجذر (root node) | السؤال الأول، ويطرح على كل مقترض |
| العقدة الداخلية (internal node) | سؤال لاحق، لا يطرح إلا على المقترضين الذين وصلوا إليه |
| الورقة | عقدة بلا سؤال؛ تتنبأ بصنف الأغلبية بين مقترضي التدريب فيها |
| العمق (depth) | عدد الأسئلة على أطول مسار من الجذر إلى ورقة |
كيف تختار الشجرة سؤالا: عدم نقاء جيني
السؤال الجيد يفصل بين الصنفين: بعده يجب أن يحمل كل جانب صنفا واحدا في الغالب. يبني الدفتر شجرته باستخدام criterion='gini'، الذي يقيس مدى اختلاط العقدة باستخدام عدم نقاء جيني:
G = 1 - (p0^2 + p1^2)هنا p0 هي نسبة مقترضي العقدة في الصنف 0 (سدد)، وp1 نسبتهم في الصنف 1 (لم يسدد). وتحدد حالتان المقياس:
- عقدة نقية (pure)، كلها من صنف واحد:
p0 = 1، وp1 = 0، إذنG = 1 - 1 = 0. - عقدة 50 إلى 50:
G = 1 - (0.25 + 0.25) = 0.5، وهي أكبر قيمة يمكن أن يبلغها صنفان.
يقسم السؤال عقدة فيها n من المقترضين إلى جانب أيسر فيه nL وجانب أيمن فيه nR. وجودة السؤال هي جيني الموزون للجانبين، حيث يحسب كل جانب بنسبة حجمه:
Gw = (nL / n) * GL + (nR / n) * GRGL وGR هما عدم نقاء جيني للجانبين الأيسر والأيمن. تجرب الشجرة كل خاصية وكل عتبة، وتحتفظ بالسؤال صاحب أقل Gw، وهو نفسه صاحب أكبر انخفاض G - Gw. والعتبات المرشحة هي نقاط المنتصف (midpoints) بين القيم المتجاورة للخاصية في العقدة.
مثال محلول: شجرة ننميها يدويا
نأخذ عشرة مقترضين حقيقيين من بيانات Lending Club ونستخدم خاصيتين، fico وint.rate. أربعة منهم لم يسددوا قروضهم كاملة.
| المقترض | fico | int.rate | not.fully.paid |
|---|---|---|---|
| B1 | 647 | 0.1482 | 1 (لم يسدد) |
| B2 | 662 | 0.1507 | 0 (سدد) |
| B3 | 667 | 0.1299 | 1 (لم يسدد) |
| B4 | 672 | 0.1347 | 1 (لم يسدد) |
| B5 | 682 | 0.1103 | 0 (سدد) |
| B6 | 687 | 0.1387 | 0 (سدد) |
| B7 | 692 | 0.1284 | 0 (سدد) |
| B8 | 707 | 0.1091 | 1 (لم يسدد) |
| B9 | 727 | 0.1059 | 0 (سدد) |
| B10 | 757 | 0.1189 | 0 (سدد) |
هؤلاء هم الصفوف 8443 و1259 و380 و1794 و520 و1183 و2472 و142 و7764 و2217 من loan_data.csv، مرتبين حسب fico.
الخطوة 1: جيني الجذر
يضم الجذر المقترضين العشرة كلهم: 6 سددوا و4 لم يسددوا.
G = 1 - (0.6^2 + 0.4^2) = 1 - (0.36 + 0.16) = 0.48الجذر قريب من أسوأ قيمة، 0.5: الصنفان مختلطان اختلاطا كبيرا.
الخطوة 2: جرب السؤال fico ≤ 677
العدد 677 هو نقطة المنتصف بين B4 (672) وB5 (682). يرسل السؤال المقترضين من B1 إلى B4 إلى اليسار، ومن B5 إلى B10 إلى اليمين.
- اليسار، 4 مقترضين: B1 وB3 وB4 لم يسددوا، وB2 سدد. إذن 3 لم يسددوا و1 سدد.
- اليمين، 6 مقترضين: B8 وحده لم يسدد. إذن 1 لم يسدد و5 سددوا.
الخطوة 3: جيني كل جانب
GL = 1 - ((3/4)^2 + (1/4)^2) = 1 - (0.5625 + 0.0625) = 0.375
GR = 1 - ((1/6)^2 + (5/6)^2) = 1 - (1/36 + 25/36) = 10/36 = 0.2778
الجانبان كلاهما أنقى من الجذر (0.48).
الخطوة 4: جيني الموزون للتقسيم
Gw = (4/10) * 0.375 + (6/10) * 0.2778 = 0.15 + 0.1667 = 0.3167الانخفاض هو 0.48 - 0.3167 = 0.1633.
الخطوة 5: الخاصية الأخرى
أفضل سؤال على int.rate هو int.rate ≤ 0.12915، وهو نقطة المنتصف بين B3 (0.1299) وB7 (0.1284).
- اليسار، 5 مقترضين أسعار فائدتهم أقل: B5 وB7 وB8 وB9 وB10. وB8 وحده لم يسدد:
GL = 1 - (0.2^2 + 0.8^2) = 0.32. - اليمين، 5 مقترضين أسعار فائدتهم أعلى: B1 وB2 وB3 وB4 وB6. ثلاثة منهم لم يسددوا:
GR = 1 - (0.6^2 + 0.4^2) = 0.48.
Gw = (5/10) * 0.32 + (5/10) * 0.48 = 0.40القيمة 0.40 أعلى من 0.3167، لذا تعطي درجة الائتمان سؤالا أولا أفضل.
الخطوة 6: يجرب البحث كل عتبة
تعطي قيم fico العشر تسع نقاط منتصف. وهذه قيم جيني الموزون لها:
| العتبة | اليسار: لم يسدد، سدد | اليمين: لم يسدد، سدد | جيني الموزون |
|---|---|---|---|
| 654.5 | 1, 0 | 3, 6 | 0.4000 |
| 664.5 | 1, 1 | 3, 5 | 0.4750 |
| 669.5 | 2, 1 | 2, 5 | 0.4190 |
| 677 | 3, 1 | 1, 5 | 0.3167 |
| 684.5 | 3, 2 | 1, 4 | 0.4000 |
| 689.5 | 3, 3 | 1, 3 | 0.4500 |
| 699.5 | 3, 4 | 1, 2 | 0.4762 |
| 717 | 4, 4 | 0, 2 | 0.4000 |
| 742 | 4, 5 | 0, 1 | 0.4444 |
وتعطي نقاط المنتصف التسع لـint.rate قيما بين 0.40 و0.4762. إذن أقل قيمة بين الأسئلة الثمانية عشر المرشحة كلها هي قيمة fico ≤ 677، فيصبح هذا السؤال سؤال الجذر.
الخطوة 7: تنمية العقدة الابنة اليسرى
تضم العقدة الابنة (child node) اليسرى المقترضين من B1 إلى B4 (3 لم يسددوا، و1 سدد، G = 0.375). والمقترض الذي سدد، B2، له أعلى سعر فائدة بين الأربعة (0.1507)، لذا يفصله السؤال int.rate ≤ 0.14945:
- اليسار: B1 وB3 وB4، ولم يسدد أي منهم،
G = 0. - اليمين: B2، وقد سدد،
G = 0.
جيني الموزون يساوي 0: الجانبان نقيان ويصبحان ورقتين. (أفضل سؤال على fico هنا، fico ≤ 664.5، لا يصل إلا إلى 0.25.)
الخطوة 8: تنمية العقدة الابنة اليمنى
تضم العقدة الابنة اليمنى المقترضين من B5 إلى B10 (1 لم يسدد، و5 سددوا، G = 0.2778). والمتعثر (defaulter) الوحيد، B8، درجته جيدة (707) وسعر فائدته منخفض (0.1091). وأفضل سؤال هو int.rate ≤ 0.1097:
- اليسار: B9 وB8، 1 سدد و1 لم يسدد،
G = 0.5. - اليمين: B5 وB6 وB7 وB10، وكلهم سددوا،
G = 0.
Gw = (2/6) * 0.5 + (4/6) * 0 = 0.1667أفضل سؤال على fico لهذه العقدة، fico ≤ 699.5، يعطي 0.2222، لذا يفوز سعر الفائدة مرة أخرى.
الشجرة التي بنيناها
fico <= 677 ?
|-- yes: int.rate <= 0.14945 ?
|        |-- yes: leaf [3 not paid, 0 paid]  -> not paid
|        |-- no:  leaf [0 not paid, 1 paid]  -> paid
|-- no:  int.rate <= 0.1097 ?
         |-- yes: leaf [1 not paid, 1 paid]  -> paid (a tie goes to class 0)
         |-- no:  leaf [0 not paid, 4 paid]  -> paid
تبني scikit-learn هذه الشجرة نفسها تماما من الصفوف العشرة نفسها باستخدام DecisionTreeClassifier(max_depth=2): الأسئلة نفسها، والعتبات نفسها، وقيم جيني نفسها (0.48 عند الجذر، و0.375 و0.2778 عند العقدتين الابنتين). وحين تحمل ورقة تعادلا، تتنبأ scikit-learn بالصنف صاحب الرقم الأصغر، وهو هنا 0.
التنبؤ بمقترضين جديدين
- fico 670، int.rate 0.14. بما أن 670 ≤ 677، اتجه يسارا. وبما أن 0.14 ≤ 0.14945، اتجه يسارا مرة أخرى. تتنبأ الورقة بأنه لم يسدد.
- fico 700، int.rate 0.12. بما أن 700 > 677، اتجه يمينا. وبما أن 0.12 > 0.1097، اتجه يمينا مرة أخرى. تتنبأ الورقة بأنه سدد.
افتح أداة بناء شجرة القرار بملء الشاشة لتنمي هذه الشجرة بنفسك. اختر خاصية، وحرك العتبة، وراقب قيم جيني، أو اضغط تشغيل البحث لتشاهد البحث يجرب كل عتبة، ثم اضغط تقسيم العقدة.
الإنتروبيا، المعيار الآخر في الدفتر
يدرب الدفتر أيضا غابات باستخدام criterion='entropy'، وهو مقياس ثان لمدى اختلاط العقدة يسمى الإنتروبيا (entropy):
H = -(p0 * log2(p0) + p1 * log2(p1))للعقدة النقية H = 0، وللعقدة 50 إلى 50 H = 1. ولجذرنا H = -(0.6 * log2(0.6) + 0.4 * log2(0.4)) = 0.971. ومع الإنتروبيا تختار scikit-learn هنا السؤال الأول نفسه، fico ≤ 677. وفي العادة يتفق المعياران على التقسيمات الجيدة.
شجرة لا تتوقف
ينمي الدفتر شجرته باستخدام max_depth=None: تستمر الشجرة في التقسيم حتى تصبح كل ورقة نقية. وعلى مقترضينا العشرة، يفصل سؤال إضافي واحد، fico ≤ 717، بين B8 وB9. عمق الشجرة الكاملة 3 ولها 5 أوراق، وهي تصنف مقترضي التدريب العشرة كلهم تصنيفا صحيحا. هذا السؤال الأخير موجود فقط لعزل مقترض واحد. والشجرة التي تنمو حتى تحفظ صفوف تدريبها تعاني فرط الملاءمة (overfitting): إنها تتعلم مصادفات مجموعة التدريب، ويدفع المقترضون الجدد الثمن. ويبين الجزء 3 ذلك على البيانات الحقيقية.
الجزء 2: دفتر Lending Club
افتح الدفتر
افتح DecisionTrees_RandomForest_Classification في Colab
يقرأ الدفتر loan_data.csv من مجلده الخاص. وهذا الملف غير موجود هناك في Colab: فهو في المستودع داخل المجلد Datasets. اقرأه من المستودع بدلا من ذلك:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

url = ("https://raw.githubusercontent.com/"
       "tirthajyoti/Machine-Learning-with-Python/"
       "master/Datasets/loan_data.csv")
df = pd.read_csv(url)
df.info()
تحميل البيانات وفحصها
يبلغ df.info() عن 9578 صفا و14 عمودا، ولا توجد قيم مفقودة. ومن الأعمدة التي يصفها الدفتر:
| العمود | المعنى |
|---|---|
credit.policy | 1 إذا استوفى المقترض معايير الاكتتاب الائتماني (credit underwriting criteria) لموقع LendingClub.com، و0 خلاف ذلك |
purpose | الغرض من القرض، وهو نص مثل credit_card أو debt_consolidation |
int.rate | سعر الفائدة في صورة نسبة (تخزن 11% على أنها 0.11)؛ ويحصل المقترضون الأكثر خطورة على أسعار أعلى |
fico | درجة FICO الائتمانية للمقترض |
not.fully.paid | التسمية: 1 إذا لم يسدد المقترض كاملا |
والأعمدة الثمانية الأخرى أرقام أيضا: القسط الشهري، ولوغاريتم الدخل السنوي، ونسبة الدين إلى الدخل، وعدد الأيام التي امتلك فيها المقترض خط ائتمان، والرصيد المتجدد ونسبة استخدامه، والاستعلامات في آخر 6 أشهر، ومرات التأخر في السداد خلال 2 من السنوات، والسجلات العامة.
العددان المهمان
print(df['credit.policy'].value_counts())
print(df['not.fully.paid'].value_counts())credit.policy: يستوفي 7710 من المقترضين المعايير، ولا يستوفيها 1868.not.fully.paid: سدد 8045 مقترضا قروضهم كاملة، ولم يسددها 1533. أي أن 16% فقط من المقترضين في الصنف 1.
تذكر العدد الثاني. فالنموذج الذي يجيب "سدد" عن كل المقترضين يصيب بالفعل في 84% من الحالات.
استكشف قبل أن تبني النموذج
يرسم الدفتر مدرجا تكراريا (histogram) لـfico لكل قيمة من قيم credit.policy:
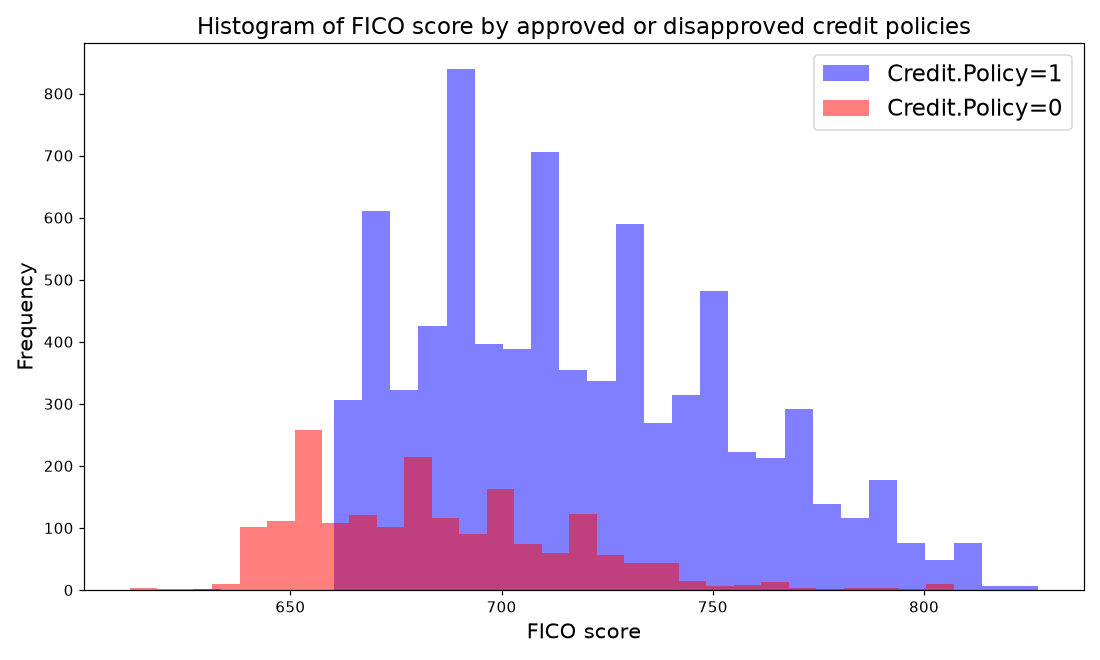
كل المقترضين تقريبا الذين تقل درجتهم عن 660 لا يستوفون سياسة الائتمان: 487 مقترضا مقابل 2. فعتبة واحدة على خاصية واحدة تفصل مجموعة فصلا جيدا، وهذا بالضبط نوع السؤال الذي تطرحه الشجرة.
ثم يعد القروض حسب الغرض، ملونة حسب not.fully.paid:
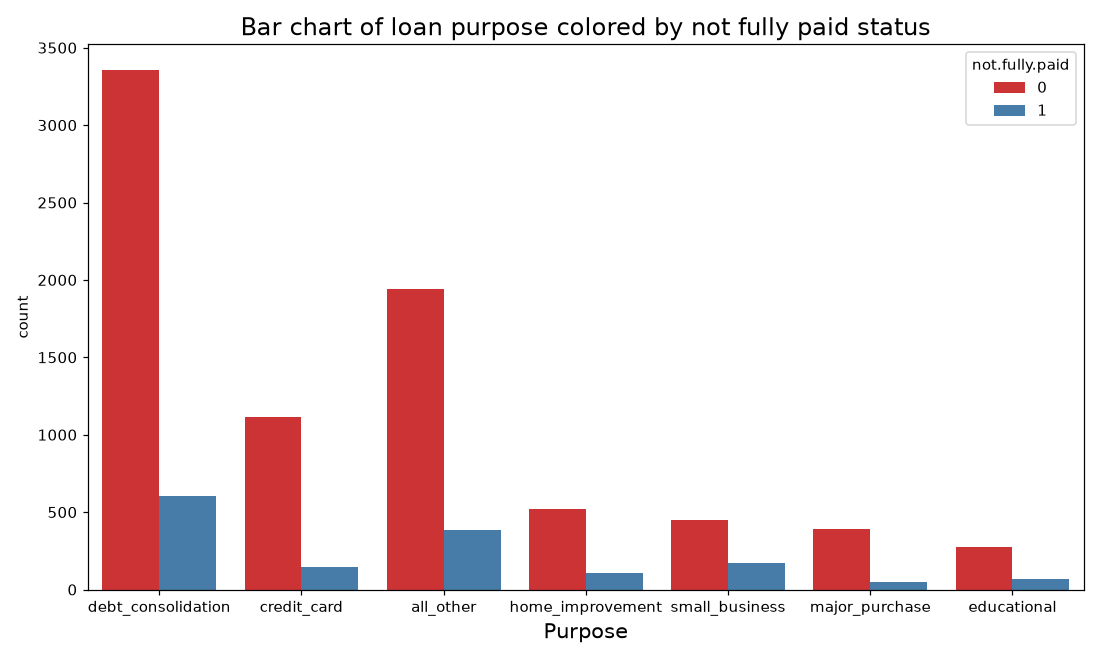
الغرض الأكثر شيوعا هو debt_consolidation (3957 قرضا). وتختلف نسبة القروض التي لم تسدد كاملة حسب الغرض: 27.8% لـsmall_business، و11.6% لـcredit_card، و11.2% لـmajor_purchase.
تمرر خلية lmplot اللاحقة الوسيط size=6. وقد غيرت الإصدارات الحالية من seaborn اسم هذا الوسيط، فتتوقف الخلية بالخطأ TypeError: lmplot() got an unexpected keyword argument 'size'. اكتب height=6 بدلا منه.
تحويل عمود النص إلى أرقام
يحمل purpose نصا، وتحتاج scikit-learn إلى أرقام. ينشئ الدفتر متغيرات وهمية (dummy variables):
df_final = pd.get_dummies(df, ['purpose'], drop_first=True)- تصبح الأغراض السبعة ستة أعمدة قيمها 0 أو 1، مثل
purpose_credit_card. ويحذفdrop_first=Trueالغرض الأول،all_other: فالمقترض الذي قيمه 0 في الأعمدة الستة كلها غرضه هو هذا الغرض. - في
df_final19 عمودا: أعمدة الخصائص الـ12 الأخرى، والأعمدة الوهمية الـ6، والتسمية. - الوسيط الثاني هنا هو
prefixللأعمدة الجديدة. والصيغة الأوضح هيpd.get_dummies(df, columns=['purpose'], drop_first=True)، وهي تعطي الأعمدة الـ19 نفسها.
التقسيم إلى مجموعة تدريب ومجموعة اختبار
from sklearn.model_selection import train_test_split

X = df_final.drop('not.fully.paid', axis=1)
y = df_final['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.30, random_state=101)- في
X18 عمودا للخصائص. ويحتفظtest_size=0.30بـ2874 مقترضا للاختبار، ويدرب على 6704. - تضم مجموعة الاختبار 2431 مقترضا سددوا و443 لم يسددوا.
- يستدعي الدفتر
train_test_splitدونrandom_state، لذا يعطي كل تشغيل تقسيما مختلفا وأرقاما مختلفة قليلا. ونضيفrandom_state=101لكي تطابق أرقامك هذه الصفحة.
الجزء 3: شجرة قرار واحدة على القروض
التدريب والتنبؤ
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(criterion='gini', max_depth=None,
                               random_state=101)
dtree.fit(X_train, y_train)
predictions = dtree.predict(X_test)
criterion='gini' هو عدم النقاء الذي رأيناه في الجزء 1. وmax_depth=None يدع الشجرة تنمو حتى تصبح كل ورقة نقية. وrandom_state=101 يثبت الترتيب الذي تجرب به الخصائص، لذا تكسر حالات التعادل بين التقسيمات المتساوية في الجودة بالطريقة نفسها في كل تشغيل.
مثال محلول: تقييم الشجرة
from sklearn.metrics import classification_report, confusion_matrix

cm = confusion_matrix(y_test, predictions)
print(cm)
print("Accuracy of prediction:", round((cm[0,0]+cm[1,1])/cm.sum(), 3))| التنبؤ 0 (سدد) | التنبؤ 1 (لم يسدد) | |
|---|---|---|
| الفعلي 0 (سدد) | 1975 | 456 |
| الفعلي 1 (لم يسدد) | 336 | 107 |
- التنبؤات الصحيحة:
1975 + 107 = 2082من 2874، إذن الدقة2082 / 2874 = 0.724. ويطبع الدفترAccuracy of prediction: 0.724. - استدعاء (recall) الصنف 1: من بين 443 مقترضا لم يسددوا، وجدت الشجرة
107 / 443 = 0.24. - ضبط (precision) الصنف 1: من بين
456 + 107 = 563مقترضا صنفتهم الشجرة على أنهم لم يسددوا، لم يسدد فعلا107 / 563 = 0.19.
ويطبع classification_report(y_test, predictions) القيم نفسها، مقربة:
              precision    recall  f1-score   support

           0       0.85      0.81      0.83      2431
           1       0.19      0.24      0.21       443

    accuracy                           0.72      2874
   macro avg       0.52      0.53      0.52      2874
weighted avg       0.75      0.72      0.74      2874
الشجرة حفظت مجموعة تدريبها
print(dtree.get_depth(), dtree.get_n_leaves())
print(dtree.score(X_train, y_train))
المخرجات هي 27 و1005 و1.0. تطرح الشجرة حتى 27 سؤالا، وتنتهي عند 1005 أوراق، وتصنف كل مقترض من مقترضي التدريب الـ6704 تصنيفا صحيحا. وعلى مقترضي الاختبار تسجل 0.724، وهي أقل من 0.846 التي تحققها الإجابة "سدد" عن الجميع. هذا هو فرط الملاءمة الذي رأيناه في الجزء 1، ولكن بحجمه الكامل.
الجزء 4: الغابة العشوائية
الفكرة: أشجار كثيرة مختلفة، وتصويت واحد
تدرب الغابة العشوائية أشجارا كثيرة وتجمع إجاباتها. وثلاث أفكار تجعل الأشجار مختلفة بعضها عن بعض:
- عينة bootstrap لكل شجرة. من صفوف التدريب البالغ عددها n، اسحب n صفا عشوائيا مع الإرجاع (with replacement). بعض الصفوف يسحب مرتين أو أكثر، وبعضها يترك. وهذا هو
bootstrap=Trueفي النموذج المدرب. - مجموعة جزئية عشوائية من الخصائص عند كل تقسيم. عند كل عقدة لا تبحث الشجرة إلا في خصائص قليلة مختارة عشوائيا. ومع
max_features='sqrt'، وهو الإعداد الافتراضي، تبحث فيmخاصية من أصلp، حيثmهو الجذر التربيعي لـpمقربا إلى الأسفل. - التصويت. تصنف كل شجرة العينة الجديدة، ويفوز الصنف الحاصل على أكثر الأصوات. (تحسب scikit-learn متوسط احتمالات الأصناف في الأشجار؛ وحين تكون كل ورقة نقية، كما في الأشجار التي نمت بالكامل، يساوي ذلك تماما عد الأصوات.)
تتغير الشجرة العميقة الواحدة كثيرا حين تتغير بضعة صفوف من صفوف التدريب. أما الأشجار الكثيرة التي رأت كل منها عينة مختلفة فترتكب أخطاء مختلفة، ويلغي التصويت كثيرا منها.
مثال محلول: خمس أشجار على المقترضين العشرة
ندرب RandomForestClassifier(n_estimators=5, random_state=0) على المقترضين العشرة من الجزء 1، ونقرأ عينة bootstrap لكل شجرة من rf.estimators_samples_. ومع p = 2 من الخصائص تكون m = 1: كل تقسيم يبحث في خاصية عشوائية واحدة.
سحبت الشجرة 1 المقترضين B4، B3، B1، B1، B3، B7، B10، B8، B4، B10. إذن سحب B1 وB3 وB4 وB10 مرتين، وB7 وB8 مرة واحدة، ولم يسحب B2 وB5 وB6 وB9 إطلاقا. وسؤال جذرها هو fico ≤ 682، لا 677: فالمقترض B5 (682) ليس في عينتها، لذا تقع نقطة المنتصف بين B4 (672) وB7 (692).
للمقترض الجديد fico 710 وint.rate 0.11. وتصوت كل شجرة:
| الشجرة | المقترضون الذين تركوا خارج عينتها | الصوت |
|---|---|---|
| 1 | B2، B5، B6، B9 | لم يسدد |
| 2 | B3، B6، B7 | سدد |
| 3 | B1، B3، B7، B10 | سدد |
| 4 | B2، B3، B7، B8، B10 | سدد |
| 5 | B1، B3، B5، B9 | لم يسدد |
نتيجة التصويت 3 أصوات لـ"سدد" مقابل 2 لـ"لم يسدد"، إذن تتنبأ الغابة بأنه سدد. ويعيد rf.predict_proba القيمة [0.6, 0.4]: 3 من 5 أشجار للصنف 0، و2 من 5 للصنف 1. تضع الشجرتان 1 و5 المقترض الجديد في منطقة صغيرة بنتاها حول B8، المتعثر ذي الدرجة الجيدة القريب منه. وتضعه الأشجار الثلاث الأخرى مع المقترضين الذين سددوا، فتتغلب في التصويت على الشجرتين الأوليين.
افتح أداة تصويت الغابة العشوائية بملء الشاشة. اضغط تشغيل لتشاهد كل شجرة تسحب عينة bootstrap الخاصة بها وتصوت، واسحب النجمة لتحريك المقترض الجديد، أو أنشئ غابة عشوائية جديدة من تسع أشجار.
كم خاصية عند كل تقسيم، على القروض
في X_train يوجد p = 18 من الخصائص. والجذر التربيعي لـ18 هو 4.24، لذا يبحث كل تقسيم في 4 خصائص مختارة عشوائيا. وتؤكد الغابة المدربة ذلك: قيمة rfc.estimators_[0].max_features_ هي 4.
تترك عينة bootstrap صفوفا كثيرة خارجها. فعبر الأشجار الـ600 أدناه، رأت كل شجرة ما بين 4160 و4310 مقترضا مختلفا من صفوف التدريب الـ6704، أي 63.2% في المتوسط؛ أما البقية فلم تسحب أبدا لتلك الشجرة.
تدريب الغابة
from sklearn.ensemble import RandomForestClassifier

rfc = RandomForestClassifier(n_estimators=600, random_state=101)
rfc.fit(X_train, y_train)
rfc_pred = rfc.predict(X_test)
print(confusion_matrix(y_test, rfc_pred))
print(classification_report(y_test, rfc_pred))
n_estimators=600 ينمي 600 شجرة. ويعرض الدفتر عند طباعة النموذج المدرب الإعداد الافتراضي الأقدم max_features='auto'؛ أما الإصدارات الحالية من scikit-learn فتسمي الإعداد نفسه 'sqrt'.
مثال محلول: مصفوفة الالتباس للغابة
| التنبؤ 0 (سدد) | التنبؤ 1 (لم يسدد) | |
|---|---|---|
| الفعلي 0 (سدد) | 2420 | 11 |
| الفعلي 1 (لم يسدد) | 431 | 12 |
- الدقة:
(2420 + 12) / 2874 = 0.846، وهي أعلى بكثير من 0.724 للشجرة الواحدة. - لكن الغابة لا تصنف على أنهم لم يسددوا إلا
11 + 12 = 23من مقترضي الاختبار الـ2874. ومن بين 443 لم يسددوا، تجد 12: الاستدعاء12 / 443 = 0.03. - الإجابة "سدد" عن كل مقترض تعطي
2431 / 2874 = 0.846أيضا. والغابة تتفوق على ذلك بمقترض واحد فقط.
              precision    recall  f1-score   support

           0       0.85      1.00      0.92      2431
           1       0.52      0.03      0.05       443

    accuracy                           0.85      2874
   macro avg       0.69      0.51      0.48      2874
weighted avg       0.80      0.85      0.78      2874
يسأل الدفتر عند هذه النقطة: "هل تجد شيئا غريبا؟" وهذا هو الجزء الغريب. فمع 16% فقط من المتعثرين، تصوت معظم الأشجار بـ"سدد" لكل المقترضين تقريبا: لا يحصل أي مقترض اختبار على أكثر من 375 صوتا بـ"لم يسدد" من الأشجار الـ600 (62.5%). الدقة العالية على هدف غير متوازن قد تخفي نموذجا نادرا ما يجد الصنف الذي يهمك. فاقرأ دائما استدعاء ذلك الصنف، لا الدقة وحدها.
زلة في الدفتر
خلية الدفتر الخاصة بتقرير الغابة هي:
cr = classification_report(y_test, predictions)تحمل predictions تنبؤات الشجرة الواحدة، لذا تطبع تلك الخلية تقرير الشجرة مرة ثانية. استخدم rfc_pred، كما في الشيفرة أعلاه.
كم شجرة؟
يدرب الدفتر غابات من 5 و10 و15 شجرة وحتى 100 شجرة، ويسجل دقة كل منها:
nsimu = 21
accuracy = [0] * nsimu
ntree = [0] * nsimu
for i in range(1, nsimu):
    rfc = RandomForestClassifier(n_estimators=i*5, min_samples_split=10,
                                 max_depth=None, criterion='gini',
                                 random_state=101)
    rfc.fit(X_train, y_train)
    rfc_pred = rfc.predict(X_test)
    cm = confusion_matrix(y_test, rfc_pred)
    accuracy[i] = (cm[0,0] + cm[1,1]) / cm.sum()
    ntree[i] = i * 5
يوقف min_samples_split=10 تقسيم أي عقدة تضم أقل من 10 صفوف تدريب. ونضيف random_state=101 إلى كل غابة لكي تعطي الحلقة الأرقام نفسها في كل تشغيل.
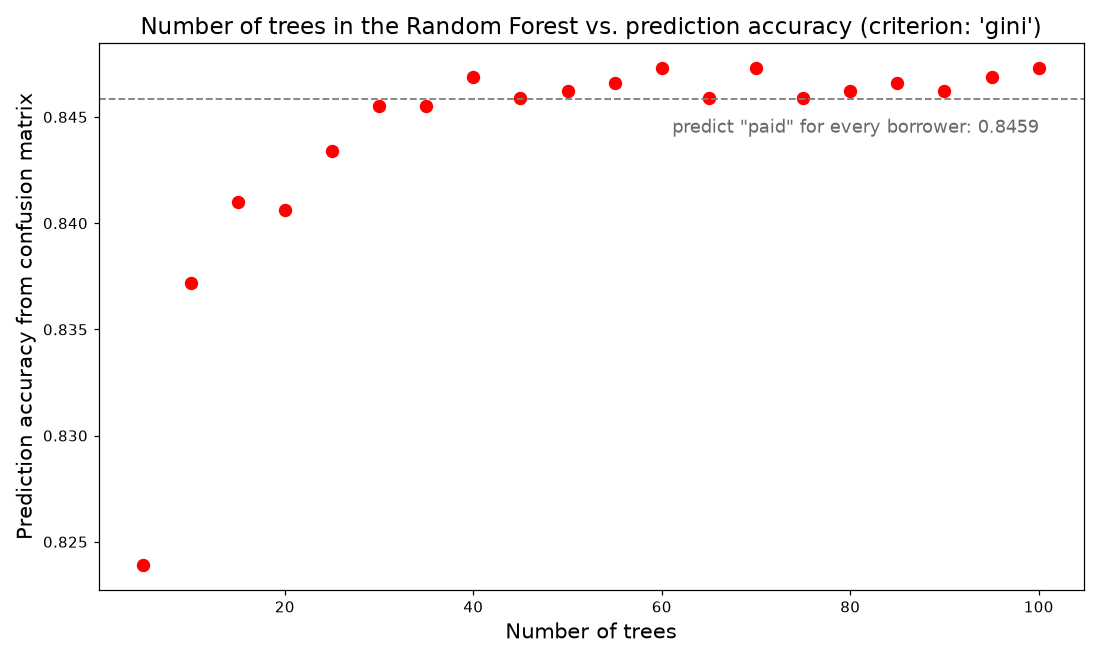
- مع 5 أشجار تبلغ الدقة 0.8239. ثم ترتفع بسرعة، ومن نحو 30 شجرة فصاعدا تبقى بين 0.8455 و0.8473.
- زيادة الأشجار تجعل التصويت أكثر ثباتا، لكنها لا تستطيع تجاوز حد البيانات: يستقر المنحنى عند مستوى الإجابة "سدد" عن الجميع.
يكرر الدفتر الحلقة بإعدادات أخرى. وهذا نطاق الدقة عبر الغابات الـ20 في كل تشغيل:
| الإعداد الذي تغير | أقل دقة | أعلى دقة |
|---|---|---|
لا شيء (gini، min_samples_split=10) | 0.8239 | 0.8473 |
criterion='entropy' | 0.8250 | 0.8473 |
max_depth=5 | 0.8434 | 0.8459 |
min_samples_split=2 | 0.8062 | 0.8466 |
min_samples_split=20 | 0.8302 | 0.8466 |
الفروق عند القمة مقترض أو اثنان من مقترضي الاختبار الـ2874. وتغيير هذه الإعدادات لا يحل المشكلة الحقيقية، وهي أن الغابة لا تكاد تتنبأ بالصنف 1 أبدا.
الأخطاء الشائعة
- قراءة
loan_data.csvفي Colab من مجلد لا يحتويه. - نسيان
random_state، ثم مقارنة أرقام من تقسيمين عشوائيين مختلفين. - تنمية شجرة باستخدام
max_depth=Noneوالثقة بنتيجتها المثالية على بيانات التدريب. - الحكم على نموذج بالدقة وحدها حين يكون أحد الصنفين نادرا.
- طباعة تقرير
predictionsوأنت تقصدrfc_pred. - تمرير عمود نصي مثل
purposeإلى scikit-learn دون متغيرات وهمية.
مرحلة المشروع: تنفيذ النموذج
تستمر المرحلة هذا الأسبوع: نفذ شجرة قرار وغابة عشوائية على بيانات مشروع فريقك.
- خذ الخصائص والهدف اللذين استخدمتهما مع KNN في الأسبوع الماضي، وحول أي عمود نصي باستخدام
pd.get_dummies. - قسم البيانات إلى مجموعة تدريب ومجموعة اختبار مع قيمة ثابتة لـ
random_state. - درب
DecisionTreeClassifierوقارن نتيجته على بيانات التدريب بنتيجته على بيانات الاختبار. - درب
RandomForestClassifierواعرض مصفوفة الالتباس الخاصة به وclassification_report. - قارن الشجرة والغابة ونموذج KNN من الأسبوع الماضي على مجموعة الاختبار نفسها، وانظر إلى استدعاء كل صنف، لا الدقة وحدها.
الخلاصة
- تصنف شجرة القرار بسلسلة من أسئلة العتبة؛ وتتنبأ الورقة بصنف الأغلبية بين صفوف التدريب فيها.
- تختار الشجرة كل سؤال بأقل قيمة لجيني الموزون عبر كل خاصية وكل عتبة.
- الشجرة التي تنمو حتى تصبح كل ورقة نقية تحفظ مجموعة تدريبها وتعاني فرط الملاءمة.
- تدرب الغابة العشوائية أشجارا كثيرة على عينات bootstrap، مع مجموعة جزئية عشوائية من الخصائص عند كل تقسيم، ثم تجري تصويتا.
- حين يكون أحد الصنفين نادرا، قد تخفي الدقة العالية نموذجا لا يكاد يجد ذلك الصنف أبدا: فاقرأ الاستدعاء.
التمارين
نحو 30 دقيقة. حاول حل كل مهمة قبل أن تقرأ إجابتها في نهاية الصفحة.
التمرين 1: اختيار السؤال الأول (نحو 10 دقائق)
ثمانية مقترضين حقيقيين آخرين من loan_data.csv:
| المقترض | fico | int.rate | not.fully.paid |
|---|---|---|---|
| P1 | 647 | 0.1482 | 1 |
| P2 | 667 | 0.1343 | 0 |
| P3 | 677 | 0.1734 | 1 |
| P4 | 682 | 0.1197 | 0 |
| P5 | 692 | 0.1287 | 0 |
| P6 | 697 | 0.1316 | 1 |
| P7 | 742 | 0.1114 | 0 |
| P8 | 747 | 0.0751 | 0 |
- احسب عدم نقاء جيني للجذر.
- احسب جيني الموزون للسؤال
fico ≤ 679.5. - احسب جيني الموزون للسؤال
int.rate ≤ 0.13015. - أي سؤال تختاره الشجرة، وما مقدار الانخفاض في جيني؟
التمرين 2: قراءة مصفوفة الالتباس للغابة (نحو 5 دقائق)
استخدم مصفوفة الغابة ذات الأشجار الـ600 من الجزء 4: [[2420, 11], [431, 12]].
- احسب الضبط والاستدعاء للصنف 1.
- "نموذج" يجيب 0 (سدد) عن كل مقترض اختبار. اكتب مصفوفة الالتباس الخاصة به ودقته.
- أي النموذجين يجد عددا أكبر من المقترضين الذين لم يسددوا؟
التمرين 3: إنتروبيا التقسيم الأول (نحو 5 دقائق)
للمقترضين العشرة في المثال المحلول وللسؤال fico ≤ 677، احسب إنتروبيا الجانب الأيسر (3 لم يسددوا، و1 سدد)، وإنتروبيا الجانب الأيمن (1 لم يسدد، و5 سددوا)، والإنتروبيا الموزونة لهما. إنتروبيا الجذر 0.971.
التمرين 4: في Colab، على القروض (نحو 10 دقائق)
- شغل الدفتر حتى خطوة التقسيم، مع
random_state=101ورابط البيانات أعلاه. - درب
DecisionTreeClassifier(max_depth=5, random_state=101). واطبع مصفوفة الالتباس الخاصة به، ودقته على الاختبار، ودقته على التدريب. - قارنها بالشجرة التي نمت باستخدام
max_depth=Noneفي الجزء 3. - أعد تشغيل الحلقة على عدد الأشجار مع
max_depth=5. ما نطاق الدقة الذي تحصل عليه؟
الإجابات
الإجابة 1
- يضم الجذر 3 لم يسددوا و5 سددوا:
G = 1 - ((3/8)^2 + (5/8)^2) = 1 - (9/64 + 25/64) = 30/64 = 0.4688. - يرسل
fico ≤ 679.5المقترضين P1 وP2 وP3 إلى اليسار (2 لم يسددا، و1 سدد)، والمقترضين من P4 إلى P8 إلى اليمين (1 لم يسدد، وهو P6، و4 سددوا).GL = 1 - ((2/3)^2 + (1/3)^2) = 4/9 = 0.4444GR = 1 - ((1/5)^2 + (4/5)^2) = 8/25 = 0.32Gw = (3/8) * 0.4444 + (5/8) * 0.32 = 0.1667 + 0.2 = 0.3667
- يرسل
int.rate ≤ 0.13015المقترضين P4 وP5 وP7 وP8 إلى اليسار (وكلهم سددوا)، والمقترضين P1 وP2 وP3 وP6 إلى اليمين (3 لم يسددوا، و1 سدد).GL = 0GR = 1 - ((3/4)^2 + (1/4)^2) = 0.375Gw = (4/8) * 0 + (4/8) * 0.375 = 0.1875
- تختار الشجرة
int.rate ≤ 0.13015، لأن 0.1875 أقل من 0.3667. والانخفاض هو0.4688 - 0.1875 = 0.2813. وهو أيضا أفضل العتبات المرشحة الـ14 كلها، وDecisionTreeClassifier(max_depth=1)المدرب على هذه الصفوف الثمانية يطرح هذا السؤال بالضبط، بقيم جيني 0.46875 و0 و0.375.
هذه المرة يفوز سعر الفائدة: فأفضل خاصية تعتمد على الصفوف الموجودة في العقدة.
الإجابة 2
- ضبط الصنف 1:
12 / (11 + 12) = 12 / 23 = 0.52. واستدعاء الصنف 1:12 / (431 + 12) = 12 / 443 = 0.03. - الإجابة "سدد" عن الجميع تعطي:
| التنبؤ 0 | التنبؤ 1 | |
|---|---|---|
| الفعلي 0 | 2431 | 0 |
| الفعلي 1 | 443 | 0 |
دقة هذا النموذج 2431 / 2874 = 0.8459، مقابل 2432 / 2874 = 0.8462 للغابة.
3. تجد الغابة 12 من 443، ولا تجد الإجابة الثابتة أحدا. الفرق بين الدقتين مقترض واحد، وكلا النموذجين شبه عديم الفائدة في العثور على المتعثرين.
الإجابة 3
- اليسار،
p1 = 3/4وp0 = 1/4:H = -(0.75 * log2(0.75) + 0.25 * log2(0.25)) = 0.3113 + 0.5 = 0.8113. - اليمين،
p1 = 1/6وp0 = 5/6:H = -((1/6) * log2(1/6) + (5/6) * log2(5/6)) = 0.4308 + 0.2192 = 0.6500. - الموزونة:
(4/10) * 0.8113 + (6/10) * 0.6500 = 0.3245 + 0.3900 = 0.7145. والانخفاض عن الجذر هو0.971 - 0.7145 = 0.2565.
تعطي scikit-learn مع criterion='entropy' قيم عدم النقاء الثلاث نفسها لهذا التقسيم: 0.971 و0.8113 و0.65.
الإجابة 4
- الشجرة مع
max_depth=5:
| التنبؤ 0 | التنبؤ 1 | |
|---|---|---|
| الفعلي 0 | 2396 | 35 |
| الفعلي 1 | 431 | 12 |
- الدقة على الاختبار
(2396 + 12) / 2874 = 0.8379؛ والدقة على التدريب 0.845. - سجلت الشجرة غير المحدودة 1.0 على التدريب و0.724 على الاختبار. وتقييد العمق يضيق الفجوة بين النتيجتين: فالشجرة الضحلة لم تعد تحفظ مقترضي التدريب. لكنها لا تجد إلا 12 من 443 متعثرا، مثل الغابة.
- مع
max_depth=5، تعطي الحلقة على 5 إلى 100 شجرة دقة بين 0.8434 و0.8459: فالغابات الـ20 كلها تقف عند مستوى الإجابة "سدد" عن الجميع.