

جارٍ تحميل الدرس...
في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 6
صنف المقترض بطرح الأسئلة، ثم دع أشجارا كثيرة تصوت: قروض Lending Club.
DecisionTreeClassifier وRandomForestClassifier على بيانات Lending Clubالأسبوع 6 من الخطة
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | فكرة الشجرة، وشجرة ننميها يدويا | 30 دقيقة |
| 2 | دفتر Lending Club: البيانات والاستكشاف | 15 دقيقة |
| 3 | شجرة قرار واحدة على القروض | 10 دقائق |
| 4 | الغابة العشوائية: يدويا، ثم على القروض | 25 دقيقة |
| 5 | الأخطاء، والمشروع، والتمارين مع الإجابات، والخلاصة | 40 دقيقة |
الجزء 1
اطرح الأسئلة حتى تتضح الإجابة
fico ≤ 677.| المصطلح | في بيانات Lending Club |
|---|---|
الخصائص X | البيانات الائتمانية، مثل fico (درجة الائتمان) وint.rate (سعر الفائدة) |
التسمية (label) y | not.fully.paid: 1 لم يسدد كاملا، و0 سدد كاملا |
| عقدة الجذر | السؤال الأول، ويطرح على كل مقترض |
| الورقة | عقدة بلا سؤال: تتنبأ بصنف الأغلبية فيها |
| العمق (depth) | عدد الأسئلة على أطول مسار إلى ورقة |
يدرب الدفتر باستخدام criterion='gini'
p_0 هي نسبة العقدة في الصنف 0 (سدد)، وp_1 نسبتها في الصنف 1 (لم يسدد)n من الصفوف إلى n_L على اليسار وn_R على اليمينG_L وG_R هما جيني كل جانب؛ ويحسب كل جانب بحسب حجمهيدويا
صفوف من loan_data.csv، مرتبة حسب fico. y = 1: لم يسدد كاملا. أربعة من عشرة لم يسددوا.
| المقترض | fico | int.rate | y |
|---|---|---|---|
| B1 | 647 | 0.1482 | 1 |
| B2 | 662 | 0.1507 | 0 |
| B3 | 667 | 0.1299 | 1 |
| B4 | 672 | 0.1347 | 1 |
| B5 | 682 | 0.1103 | 0 |
| المقترض | fico | int.rate | y |
|---|---|---|---|
| B6 | 687 | 0.1387 | 0 |
| B7 | 692 | 0.1284 | 0 |
| B8 | 707 | 0.1091 | 1 |
| B9 | 727 | 0.1059 | 0 |
| B10 | 757 | 0.1189 | 0 |
المقترضون العشرة كلهم: 6 سددوا، و4 لم يسددوا
677 هو نقطة المنتصف بين B4 (672) وB5 (682)
| الجانب | المقترضون | لم يسدد | سدد |
|---|---|---|---|
نعم، ≤ 677 | من B1 إلى B4 | 3 | 1 |
لا، > 677 | من B5 إلى B10 | 1 (B8) | 5 |
أفضل سؤال على int.rate هو int.rate ≤ 0.12915
| الجانب | المقترضون | لم يسدد | سدد |
|---|---|---|---|
| نعم، أسعار أقل | B5، B7، B8، B9، B10 | 1 | 4 |
| لا، أسعار أعلى | B1، B2، B3، B4، B6 | 3 | 2 |
تسع نقاط منتصف لـfico وتسع لـint.rate: ثمانية عشر سؤالا مرشحا
| عتبة fico | اليسار: لم يسدد، سدد | اليمين: لم يسدد، سدد | جيني الموزون |
|---|---|---|---|
| 654.5 | 1, 0 | 3, 6 | 0.4000 |
| 669.5 | 2, 1 | 2, 5 | 0.4190 |
| 677 | 3, 1 | 1, 5 | 0.3167 |
| 684.5 | 3, 2 | 1, 4 | 0.4000 |
| 717 | 4, 4 | 0, 2 | 0.4000 |
من B1 إلى B4: 3 لم يسددوا، و1 سدد، G = 0.375
من B5 إلى B10: 1 لم يسدد (B8)، و5 سددوا، G = 0.2778
fico <= 677 ?
|-- yes: int.rate <= 0.14945 ?
|        |-- yes: leaf [3 not paid, 0 paid] -> not paid
|        |-- no:  leaf [0 not paid, 1 paid] -> paid
|-- no:  int.rate <= 0.1097 ?
         |-- yes: leaf [1 not paid, 1 paid] -> paid
|-- no: leaf [0 not paid, 4 paid] -> paidاتبع الأسئلة من الجذر
670 ≤ 677 نعم، ثم 0.14 ≤ 0.14945 نعم، إذن تقول الورقة لم يسدد700 ≤ 677 لا، ثم 0.12 ≤ 0.1097 لا، إذن تقول الورقة سددالجزء 2
9578 قرضا حقيقيا، من 2007 إلى 2010
https://colab.research.google.com/github/
tirthajyoti/Machine-Learning-with-Python/blob/
master/Classification/
DecisionTrees_RandomForest_Classification.ipynbimport pandas as pd
url = ("https://raw.githubusercontent.com/"
"tirthajyoti/Machine-Learning-with-Python/"
"master/Datasets/loan_data.csv")
df = pd.read_csv(url)
df.info()fico: درجة الائتمان؛ وint.rate: سعر الفائدة في صورة نسبةpurpose: الغرض من القرض، في صورة نصnot.fully.paid: 1 إذا لم يسدد المقترض كاملاprint(df['not.fully.paid'].value_counts())| not.fully.paid | المقترضون | النسبة |
|---|---|---|
| 0، سدد | 8045 | 84% |
| 1، لم يسدد | 1533 | 16% |
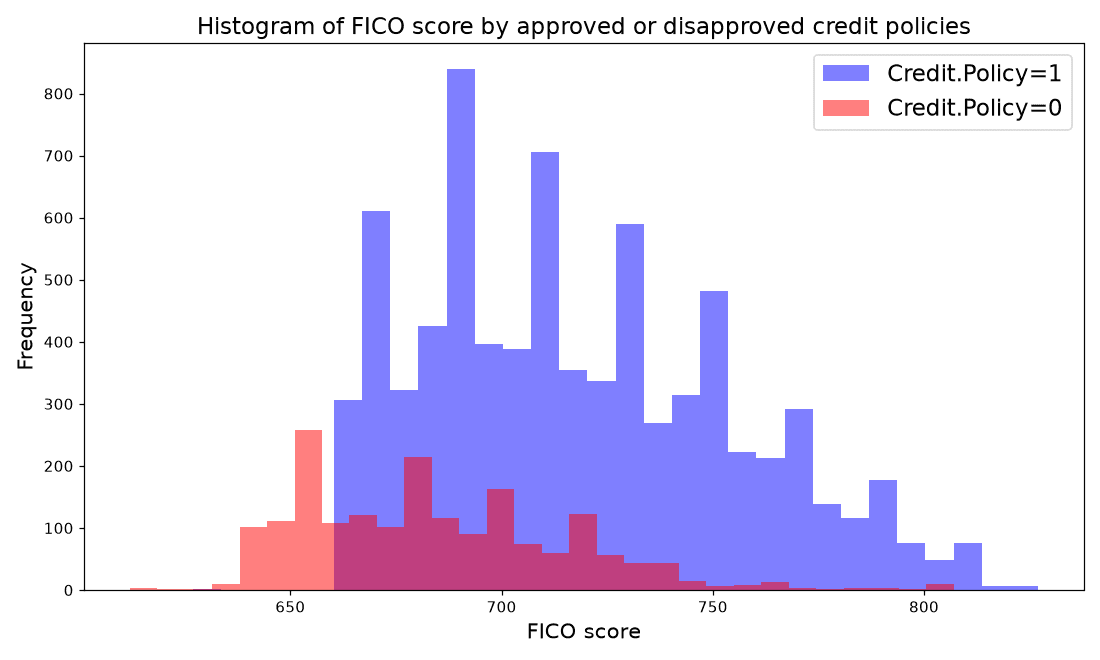
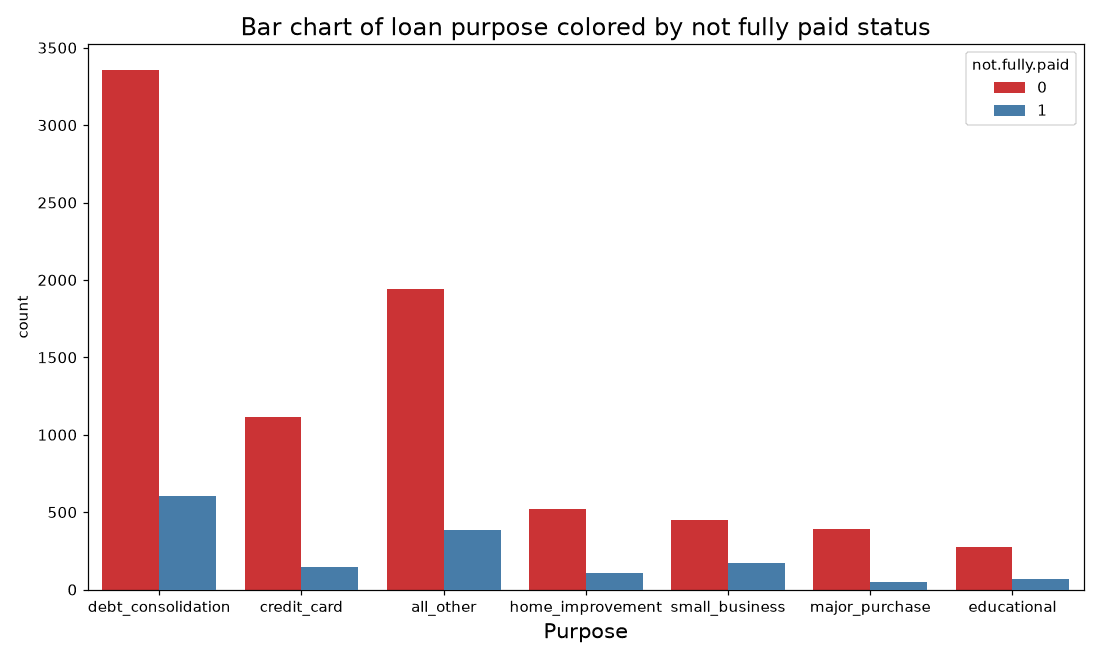
fico 660: لا يستوفي 487 مقترضا سياسة الائتمان، ويستوفيها 2 فقط. فعتبة واحدة تفصل مجموعةsmall_business، و11.6% من قروض credit_carddf_final = pd.get_dummies(df, ['purpose'],
drop_first=True)purpose_credit_carddrop_first=True الغرض all_other: فالقيمة 0 في الأعمدة الستة كلها تعني هذا الغرضdf_final 19 عموداX = df_final.drop('not.fully.paid', axis=1)
y = df_final['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.30, random_state=101)الجزء 3
دع الشجرة تنمو حتى تصبح كل ورقة نقية
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(criterion='gini', max_depth=None,
                               random_state=101)
dtree.fit(X_train, y_train)
predictions = dtree.predict(X_test)criterion='gini': عدم النقاء الذي رأيناه في الجزء 1max_depth=None: استمر في التقسيم حتى تصبح كل ورقة نقيةrandom_state=101: تكسر حالات التعادل بين التقسيمات المتساوية في الجودة بالطريقة نفسها في كل تشغيلA: الدقة. وR_1 وP_1: الاستدعاء (recall) والضبط (precision) للصنف 1
| التنبؤ 0 (سدد) | التنبؤ 1 (لم يسدد) | |
|---|---|---|
| الفعلي 0 | 1975 | 456 |
| الفعلي 1 | 336 | 107 |
print(dtree.get_depth(), dtree.get_n_leaves())
print(dtree.score(X_train, y_train))| المقياس | القيمة |
|---|---|
| العمق | 27 |
| الأوراق | 1005 |
| الدقة على التدريب | 1.0 |
الجزء 4
أشجار كثيرة مختلفة، وتصويت واحد
n من الصفوف مسحوبة عشوائيا مع الإرجاع (with replacement) من صفوف التدريب البالغ عددها nm من الخصائص البالغ عددها p، حيث m = ⌊√p⌋يدويا
RandomForestClassifier(n_estimators=5, random_state=0) على المقترضين العشرة. ومع p = 2 يبحث كل تقسيم في خاصية عشوائية واحدة، m = 1
المقترض الجديد: fico 710، int.rate 0.11
| الشجرة | خارج عينتها | الصوت |
|---|---|---|
| 1 | B2، B5، B6، B9 | لم يسدد |
| 2 | B3، B6، B7 | سدد |
| 3 | B1، B3، B7، B10 | سدد |
| 4 | B2، B3، B7، B8، B10 | سدد |
| 5 | B1، B3، B5، B9 | لم يسدد |
from sklearn.ensemble import RandomForestClassifier

rfc = RandomForestClassifier(n_estimators=600, random_state=101)
rfc.fit(X_train, y_train)
rfc_pred = rfc.predict(X_test)
print(confusion_matrix(y_test, rfc_pred))
print(classification_report(y_test, rfc_pred))p = 18 يبحث كل تقسيم في m = 4 من الخصائص: فالأمر rfc.estimators_[0].max_features_ يطبع 4.A: الدقة على مقترضي الاختبار الـ2874
| التنبؤ 0 (سدد) | التنبؤ 1 (لم يسدد) | |
|---|---|---|
| الفعلي 0 | 2420 | 11 |
| الفعلي 1 | 431 | 12 |
A_0: دقة الإجابة "سدد" عن الجميع. وR_1: استدعاء الصنف 1
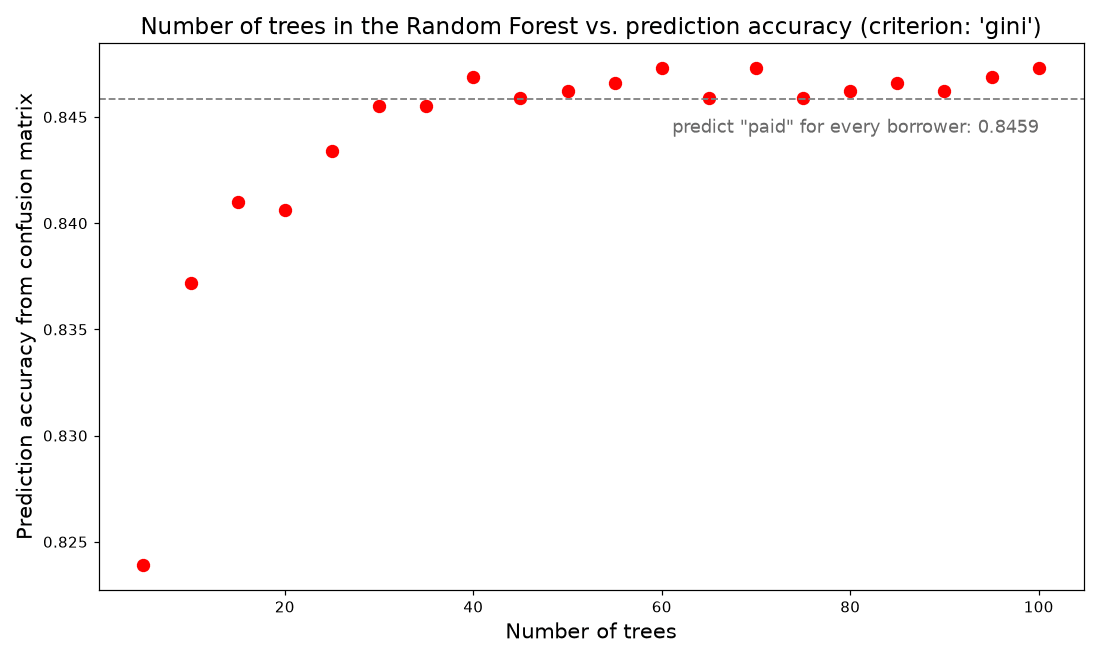
min_samples_split=10، ونضيف random_state=101 لكل غابةقبل التمارين
loan_data.csv في Colab من مجلد لا يحتويهrandom_state، ثم مقارنة أرقام من تقسيمين مختلفينmax_depth=Nonepredictions وأنت تقصد rfc_predpurpose دون متغيرات وهمية (dummy variables)مشروع فريقك
random_stateDecisionTreeClassifier: وقارن نتيجته على التدريب بنتيجته على الاختبارRandomForestClassifier: واعرض مصفوفة الالتباس (confusion matrix) وclassification_reportالجزء 5
نحو 30 دقيقة، والإجابات تلي كل مهمة
نحو 10 دقائق
ثمانية مقترضين حقيقيين آخرين، y = 1: لم يسدد
| المقترض | fico | int.rate | y |
|---|---|---|---|
| P1 | 647 | 0.1482 | 1 |
| P2 | 667 | 0.1343 | 0 |
| P3 | 677 | 0.1734 | 1 |
| P4 | 682 | 0.1197 | 0 |
| المقترض | fico | int.rate | y |
|---|---|---|---|
| P5 | 692 | 0.1287 | 0 |
| P6 | 697 | 0.1316 | 1 |
| P7 | 742 | 0.1114 | 0 |
| P8 | 747 | 0.0751 | 0 |
G_w للسؤال fico ≤ 679.5 وللسؤال int.rate ≤ 0.13015الإجابات
| السؤال | جيني الموزون |
|---|---|
fico ≤ 679.5 | G_w = 0.375 × 0.4444 + 0.625 × 0.32 ≈ 0.3667 |
int.rate ≤ 0.13015 | G_w = 0.5 × 0 + 0.5 × 0.375 = 0.1875 |
نحو 5 دقائق
الغابة ذات الأشجار الـ600: [[2420, 11], [431, 12]]
نحو 5 دقائق
يدرب الدفتر أيضا باستخدام criterion='entropy'، أي الإنتروبيا (entropy)
نحو 10 دقائق
random_state=101، درب DecisionTreeClassifier(max_depth=5, random_state=101)max_depth=Nonemax_depth=5 وrandom_state=101 في كل غابة| الشجرة | مصفوفة الالتباس | الاختبار | التدريب |
|---|---|---|---|
max_depth=5 | [[2396, 35], [431, 12]] | 0.8379 | 0.845 |
max_depth=None | [[1975, 456], [336, 107]] | 0.724 | 1.0 |
Mahmoud Abas|أشجار القرار والغابة العشوائية