

جارٍ تحميل الدرس...
في نافذة الطباعة اختر «حفظ كملف PDF» كوجهة.
تعلم الآلة، الأسبوع 7
حول أعداد الكلمات إلى احتمالات بنظرية بايز، ثم ابن مرشحا للرسائل المزعجة ومصنفا للنبيذ باستخدام scikit-learn.
MultinomialNB وCountVectorizer، وتقييمهGaussianNB على خصائص (features) عددية: بيانات النبيذالأسبوع 7 من الخطة
| الجزء | ما نفعله | الزمن |
|---|---|---|
| 1 | نظرية بايز، وكلمة واحدة يدويا | 20 دقيقة |
| 2 | Naive Bayes يدويا، والتنعيم | 30 دقيقة |
| 3 | الدفتر 1: مرشح الرسائل المزعجة | 20 دقيقة |
| 4 | الدفتر 2: Naive Bayes الغاوسي على النبيذ | 20 دقيقة |
| 5 | تمارين مع الإجابات، ثم الخلاصة | 30 دقيقة |
الجزء 1
الاحتمال الشرطي (conditional probability) P(A | B): احتمال A، بشرط أن يكون B صحيحا. لصنف (class) c ودليل x:
| الجزء | الرمز | المعنى |
|---|---|---|
| الاحتمال المسبق | P(c) | مدى شيوع الصنف، قبل النظر في الرسالة |
| الأرجحية | P(x | c) | مدى شيوع الدليل داخل الصنف |
| الدليل | P(x) | مدى شيوع الدليل عموما |
| الاحتمال اللاحق | P(c | x) | احتمال الصنف بعد رؤية الدليل |
يدويا
999 رسالة. S مزعجة، وH سليمة، وm: الرسالة تحتوي على money
| الصنف | الرسائل | تحتوي على money |
|---|---|---|
مزعجة S | 500 | 79 |
سليمة H | 499 | 25 |
| الكل | 999 | 104 |
الجزء 2
في الرسالة كلمات كثيرة x_1, ..., x_n
s(c) لكل صنف cpredict_proba| الرمز | المعنى |
|---|---|
n_wc | عدد مرات ظهور الكلمة w في رسائل التدريب من الصنف c |
N_c | مجموع أعداد كل كلمات المفردات (vocabulary) في الصنف c |
V | عدد الكلمات في المفردات |
α | التنعيم، والقيمة الافتراضية alpha=1.0 في MultinomialNB() |
يدويا
أعداد حقيقية في الرسائل الـ999. الاحتمالان المسبقان P(H) = 0.4995 وP(S) = 0.5005، وV = 4 وα = 1
| الكلمة | العدد في السليمة | العدد في المزعجة |
|---|---|---|
money | 38 | 155 |
online | 7 | 94 |
meeting | 153 | 1 |
meds | 0 | 30 |
المجموع N_c | 198 | 280 |
المفردات: money وonline وmeeting وmeds
o = online، وd = meds. المقامان: 198 + 4 = 202 للسليمة، و280 + 4 = 284 للمزعجة
s(c) = P(c) مضروبا في احتمالات الكلمات
e = الرسالة
رسالة جديدة e: Money for the meeting? The meeting is about meds. الأعداد: m = money 1، وg = meeting 2، وd = meds 1
α = 1: يضاف واحد إلى كل عدد، فلا يكون أي احتمال 0 أبدا
الجزء 3
https://colab.research.google.com/github/
jeffprosise/Machine-Learning/blob/master/
E-Mail%20Classification.ipynburl = ("https://raw.githubusercontent.com/"
"jeffprosise/Machine-Learning/master/Data/ham-spam.csv")
df = pd.read_csv(url)df.info()
df.groupby('IsSpam').describe()
df = df.drop_duplicates()
df.groupby('IsSpam').describe()IsSpam (0 سليمة، و1 مزعجة) وTextdrop_duplicates(): 999 صفا، منها 499 سليمة و500 مزعجةfrom sklearn.feature_extraction.text import CountVectorizer
vectorizer = CountVectorizer(
ngram_range=(1, 2), stop_words='english')
x = vectorizer.fit_transform(df['Text'])
y = df['IsSpam']ngram_range=(1, 2): الكلمات المفردة والأزواج مثل order onlinestop_words='english': تحذف كلمات التوقف (stop words) مثل the وfor وyou...x.shape هي (999, 100687): 100687 عموداtext = vectorizer.transform(['Why pay MORE for * expensive meds when you can ...123... order them online and save $$$?'])
print(vectorizer.inverse_transform(text))[array(['expensive', 'meds', 'online', 'order', 'order online', 'pay',
'save'], dtype='<U401')]from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(
x, y, test_size=0.2, random_state=0)
from sklearn.naive_bayes import MultinomialNB
model = MultinomialNB()
model.fit(x_train, y_train)fit يعد فقط: الاحتمالات المسبقة، وP(w | c) بعد التنعيم لكل عمود من الأعمدة الـ100687بقيت 101 من 102 رسالة سليمة، وكشف المرشح 95 من 98 رسالة مزعجة
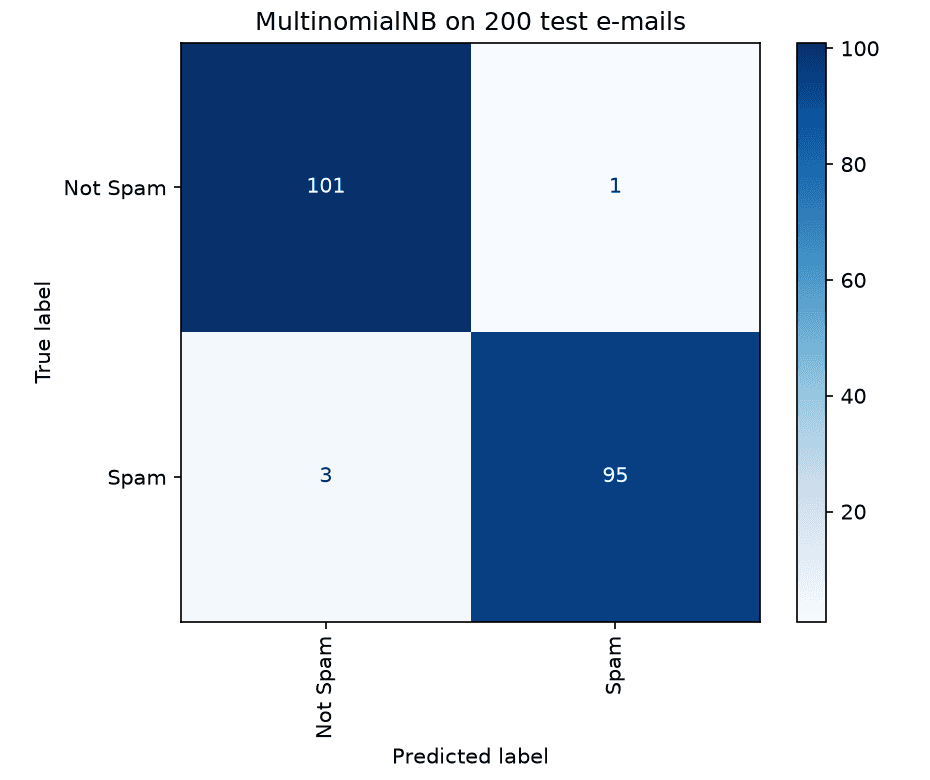
from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_estimator(
    model, x_test, y_test,
    display_labels=['Not Spam', 'Spam'],
cmap='Blues', xticks_rotation='vertical')A الدقة (accuracy)، وP الضبط (precision)، وR الاستدعاء (recall) للرسائل المزعجة
message = vectorizer.transform(['Can you attend a code review on Tuesday? Need to make sure the logic is rock solid.'])
model.predict(message)[0]
model.predict_proba(message)[0][0]

message = vectorizer.transform(['Why pay more for expensive meds when you can order them online and save $$$?'])
model.predict(message)[0]
model.predict_proba(message)[0][1]| الرسالة | predict | الاحتمال المعروض |
|---|---|---|
| رسالة مراجعة الكود | 0 (سليمة) | P(H) = 0.99992 |
| رسالة الأدوية الغالية | 1 (مزعجة) | P(S) = 0.99979 |
الجزء 4
178 عينة نبيذ، و3 سلالات (Class 1 و2 و3: 59 و71 و48 عينة)، و13 خاصية عددية مثل Alcohol وFlavanoids وProline
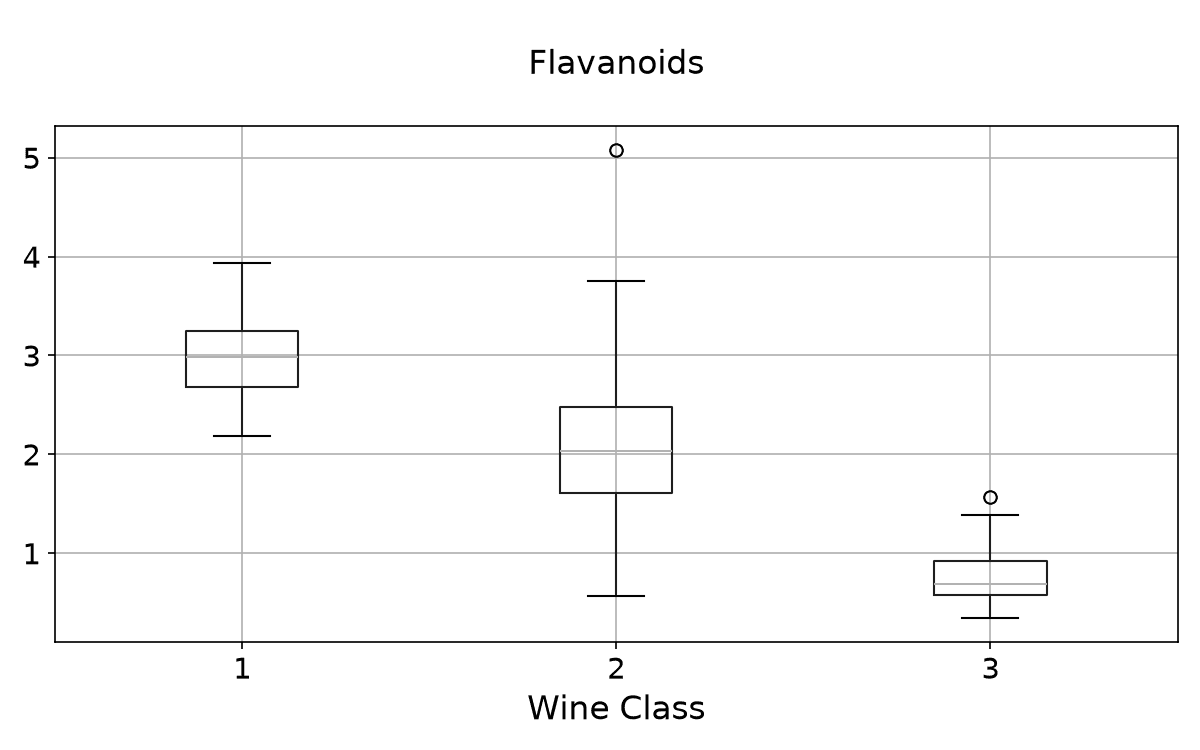
url = ("https://raw.githubusercontent.com/tirthajyoti/"
       "Machine-Learning-with-Python/master/"
       "Datasets/wine.data.csv")
df = pd.read_csv(url)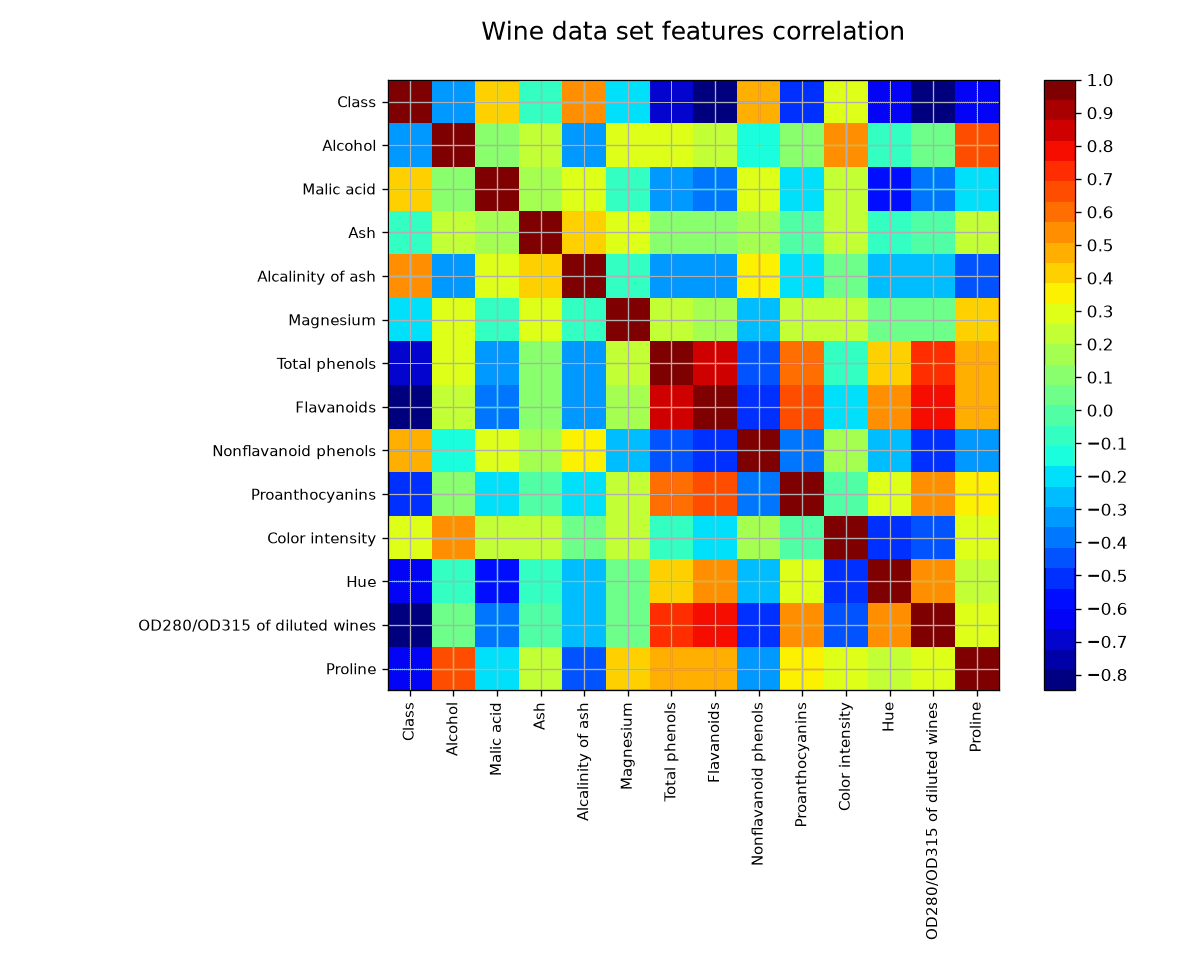
Flavanoids مقابل Total phenols: الارتباط (correlation) 0.86Flavanoids مقابل OD280/OD315: 0.79داخل كل صنف، يفترض أن الخاصية تتبع منحنى جرسيا
| الرمز | المعنى |
|---|---|
μ_c | متوسط (mean) الخاصية في الصنف c |
σ_c | الانحراف المعياري (standard deviation) للخاصية في الصنف c |
f(x | c) | ارتفاع المنحنى عند x: الأرجحية |
يدويا
Flavanoids على عينات النبيذ الـ178 كلها
| الصنف | العينات | المتوسط μ | الانحراف المعياري σ |
|---|---|---|---|
| 1 | 59 | 2.982 | 0.394 |
| 2 | 71 | 2.081 | 0.701 |
| 3 | 48 | 0.781 | 0.290 |
الأس: -(x - μ)^2 / (2σ^2) مع x = 2.0
اضرب e مرفوعا إلى الأس في 1 / √(2πσ²) لتحصل على الكثافة (density)
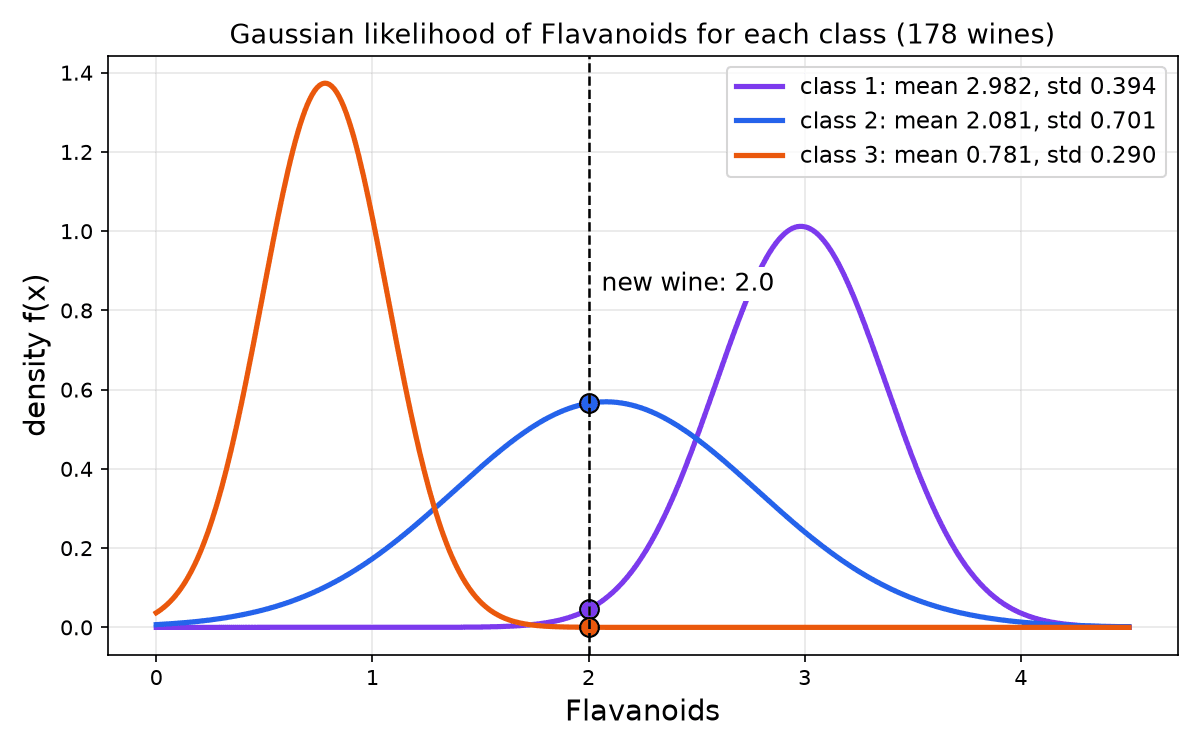
الاحتمالات المسبقة: 59/178 و71/178 و48/178
| الصنف | f(x | c) | P(c) | الاحتمال اللاحق |
|---|---|---|---|
| 1 | 0.0453 | 0.3315 | 0.0625 |
| 2 | 0.5653 | 0.3989 | 0.9373 |
| 3 | 0.000200 | 0.2697 | 0.0002 |
X = df.drop('Class', axis=1)
y = df['Class']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=0)

nbc = GaussianNB()
nbc.fit(X_train, y_train)
y_pred = nbc.predict(X_test)| التنبؤ 1 | التنبؤ 2 | التنبؤ 3 | |
|---|---|---|---|
| الحقيقي 1 | 19 | 0 | 0 |
| الحقيقي 2 | 2 | 19 | 1 |
| الحقيقي 3 | 0 | 0 | 13 |
يطبع الدفتر classification_report(y_pred, y_test)
| الصيغة | الضبط | الاستدعاء | support |
|---|---|---|---|
(y_pred, y_test) | 0.86 | 1.00 | 19 |
(y_test, y_pred) | 1.00 | 0.86 | 22 |
قبل التمارين
plot_confusion_matrix: استخدم بدلا منها ConfusionMatrixDisplay.from_estimatoralpha=0: كلمة واحدة لم تظهر في صنف ما تجعل احتماله 0 تماماfit_transform على الرسائل الجديدة: النص الجديد يحتاج إلى vectorizer.transform([...])classification_report: التسميات الحقيقية أولاMultinomialNB على القياسات: أعداد الكلمات إلى Multinomial، والقياسات العددية إلى Gaussianمشروع فريقك
MultinomialNB لأعداد الكلمات، وGaussianNB للخصائص العدديةrandom_stateclassification_report (التسميات الحقيقية أولا)الجزء 5
نحو 5 دقائق
| الكلمة | الرسائل المزعجة (من 500) | الرسائل السليمة (من 499) |
|---|---|---|
click | 50 | 6 |
meeting | 1 | 89 |
نحو 10 دقائق
الرسالة e: Make money online, no meeting needed
الإجابات
نحو 5 دقائق
| الصنف | f(x | c) | P(c) | الدرجة |
|---|---|---|---|
| 1 | 0.4791 | 0.3315 | 0.1588 |
| 2 | 0.4760 | 0.3989 | 0.1899 |
نحو 10 دقائق
predict مرة واحدة وpredict_proba مرة واحدة: رسالة مراجعة الكود، ورسالة الأدوية الغالية، وMake money online, no meeting neededinverse_transformrandom_state بالقيمة 1، ثم 42. كم عينة نبيذ تصنف خطأ؟| السؤال | الناتج |
|---|---|
predict على الدفعة | [0 1 1]، والثالثة: P(S) = 0.7002 |
| كلمات الرسالة الثالثة | make وmake money وmeeting وmoney وneeded وonline |
random_state=1 / 42 | 1 و0 من 54 صنفت خطأ |
alpha=1) كلمة واحدة لم تظهر في صنف ما من فرض القيمة 0MultinomialNB لأعداد الكلمات، وGaussianNB للخصائص العدديةMahmoud Abas|التصنيف بخوارزمية Naive Bayes